taiwan-exams-results
收藏资源简介:
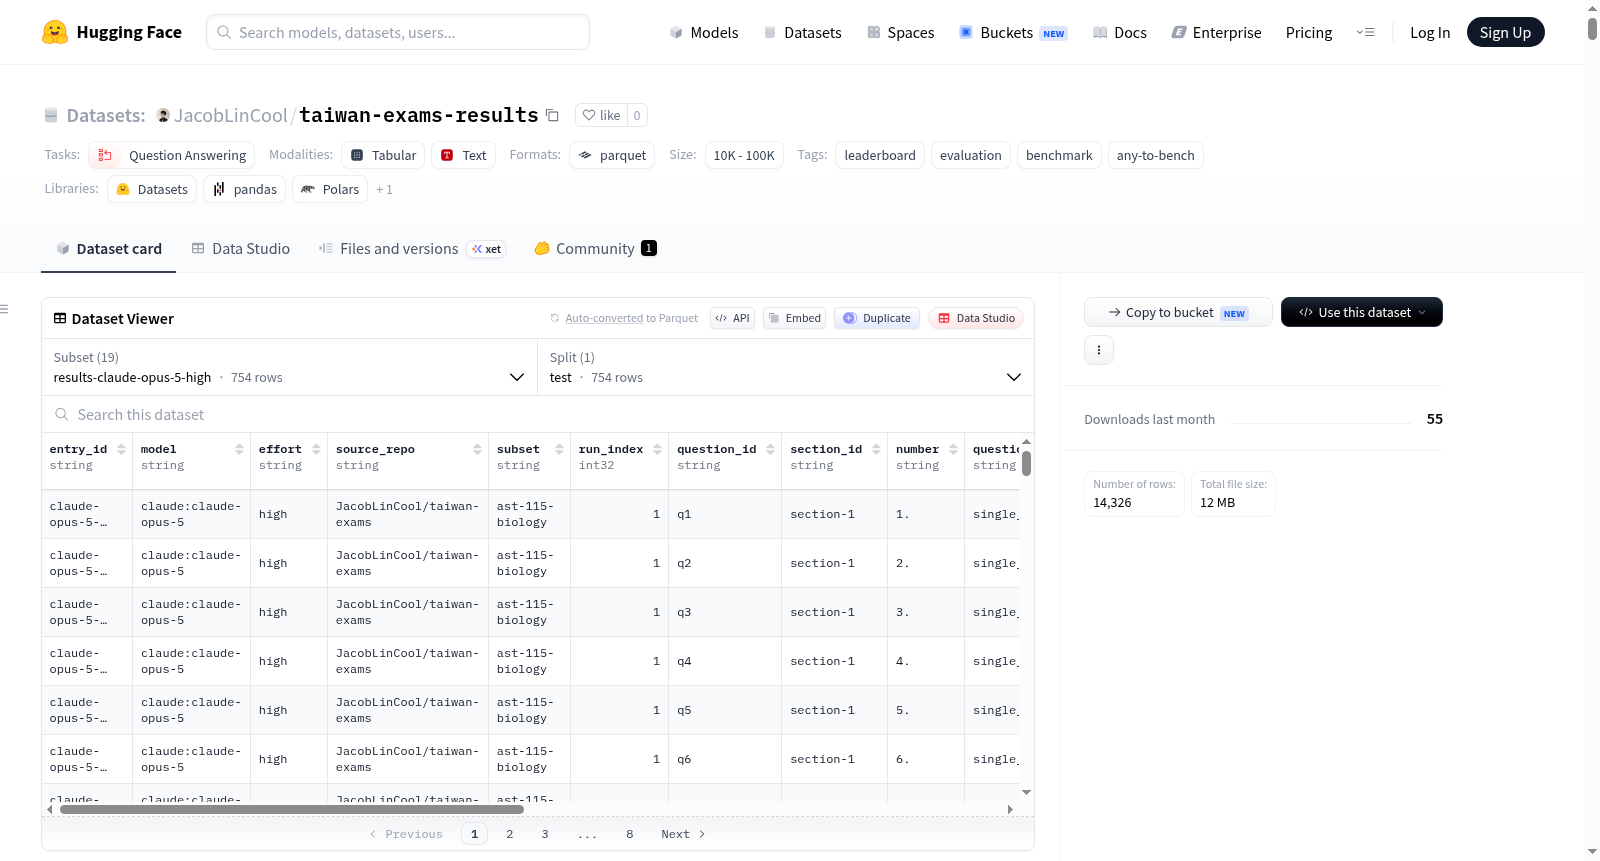
该数据集是any-to-bench基准测试工具生成的评估结果,用于衡量不同语言模型在台湾考试(taiwan-exams)上的表现。数据集包含多个配置,每个配置代表一个特定的模型(如Claude Opus 5、Claude Sonnet 5、GPT-5.6 Sol、GPT-5.6 Luna)在特定推理努力水平(低、中、高、极高)下的表现。每个配置包含754个测试样本,涵盖21份试卷,字段包括条目ID、模型名称、努力水平、源仓库、子集、运行索引、问题ID、章节ID、题号、问题类型、规则类型、模式、最高分、得分、比例、评判结果、评判分布以及详细JSON信息。数据集的用途是作为排行榜,方便比较不同模型和推理策略在台湾考试上的表现。
This dataset is the evaluation results generated by the any-to-bench benchmarking tool, used to measure the performance of different language models on Taiwan exams (taiwan-exams). The dataset contains multiple configurations, each representing a specific model (e.g., Claude Opus 5, Claude Sonnet 5, GPT-5.6 Sol, GPT-5.6 Luna) under a specific reasoning effort level (low, medium, high, very high). Each configuration includes 754 test samples covering 21 exam papers, with fields including entry ID, model name, effort level, source repository, subset, run index, question ID, chapter ID, question number, question type, rule type, mode, maximum score, score, ratio, judgment result, judgment distribution, and detailed JSON information. The purpose of the dataset is to serve as a leaderboard, facilitating comparison of different models and reasoning strategies on Taiwan exams.
数据集概述:taiwan-exams-results
基本信息
- 数据集名称:any-to-bench results — taiwan-exams-results
- 任务类型:问答(question-answering)
- 标签:leaderboard、evaluation、benchmark、any-to-bench
- 数据集地址:https://huggingface.co/datasets/JacobLinCool/taiwan-exams-results
内容简介
该数据集是由 any-to-bench 工具生成的基准测试结果。每个子集代表一个“参赛者配置”,即某个模型在特定推理努力水平下,针对台湾考试(taiwan-exams)的答题结果。数据集中包含多个模型的评测记录,每个条目都详细记录了模型在每一道题目上的得分情况。
数据集结构
配置(Configs)
数据集包含 19 个子配置,每个配置对应一种模型与推理努力水平的组合,具体如下:
Claude 系列(8 个配置)
results-claude-opus-5-high/results-claude-opus-5-low/results-claude-opus-5-medium/results-claude-opus-5-xhighresults-claude-sonnet-5-high/results-claude-sonnet-5-low/results-claude-sonnet-5-medium/results-claude-sonnet-5-xhigh
Codex GPT 系列(8 个配置)
results-codex-gpt-5-6-luna-high/results-codex-gpt-5-6-luna-low/results-codex-gpt-5-6-luna-medium/results-codex-gpt-5-6-luna-xhighresults-codex-gpt-5-6-sol-high/results-codex-gpt-5-6-sol-low/results-codex-gpt-5-6-sol-medium/results-codex-gpt-5-6-sol-xhigh
Gemini 系列(3 个配置)
results-google-cloud-gemini-3-7-flash-high/results-google-cloud-gemini-3-7-flash-low/results-google-cloud-gemini-3-7-flash-medium
数据划分
每个配置均包含一个 test 划分,包含 754 个样本(样本数为逐题评分记录)。
特征字段
所有配置共用以下 18 个字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
entry_id |
string | 条目标识 |
model |
string | 模型名称 |
effort |
string | 推理努力水平 |
source_repo |
string | 来源仓库 |
subset |
string | 子集名称 |
run_index |
int32 | 运行索引 |
question_id |
string | 题目 ID |
section_id |
string | 部分 ID |
number |
string | 题号 |
question_type |
string | 题目类型 |
rule_kind |
string | 规则类型 |
mode |
string | 模式 |
max_points |
float64 | 满分 |
awarded |
float64 | 得分 |
ratio |
float64 | 得分比例 |
judge_verdicts |
int32 | 评判判定次数 |
judge_spread |
float64 | 评判分数分布 |
detail_json |
string | 详细评分信息(JSON) |
数据规模(各配置示例)
results-claude-opus-5-high:下载大小 15,338 字节,数据集大小 251,009 字节results-google-cloud-gemini-3-7-flash-medium:下载大小 15,517 字节,数据集大小 272,825 字节
使用方式
Python 加载示例
python from datasets import load_dataset ds = load_dataset("JacobLinCool/taiwan-exams-results", "results-<entry>", split="test")
数据文件说明
results-index.json:目录文件,每个配置的概览信息results-<entry>/entry.json:该配置的逐卷(per-paper)得分results-<entry>/raw/<subset>/:包含完整的bench.json、答题卡和评分报告- 查看器表格:每个已评分题目一行
补充说明
- 数据集的评审结果 依赖评审模型,每个条目会标注使用的评审模型名称
- 该数据集可作为排行榜使用,可在线浏览:https://jacoblincool.github.io/any-to-bench/results.html?repo=JacobLinCool/taiwan-exams-results