
遇见数据集

ovos-wake-word-bench-mlsw-negatives-it-IT

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

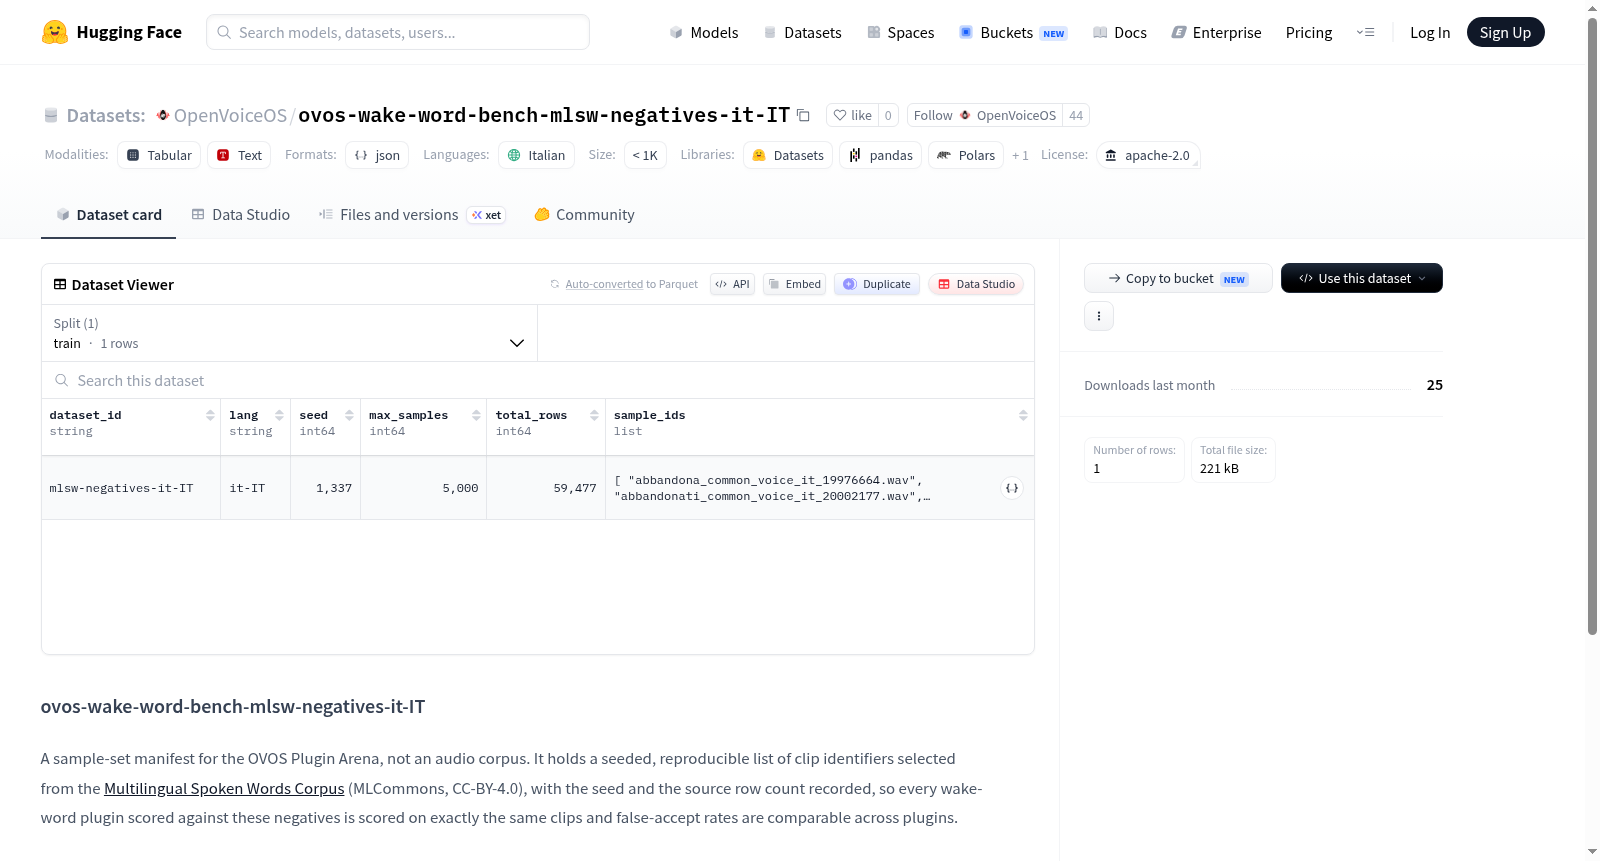
该数据集是OVOS唤醒词基准测试(OVOS Plugin Arena)的负样本集合清单(manifest),专门用于评估意大利语唤醒词插件。它并非音频语料库,而是一个可重现的clip标识符列表,这些标识符选自MLCommons的多语言口语词汇语料库(Multilingual Spoken Words Corpus,CC-BY-4.0许可)。清单中记录了用于选择的随机种子和源数据集行数,确保所有插件在完全相同的负样本上进行评分,从而使得不同插件间的误接受率(false-accept rate)具有可比性。音频文件本身不包含在此数据集中,用户需从原始语料库中获取。该数据集适用于唤醒词检测系统的性能评估,特别是针对误接受率的标准化测试。

This dataset is a manifest of negative samples for the OVOS wake word benchmark (OVOS Plugin Arena), specifically designed to evaluate Italian wake word plugins. It is not an audio corpus, but a reproducible list of clip identifiers selected from the MLCommons Multilingual Spoken Words Corpus (CC-BY-4.0 license). The manifest records the random seed used for selection and the number of source dataset rows, ensuring that all plugins are scored on exactly the same negative samples, making the false-accept rates comparable across different plugins. The audio files themselves are not included in this dataset; users need to obtain them from the original corpus. This dataset is suitable for performance evaluation of wake word detection systems, particularly for standardized testing of false-accept rates.

创建时间:
2026-09-02
原始信息汇总

ovos-wake-word-bench-mlsw-negatives-it-IT 数据集总结

基本信息

  • 许可证: Apache-2.0
  • 语言: 意大利语(it)
  • 数据集提供方: OpenVoiceOS

数据集本质

该数据集并非音频语料库,而是一个用于 OVOS Plugin Arena样本集清单(manifest)。它存储了一系列可复现的、由固定随机种子生成的剪辑标识符(clip identifiers)列表。

数据来源

  • 选取自 Multilingual Spoken Words Corpus(MLCommons,许可证为 CC-BY-4.0)
  • 数据集中记录了随机种子和源数据行数,确保每个唤醒词插件在测试时使用完全相同的音频剪辑,从而保证不同插件之间的误接受率(false-accept rates)具有可比性

音频说明

  • 音频文件并未在此数据集中重新分发,其版权归 MLCommons 所有,需遵循其自身的许可证和归属条款

用途

  • 用于基准测试(benchmark),作为唤醒词插件的负样本(negatives),在 OVOS Plugin Arena 中参与评分对比

相关资源

  • 基准测试结果页: https://openvoiceos.github.io/ovos-plugin-arena/
  • Manifest 格式规范文档: 位于 https://github.com/OpenVoiceOS/ovos-plugin-arena 仓库中的 docs/SPECIFICATION.md
搜集汇总
数据集介绍
ovos-wake-word-bench-mlsw-negatives-it-IT 数据集图片
构建方式
本数据集并非直接收录原始音频的语料库,而是一份精心设计的样本集清单,专为OVOS插件竞技场量身打造。其构建逻辑基于对MLCommons发布的多语种口语词语语料库的系统性筛选,通过设定固定的随机种子,从源数据中选取确定数量的音频片段标识符,确保每次评测所依据的负面样本完全一致。该清单明确记录了随机种子与源数据行数,作为可复现的评测基准,所有音频文件仍保留在MLCommons原始资源库中,遵守其CC-BY-4.0许可及归属条款。清单本身以Apache-2.0协议发布,与竞技场其他基准资源保持规范一致。
特点
该数据集的核心特质在于其作为标准化评测基准的严谨性与可比性。通过固定种子生成的随机但确定的样本集,彻底消除了不同唤醒词插件在测试时因样本差异而产生的偏差,使假阳性率(false-accept rate)的跨插件比较成为可能。其清单格式遵循竞技场规范文档,便于自动化解析与集成。尤为独特的是,它不直接分发音频,规避了大型音频文件存储与传输的负担,同时尊重了上游语料的版权与归属,体现了开放科学中模块化与合规性的双重考量。
使用方法
此数据集的典型应用场景是作为负样本基准,用于统一评测各类唤醒词插件的性能。研究人员或开发者可依据清单中的片段标识符,从MLCommons语料库中提取对应音频,将其接入OVOS插件竞技场流程,对特定唤醒词插件进行假阳性率测试。评测结果可提交至公开榜单,与其他插件进行横向对比。鉴于清单的确定性,任何时间、任何地点复现该测试均能得到一致结果,从而为插件优化提供客观数据支撑。具体规格与集成方式详见竞技场官方文档及GitHub仓库中的规范说明。
背景与挑战
背景概述
该数据集由OpenVoiceOS社区创建,用于支持OVOS插件竞技场中唤醒词插件的标准化评估。其核心研究问题在于为意大利语提供一组可复现的负样本集,以衡量不同唤醒词插件的误唤醒率。数据集基于MLCommons多语种口语词汇语料库(CC-BY-4.0),通过固定随机种子进行可复现采样,生成清单文件而非直接分发音频,从而在保持与原始语料库授权一致性同时,确保基准测试的公平性与可比性。该工作对开源语音助手生态的插件评测标准化具有推动作用,其发布格式与结果公开于相关项目页面,促进领域内社区协作与模型迭代。
当前挑战
该数据集主要面临两方面挑战。在领域问题上,智能语音助手需在嘈杂环境或非目标语音中保持低误唤醒率,而传统唤醒词测试常因样本不一致导致插件性能难以横向比较。本数据集通过固定种子与原始语料库索引解决问题,但构建过程中面临保障样本的代表性与覆盖度、记录并维护大量音频标识符的完整性、以及在Apache-2.0与CC-BY-4.0授权下合理管理元数据与原始音频分离的合规性等挑战。
常用场景
经典使用场景
该数据集作为语音唤醒词插件基准测试的核心负样本清单,在智能语音交互领域具有举足轻重的地位。它并非直接提供音频资源,而是精心策划了一组可复现的剪辑标识符,源自Multilingual Spoken Words Corpus(多语种口语词库),专为意大利语环境设计。研究者和开发者利用该清单,对各类唤醒词插件进行标准化的误唤醒率评估,确保在完全相同的音频样本集上比较不同算法的性能。这一设计规避了因音频内容差异而导致的公平性偏差,使得评测结果具有高度的可比性和可靠性,成为衡量唤醒词引擎抗干扰能力的重要标尺。
实际应用
在实际应用中,该数据集主要服务于智能家居、车载系统、可穿戴设备等产品中唤醒词引擎的选型与优化。设备制造商和语音技术提供商在集成特定唤醒词(如“你好,小欧”)时,需要确保其在嘈杂环境或随机语音中不会频繁误触发。借助此负面样本清单,企业的测试团队能够高效地模拟真实场景中非目标语音的干扰,批量评估不同插件在意大利语环境下的鲁棒性。最终,这有助于筛选出误唤醒率最低、用户体验最佳的解决方案,为产品的本地化部署提供了坚实的数据支撑,并极大缩短了质量验证的周期。
衍生相关工作
该数据集衍生并催生了一系列关于唤醒词评测框架与插件兼容层的研究工作。其背后的OVOS Plugin Arena项目本身就是一项开创性成果,定义了统一的插件接口规范和评测协议,而这份负样本清单是该框架中最核心的基准资源之一。在此基础上,衍生工作方向包括开发更精细化的误唤醒错误分析工具、探索针对多语言环境的负样本均衡策略,以及引入主动学习机制动态生成更具挑战性的负样本集。此外,该数据集的存在也激励了学术界对于唤醒词评测指标的标准化讨论,并启发了其他语音任务(如命令词识别)构建类似可复现基准的实践。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

