UnicBench
收藏资源简介:
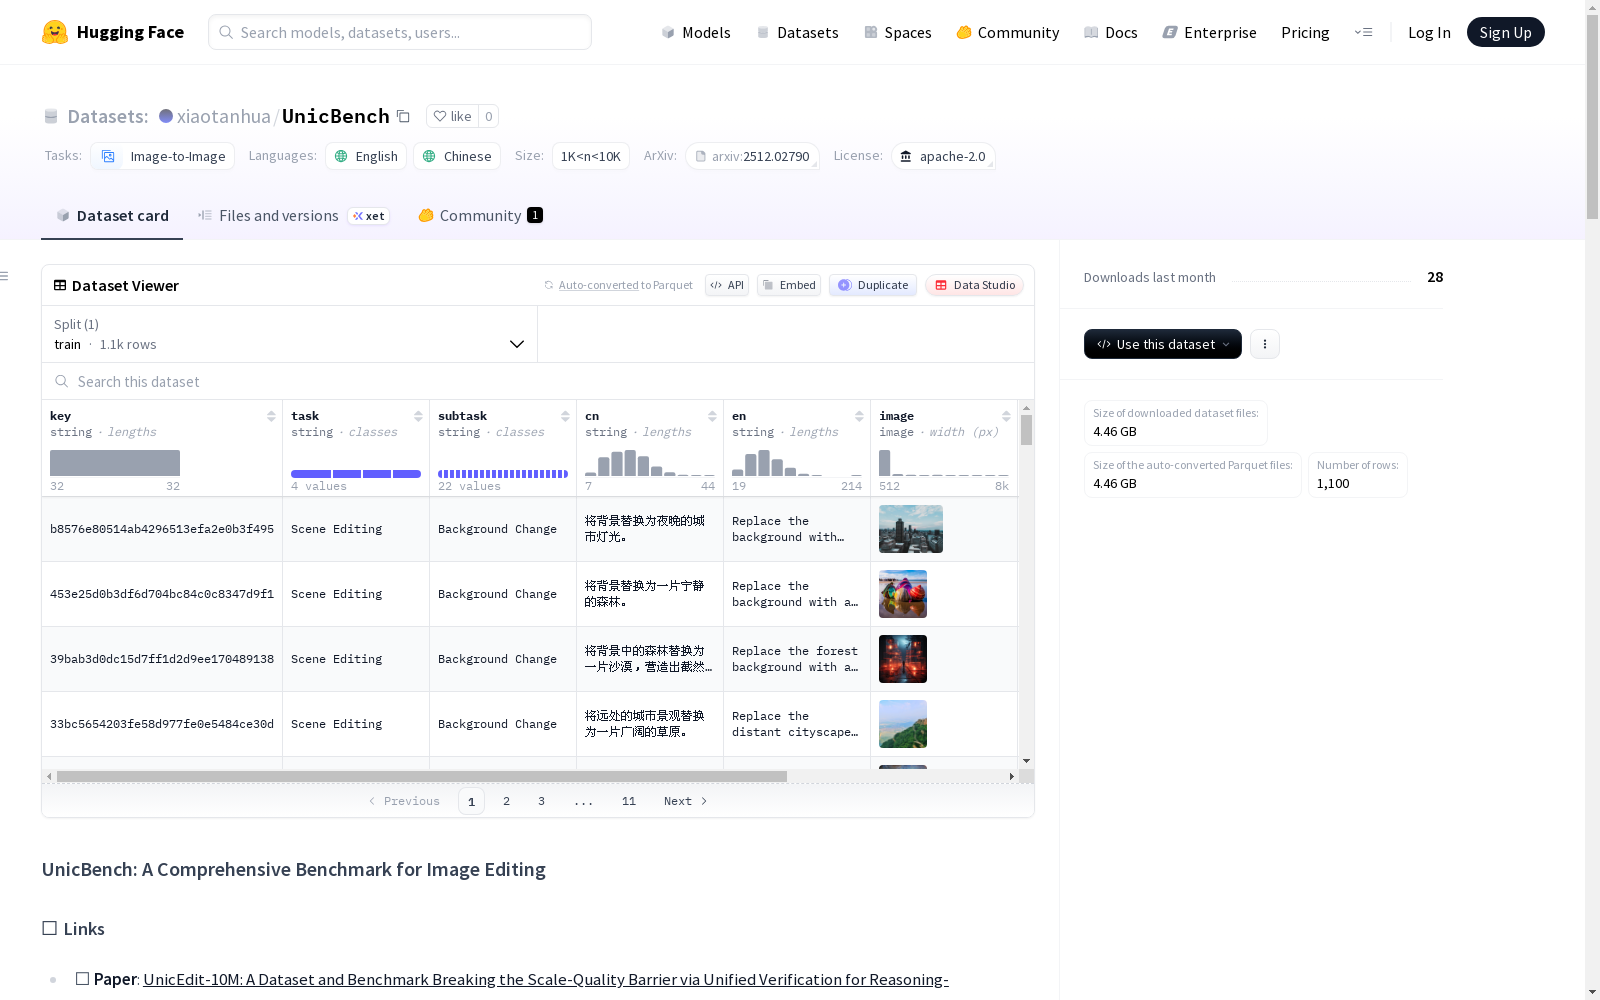
UnicBench是一个全面的图像编辑模型评估基准测试,旨在评估空间和知识驱动的推理能力。该数据集包含1,100个样本,分为4个任务类别(对象编辑、属性编辑、场景编辑和推理编辑)和22个子任务。每个样本包含唯一标识符、任务类别、子任务名称、中英文编辑指令、原始图像、分辨率以及推理点(仅限推理编辑任务)。数据集还提供了详细的评估指标,包括指令遵循、非编辑一致性、视觉质量和推理准确性。
UnicBench is a comprehensive benchmark for evaluating image editing models, designed to assess spatial and knowledge-driven reasoning capabilities. This dataset comprises 1,100 samples, categorized into 4 task categories (object editing, attribute editing, scene editing, and reasoning editing) and 22 subtasks. Each sample includes a unique identifier, task category, subtask name, editing instructions in both Chinese and English, original image, resolution, and reasoning points (only applicable to reasoning editing tasks). The dataset also provides detailed evaluation metrics including instruction following, non-editing consistency, visual quality, and reasoning accuracy.
UnicBench 数据集概述
数据集基本信息
- 数据集名称: UnicBench
- 发布者: xiaotanhua
- 许可证: Apache 2.0 License
- 语言: 英语 (en)、中文 (zh)
- 数据规模: 1K < n < 10K
- 任务类别: 图像到图像 (image-to-image)
数据集内容与结构
- 总样本量: 1,100 个样本
- 数据分割: 仅包含训练集 (train)
- 下载大小: 4,462,869,737 字节
- 数据集大小: 4,467,912,396.6 字节
任务类别与样本分布
UnicBench 包含 4 个主要任务类别,共 22 个子任务:
- 物体编辑 (Object Editing): 7 个子任务,350 个样本。涉及在图像中添加、移除或修改物体。
- 属性编辑 (Attribute Editing): 5 个子任务,250 个样本。涉及更改颜色、纹理或材质等属性。
- 场景编辑 (Scene Editing): 5 个子任务,250 个样本。涉及修改背景、照明或环境元素。
- 推理编辑 (Reasoning Editing): 5 个子任务,250 个样本。涉及需要空间推理或多步骤操作的复杂任务。
数据字段说明
| 字段名 | 数据类型 | 描述 |
|---|---|---|
key |
string | 每个样本的唯一标识符。 |
task |
string | 主任务类别:Object Editing、Attribute Editing、Scene Editing 或 Reasoning Editing。 |
subtask |
string | 具体的子任务名称(例如:Background Change、Color Alteration、Compound Operation Edits)。 |
cn |
string | 中文编辑指令。 |
en |
string | 英文编辑指令。 |
image |
Image | 待编辑的原始源图像。 |
resolution |
list[int] | 图像分辨率,格式为 [宽度, 高度]。 |
reasoning_points |
list[string] | 推理编辑任务的验证点列表(仅适用于推理编辑样本,其他任务为 null)。 |
数据集目的与特点
- 核心目的: 用于评估图像编辑模型的综合基准,特别关注评估模型的空间和知识驱动推理能力。
- 关键特点: 是 UnicEdit-10M 项目的一部分,引入了带有统一后验证的质量感知数据管理流程,用于富含推理的编辑。
- 评估粒度: 支持通过新颖的指标对图像编辑模型进行细粒度诊断,包括非编辑一致性 (Non-edit Consistency) 和推理准确率 (Reasoning Accuracy)。
评估指标
UnicBench 使用以下指标进行全面评估:
- IF (Instruction Following): 衡量编辑结果遵循给定指令的程度。
- NC (Non-edit Consistency): 衡量未编辑区域的一致性。
- VQ (Visual Quality): 衡量编辑图像的视觉质量和自然度。
- RA (Reasoning Accuracy): 衡量推理准确率(仅用于推理编辑任务)。
相关资源
- 论文: UnicEdit-10M: A Dataset and Benchmark Breaking the Scale-Quality Barrier via Unified Verification for Reasoning-Enriched Edits
- 代码仓库: GitHub - WeChatCV/UnicBench
- 项目主页: UnicEdit-10M
引用信息
如果 UnicBench 对您的研究有帮助,请引用以下论文: bibtex @inproceedings{Ye2025UnicEdit10MAD, title={UnicEdit-10M: A Dataset and Benchmark Breaking the Scale-Quality Barrier via Unified Verification for Reasoning-Enriched Edits}, author={Keming Ye and Zhipeng Huang and Canmiao Fu and Qingyang Liu and Jiani Cai and Zheqi Lv and Chen Li and Jing Lyu and Zhou Zhao and Shengyu Zhang}, year={2025}, url={https://api.semanticscholar.org/CorpusID:283458518} }