
遇见数据集

FINAL-Bench/Aether-7B-5Attn-checkpoints

收藏
Hugging Face2026-07-20 更新2026-07-22 收录
官方服务:

资源简介:

Aether-7B-5Attn中间预训练检查点数据集,包含在预训练过程中生成的三个中间检查点(步骤110,000、115,000和162,000),用于支持完全可重复性和训练动态研究,符合OLMo级别的“完全开放”标准。这些检查点对应于近似98B、102B和144B令牌的训练数据,其中162,000步骤的检查点是最终退火基准模型的原始版本。每个检查点文件夹包括model.safetensors、config.json和tokenizer文件,基于自定义架构aether_v2_7way,需使用基础模型仓库中提供的aether_pkg代码加载,并在推理时以batch_size=1运行。

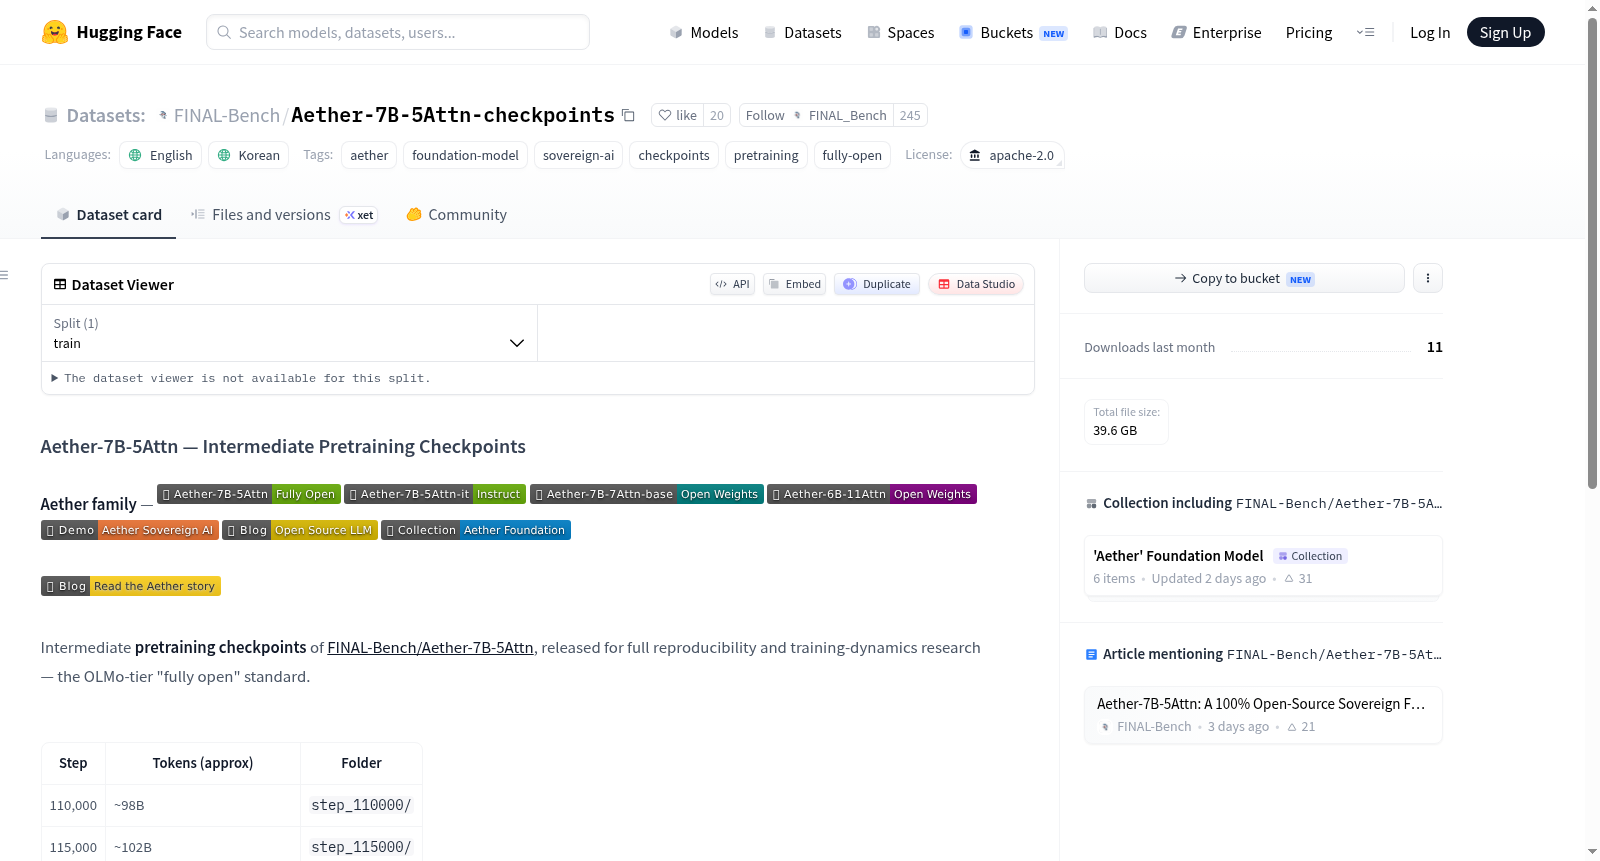
Aether-7B-5Attn Intermediate Pre-training Checkpoint Dataset contains three intermediate checkpoints generated during pre-training (steps 110,000, 115,000, and 162,000). This dataset is designed to support full reproducibility and training dynamics research, and complies with the "fully open" standard at the OLMo level. These checkpoints correspond to training data of approximately 98B, 102B, and 144B tokens respectively, and the checkpoint at step 162,000 is the original version of the final annealed baseline model. Each checkpoint folder includes model.safetensors, config.json, and tokenizer files. Based on the custom architecture aether_v2_7way, these checkpoints require the aether_pkg code provided in the base model repository for loading, and must be run with a batch_size=1 during inference.
提供机构:
FINAL-Bench
搜集汇总
数据集介绍
FINAL-Bench/Aether-7B-5Attn-checkpoints 数据集图片
构建方式
该数据集为Aether-7B-5Attn模型在预训练过程中产生的中间检查点集合,严格遵循OLMo标准的“完全开放”理念构建,旨在保障模型训练的完全可复现性,并服务于训练动态分析研究。具体而言,数据集收录了训练步数为110,000、115,000及162,000三个关键节点的模型参数快照,分别对应约98B、102B及144B token的训练进度。每个检查点文件夹均包含model.safetensors、config.json及tokenizer文件,其模型架构为自定义的aether_v2_7way,需配合基础模型仓库提供的专用加载代码使用。
特点
该数据集的核心特点在于其完整记录了模型从训练中期至退火前阶段的参数演化轨迹,为研究者提供了窥探大规模语言模型内部学习动态的珍贵窗口。三个检查点覆盖了约98B至144B token的训练跨度,尤其包含了最终退火前的基础检查点(第162,000步),使得用户能够追溯模型性能变化的连续性。此外,数据集采用Apache-2.0许可协议,完全开放权重,体现了对开源精神与科学透明度的坚定承诺,适合用于可重复性验证及模型行为解析等深度研究场景。
使用方法
使用该数据集时,需首先从Aether-7B-5Attn基础模型仓库中获取aether_pkg/目录下的自定义加载代码,该代码专门用于解析aether_v2_7way架构的检查点文件。加载模型后,建议在batch_size为1的设置下运行推理,以确保计算稳定性。用户可根据研究需求选取不同步数的检查点进行对比分析,例如复现模型在特定训练阶段的性能表现,或探究参数变化与下游任务能力之间的关联。数据集中的config.json和tokenizer文件可直接用于配置模型结构和分词器,简化了环境搭建流程。
背景与挑战
背景概述
Aether-7B-5Attn-checkpoints数据集由韩国人工智能研究机构VIDRAFT(주식회사 비드래프트)于2024年推出,隶属于Aether基础模型家族,旨在推动大规模语言模型的完全开源与可复现性。该数据集记录了Aether-7B-5Attn模型在预训练过程中第110,000步至162,000步的中间检查点,涵盖约98B至144B词元的训练进程。核心研究问题聚焦于验证新颖的Aether v2 7-way自定义架构在语言建模中的能力,并开创性地遵循OLMo标准的“完全开放”原则,公开所有训练中段参数。这一举措显著提升了领域内对训练动态、模型进化及性能收敛的研究透明度,为后续主权人工智能(Sovereign AI)的发展奠定了坚实基础。
当前挑战
该数据集在解决大型语言模型研究领域面临两大核心挑战。首先,领域问题层面,传统模型多仅发布最终版本,导致训练过程如黑箱,难以探究不同训练阶段对下游任务表现的影响,Aether-7B-5Attn-checkpoints通过开放中间检查点,克服了这一研究瓶颈,使开发者能够精确定位模型能力突变的临界点。其次,构建过程中,团队需应对自定义架构(aether_v2_7way)的兼容性与加载难题,确保检查点文件(含model.safetensors、config.json及tokenizer)能在单批次推理下稳定加载;此外,还需平衡检查点存储开销与模型规模(7B参数)及步频(每5,000步保存)之间的关系,避免资源膨胀影响后续微调效率。
常用场景
经典使用场景
Aether-7B-5Attn-checkpoints 作为一次完整的预训练过程所产出的中间检查点,最经典的使用场景在于训练动态(Training Dynamics)的深入解析与模型的完全可复现性研究。研究人员能够通过在不同训练步(11万、11.5万、16.2万步)获取的模型权重,细致追踪语言模型在长达约144B token的训练过程中,其内部表征、注意力模式以及损失函数的变化轨迹。借助这些快照,学者们可以揭示模型从初始随机状态逐步涌现语言能力的机制,例如观察注意力头的分化过程、知识容量随训练步长的动态增长,以及预训练末期退火(annealing)操作对模型最终性能的塑造效应。该检查点系列严格遵循OLMo式的‘完全开放’标准,不仅提供权重文件,还附带了完整的配置与分词器,确保了任何研究者都能在无黑箱的条件下复现原始训练流程,从而公平地进行对比实验。
解决学术问题
该数据集解决了自然语言处理领域内一个长期存在的关键学术问题——如何获得可精细剖析训练过程的、完全透明的大规模语言模型中间检查点。长期以来,许多顶级模型仅发布最终权重,使得研究者无法追溯模型能力的形成因果,也难以诊断训练失效、梯度爆炸或灾难性遗忘等深层现象。Aether-7B-5Attn-checkpoints通过提供从110k步到162k步的连续快照,为探究模型容量的涌现时机、训练步长与注意力头配置(5路注意力)之间的协同关系提供了前所未有的实证基础。它使得‘训练阶段对下游任务性能的影响’这一议题有了可靠的实验载体,并且由于其Apache-2.0许可证,极大地降低了学术界的复现门槛,推动了负责任的机器学习研究文化的建设,尤其是在主权人工智能(Sovereign AI)背景下,这样的开源检查点对于构建透明、可审计的自主模型具有里程碑式的意义。
衍生相关工作
Aether-7B-5Attn-checkpoints的发布催生了数个具有高度学术影响力的相关工作。最直接的是其对应的基础模型Aether-7B-5Attn与指令微调版本Aether-7B-5Attn-it,它们利用这些检查点以监督微调(SFT)和直接偏好优化(DPO)等方法训练出了具有实用对话能力的变体。此外,围绕此检查点系列,社区衍生出了对注意力架构比较的研究——通过对比5路注意力与Aether家族中7路、11路注意力的检查点演化,研究者得以系统评估不同注意力头数量对语言理解能力的分组影响。还有工作专门分析了中间检查点在检索增强生成(RAG)场景下的表征稳定性,以及如何利用这些快照进行模型剪枝与知识蒸馏的初始状态筛选。这些衍生工作共同构建了一个以完全透明训练轨迹为核心的研究生态,大幅增强了开源大模型领域的可解释性与可重复性实验的基础设施。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

