
遇见数据集

docmatix-ir

收藏
Hugging Face2024-07-24 更新2024-12-12 收录
官方服务:

资源简介:

Docmatix-IR数据集是从原始的Docmatix数据集转换而来,专门用于训练文档视觉嵌入模型,以进行开放域视觉问答。该数据集通过过滤不合适的问题和挖掘硬负例,提供了高质量的训练数据。具体来说,使用Document Screenshot Embedding (DSE)模型对整个Docmatix语料库进行编码,并根据检索结果筛选问题。最终得到5.61M高质量训练样本,过滤掉约4M问题。

The Docmatix-IR dataset is converted from the original Docmatix dataset, and is specifically designed for training document visual embedding models to perform open-domain visual question answering. This dataset provides high-quality training data by filtering inappropriate questions and mining hard negatives. Specifically, the Document Screenshot Embedding (DSE) model is used to encode the entire Docmatix corpus, and questions are screened based on retrieval results. Finally, 5.61 million high-quality training samples are obtained, with approximately 4 million questions filtered out.

创建时间:
2024-07-24
原始信息汇总

Docmatix-IR 数据集概述

数据集描述

Docmatix-IR 是从原始的 Docmatix 数据集转换而来的,专门用于训练文档视觉嵌入模型,以进行开放域视觉问答任务。原始的 Docmatix 数据集包含大量的 PDF 图像(2.4M)和相关问题(9.5M),但许多问题不适用于开放域问答。

数据处理步骤

  1. 过滤问题:移除过于具体且不适用于开放域问答的问题,例如“文本的摘要是什么?”
  2. 挖掘硬负样本:为每个问题识别具有挑战性的负样本,以创建高质量的训练数据。

具体处理方法包括使用 Document Screenshot Embedding (DSE) 模型对整个 Docmatix 语料库进行编码,并为每个问题检索100个候选文档。如果正样本文档(原始配对的PDF图像)未出现在前100个检索结果中,则该查询被认为不适用于开放域检索并被过滤掉。如果正样本文档出现在前100个检索结果中,则非正样本文档被视为该问题的硬负样本。

数据集规模

经过过滤和硬负样本挖掘后,最终得到5.61M个高质量的训练样本,过滤掉了约4M个问题。

数据集使用方法

该数据集与原始的 Docmatix 数据集联合使用,原始数据集作为语料库以获取相应的图像数据。在 Docmatix-IR 中,查询ID和文档ID的格式如下:

  • 文档ID{example_idx}_{image_idx}
  • 查询ID{example_idx}_{question_idx}

其中,{example_idx} 对应于原始 Docmatix 数据集中的示例索引。

例如,获取文档ID为 {123_1} 的图像数据可以使用以下代码: python from datasets import load_dataset

corpus = load_dataset(HuggingFaceM4/Docmatix)[train] docid = "123_1" example_idx, image_idx = docid.split(_) target_image = corpus[int(example_idx)][images][int(image_idx)]
搜集汇总
数据集介绍
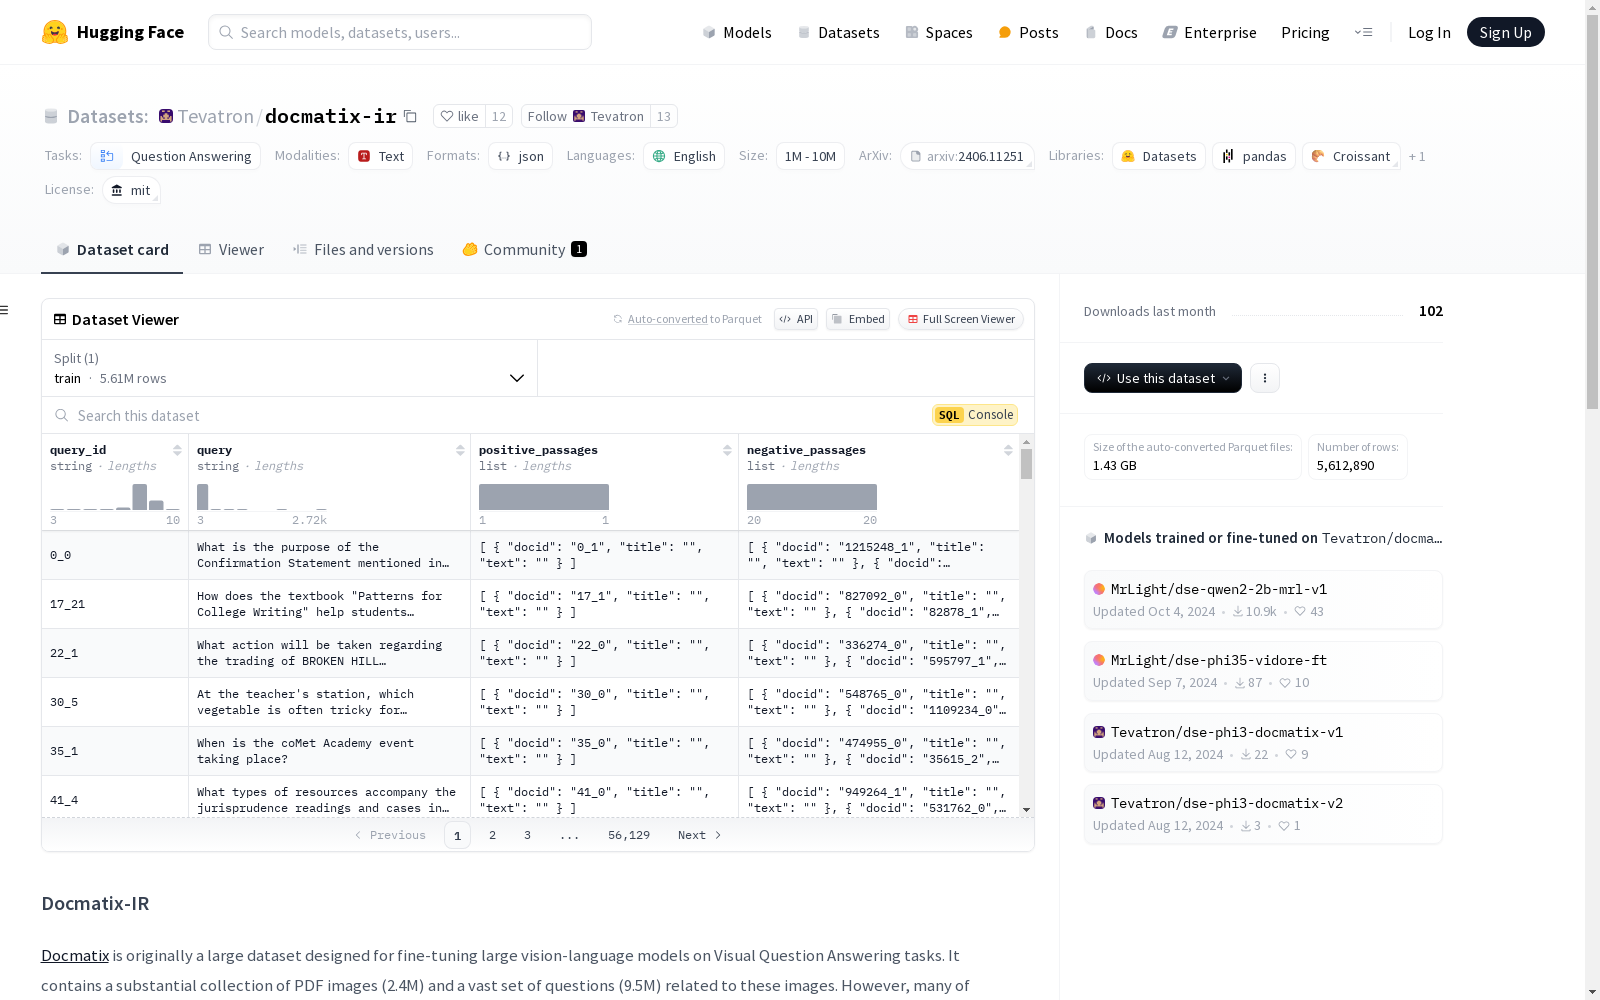
docmatix-ir 数据集图片
构建方式
Docmatix-IR数据集的构建过程基于原始Docmatix数据集,旨在为开放域视觉问答任务提供高质量的文档视觉嵌入模型训练数据。首先,通过筛选问题,去除了不适合开放域问答的特定问题,如文本摘要类问题。随后,利用Document Screenshot Embedding (DSE)模型对Docmatix语料库进行编码,检索每个问题的候选文档,并筛选出正例文档未出现在前100检索结果中的问题。最终,通过挖掘困难负例,生成了561万条高质量的训练样本。
特点
Docmatix-IR数据集的特点在于其专注于开放域视觉问答任务,提供了大量经过筛选的高质量训练样本。数据集包含561万条训练样本,每条样本均经过严格筛选和困难负例挖掘,确保了模型训练的挑战性和有效性。此外,数据集与原始Docmatix数据集紧密结合,用户可以通过查询ID和文档ID轻松获取对应的图像数据,极大地方便了模型训练和评估。
使用方法
Docmatix-IR数据集的使用方法较为直观,用户需结合原始Docmatix数据集进行训练。通过查询ID和文档ID,用户可以轻松获取对应的图像数据。具体操作中,用户需加载Docmatix数据集,并根据文档ID提取目标图像。例如,使用`load_dataset`函数加载数据集后,通过解析文档ID获取图像索引,进而提取目标图像。详细的训练代码可参考GitHub上的Tevatron项目。
背景与挑战
背景概述
Docmatix-IR数据集是基于Docmatix数据集的一个改进版本,专为开放域视觉问答任务而设计。Docmatix最初由HuggingFaceM4团队开发,旨在通过大量的PDF图像(240万张)和相关问题(950万个)来微调大规模视觉语言模型。然而,Docmatix中的许多问题并不适合开放域问答任务。为了解决这一问题,研究人员通过过滤问题和挖掘困难负样本,将Docmatix转化为Docmatix-IR,生成了561万个高质量的训练样本,用于文档视觉嵌入模型的训练。这一改进显著提升了模型在开放域视觉问答任务中的表现。
当前挑战
Docmatix-IR数据集在构建过程中面临的主要挑战包括:1) 开放域问答任务的适应性挑战,原始Docmatix数据集中的许多问题过于具体,无法直接用于开放域问答,因此需要通过筛选和过滤来确保问题的通用性;2) 高质量训练数据的生成挑战,为了提升模型的鲁棒性,研究人员需要从大量候选文档中挖掘出具有挑战性的负样本,这一过程不仅计算密集,还需要确保负样本的质量和多样性。此外,数据集的构建依赖于Document Screenshot Embedding (DSE)模型的零样本能力,这对模型的预训练和编码效率提出了较高要求。
常用场景
经典使用场景
Docmatix-IR数据集在视觉问答(Visual Question Answering, VQA)任务中展现了其独特的价值。该数据集通过过滤不适合开放域问答的问题,并挖掘具有挑战性的负样本,为文档视觉嵌入模型的训练提供了高质量的数据支持。研究人员可以利用该数据集进行开放域视觉问答模型的训练和评估,特别是在处理大规模PDF图像和相关问题时,Docmatix-IR能够显著提升模型的检索和问答能力。
解决学术问题
Docmatix-IR数据集解决了开放域视觉问答任务中的关键问题。通过过滤不适合开放域问答的问题,并挖掘硬负样本,该数据集为文档视觉嵌入模型的训练提供了高质量的数据支持。这不仅提升了模型在零样本场景下的表现,还为研究人员提供了一个标准化的基准,用于评估和改进视觉问答模型的性能。该数据集的推出,推动了视觉问答领域的研究进展,特别是在处理复杂文档图像和多样化问题时,具有重要的学术意义。
衍生相关工作
Docmatix-IR数据集的推出,催生了一系列相关研究工作。基于该数据集,研究人员开发了多种文档视觉嵌入模型,如Document Screenshot Embedding (DSE)模型,该模型在零样本场景下表现出色。此外,许多研究工作还探索了如何利用Docmatix-IR数据集进行多模态学习、跨模态检索等任务,进一步拓展了视觉问答领域的研究边界。这些衍生工作不仅丰富了视觉问答领域的研究内容,还为相关技术的实际应用提供了理论支持。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

