
遇见数据集

Nofing/EventStoryLine-0.9-standard-eci

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

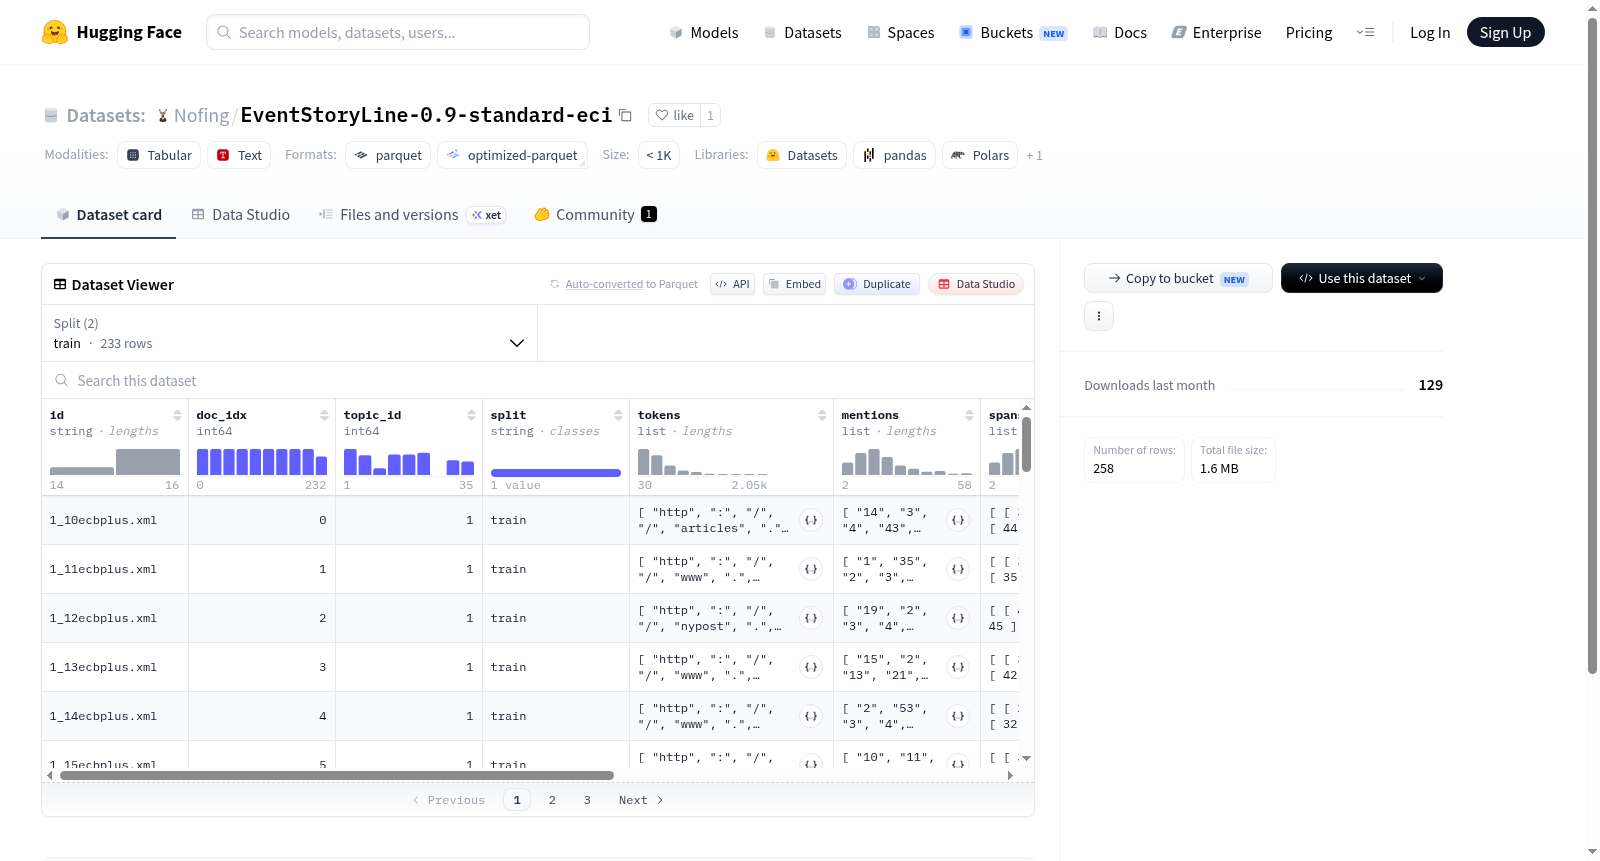
该数据集包含文本数据,具有多个特征字段,如id(标识符)、doc_idx(文档索引)、topic_id(主题ID)、split(划分类型,如训练集和开发集)、tokens(词元列表)、mentions(提及列表)、spans(跨度列表)、relations(关系结构,包括causes和causedby列表,表示因果关系)、sentences(句子索引列表)、text(原始文本)和annots(标注信息)。数据划分为训练集(233个示例)和开发集(25个示例),总大小约2.2MB。推断该数据集可能用于自然语言处理任务,如事件关系提取、因果关系分析或文本标注研究。

This dataset contains textual data with multiple feature fields, including id (identifier), doc_idx (document index), topic_id (topic ID), split (partition type such as training and development sets), tokens (list of tokens), mentions (list of mentions), spans (list of spans), relations (relational structure including causes and caused_by lists representing causal relationships), sentences (list of sentence indices), text (raw text), and annots (annotation information). The dataset is split into a training set with 233 examples and a development set with 25 examples, with a total size of approximately 2.2 MB. It is inferred that this dataset may be used for natural language processing tasks such as event relation extraction, causal relationship analysis, or text annotation research.
提供机构:
Nofing
搜集汇总
数据集介绍
Nofing/EventStoryLine-0.9-standard-eci 数据集图片
构建方式
EventStoryLine-0.9-standard-eci数据集源于对事件因果关系的精细化标注与结构化抽取。其构建过程以多文档语料为基础,首先将原始文本切分为句子与词元序列,并识别其中的事件提及及其在文本中的位置跨度。在此基础上,标注人员依据事件之间的因果依赖关系,构建了双向的因果关联矩阵,分别记录原因与结果对应的事件提及索引。数据最终被划分为训练集与开发集,各包含233和25个样本,以支撑事件因果链的建模任务。
特点
该数据集的核心特色在于其多层次、结构化的注释框架。它不仅提供了文档级的事件提及与词元序列,还精细标定了事件在原文中的起止跨度,为位置敏感的事件推理奠定了基础。尤为突出的是,关系字段以成对索引列表的形式明确编码了事件间的因果方向,即‘causes’与‘causedby’,从而支持有向因果图的构建。此外,每个样本保留完整原文与篇章索引,便于上下文感知的因果分析。
使用方法
使用该数据集时,研究者可首先通过'id'与'doc_idx'字段定位特定文档与主题,随后利用'tokens'与'mentions'序列获取词级与事件级表示。事件跨度信息可由'spans'字段解析,以对齐文本位置。因果关系的建模建议聚焦于'relations'子结构,将'causes'与'causedby'列表转化为有向边,构建事件因果图。数据已预划分训练与开发集,可直接加载用于事件因果抽取或时序推理任务的模型训练与评估。
背景与挑战
背景概述
EventStoryLine-0.9-standard-eci数据集诞生于自然语言处理领域中事件关系抽取与事件脉络构建的研究需求,由相关研究团队基于ECI语料库精心构建而成。该数据集的核心研究问题聚焦于如何从非结构化文本中识别事件、抽取事件之间的因果关系,并据此构建连贯的事件故事线。自创建以来,EventStoryLine数据集为事件关系抽取、事件时间线生成以及叙事理解等方向提供了标准化的评测基准,显著推动了该领域从孤立事件识别向事件间复杂关系建模的演进。
当前挑战
该数据集所解决的领域挑战在于,传统事件抽取研究多关注单一事件的类型与属性,而忽视了事件间因果、时序等逻辑关系的建模,EventStoryLine通过标注事件间的因果关系,为事件脉络理解这一前沿问题奠定了数据基础。在构建过程中,挑战主要体现为多粒度事件实体(如词汇级提及与句子级事件)的一致性标注、跨文档事件关系的一致性对齐,以及保证标注间因果关系的准确性和无冗余性,这需要标注人员对上下文有深入理解,且数据规模有限(仅233个训练样本),易导致模型泛化能力不足。
常用场景
经典使用场景
EventStoryLine-0.9-standard-eci数据集是事件关系抽取与事件故事线构建领域的经典资源。在自然语言处理研究中,该数据集被广泛用于训练和评估模型在文本中识别事件及事件间因果关系的能力。其核心使用场景聚焦于从新闻或叙述性文档中提取结构化的故事线,即通过捕捉事件及其时序与因果依赖关系,将离散事件组织成连贯的情节脉络。研究者通常基于该数据集中的标注信息,包括事件提及、触发词以及成对出现的因果关系,来开发端到端的事件关系抽取系统,进而推动事件推理与叙事理解技术的发展。
实际应用
在实际应用层面,EventStoryLine所支持的事件关系与故事线技术具有广泛的落地场景。在新闻聚合平台中,系统可自动梳理重大事件的起因与后续发展,为用户生成以时间线为骨架的摘要报告。在金融舆情监控中,能够从海量公告中抽取引发股价波动的政策与市场事件链,辅助投资决策。此外,该数据集训练出的模型还可用于司法卷宗的事件簇分析,从杂乱卷宗中复原案件的关键发展脉络,提升信息检索与案情梳理的效率。这些应用均体现了将零散事件转化为可解释故事线的巨大商业与社会价值。
衍生相关工作
围绕该数据集已经衍生出诸多经典学术工作,其中最具代表性的包括基于图神经网络的事件关系推理模型和跨文档故事线生成框架。例如,有学者提出利用图注意力网络对事件提及及其上下文进行编码,通过学习因果关系图来内生地推断隐式事件链条。另有工作将EventStoryLine作为核心评估集,开发了结合预训练语言模型的事件线索聚合方法,显著提升了在开放域新闻集合上的因果链接准确率。这些研究不仅深化了事件关系抽取的理论方法,还将该数据集的标准协议扩展至情感故事线与可视叙事分析等交叉领域,形成了持续活跃的研究分支。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

