augury-vision-gallery
收藏资源简介:
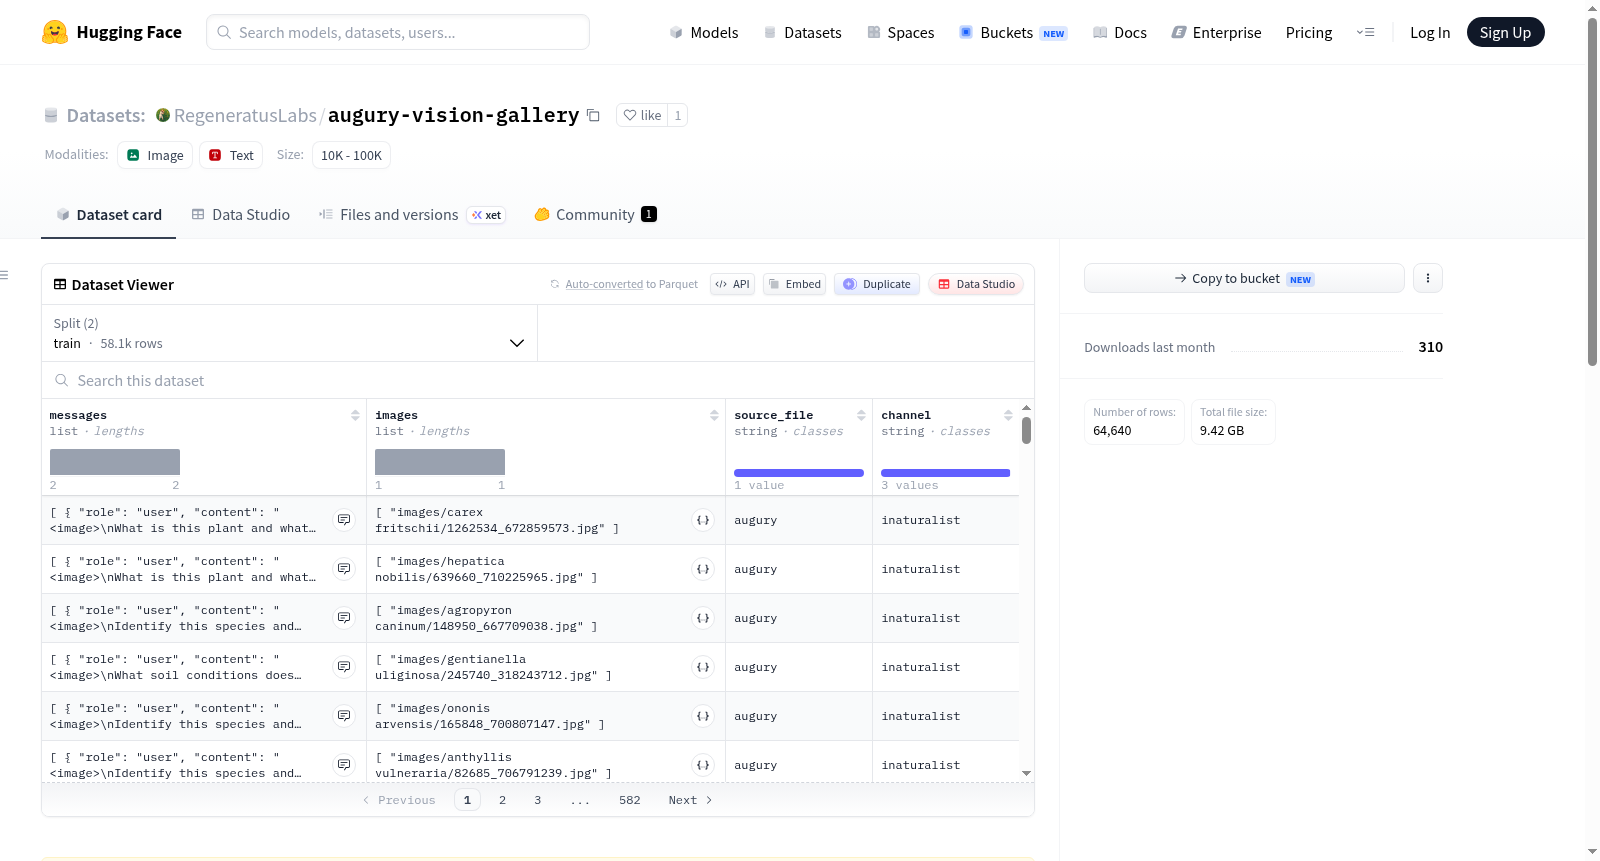
AUGURY Vision Gallery 是一个用于物种图像检索的数据集,专为 AUGURY 的 photo→species 漏斗设计。该数据集包含 111,320 张图片,涵盖 2,174 个物种,图像经过 DINOv2-base 编码后作为 FAISS kNN 检索库使用。数据集无需重新训练模型即可扩展——新物种只需添加新照片和数据库记录即可。数据集结构包括:images/目录下的图片文件和侧车文件、species_list.json、train.jsonl和val.jsonl(LLaMA-Factory sharegpt格式)、dataset_info.json。图像来源包括iNaturalist研究级图片约110k张、DeepWeeds数据集约5.2k张、GBIF补充图片数十张。整体为非商业用途,商业使用需移除NC图片或与摄影师协商。
AUGURY Vision Gallery is a dataset for species image retrieval, designed for AUGURYs photo→species funnel. It contains 111,320 images covering 2,174 species, encoded with DINOv2-base and used as a FAISS kNN retrieval library. The dataset can be extended without retraining the model—new species only require adding new photos and database records. The dataset structure includes: images/ directory with image files and sidecar files, species_list.json, train.jsonl and val.jsonl (in LLaMA-Factory sharegpt format), and dataset_info.json. Image sources include ~110k research-grade iNaturalist images, ~5.2k DeepWeeds dataset images, and dozens of GBIF supplementary images. The overall dataset is for non-commercial use; commercial use requires removing NC images or negotiating with photographers.
AUGURY Vision Gallery 数据集详情
数据集概述
AUGURY Vision Gallery 是一个用于物种识别检索的图像数据集,包含 111,320 张图片,覆盖 2,174 个物种。数据集设计为 FAISS kNN 检索库(使用 DINOv2-base 嵌入),支持在不重新训练模型的情况下,通过新增图片和数据库记录来扩充物种库。
数据内容
- 图像文件:存储于
images/<物种键>/<文件名>.jpg,其中来源于 iNaturalist 的图片为研究级质量。 - 许可信息:每个物种目录下包含
sources.jsonl文件,逐张记录图片的photo_id、file、license、source等许可信息,使用前必须查阅。 - 物种列表:
species_list.json包含 2,230 个物种条目,附有is_au标记和指示数据。 - 训练/验证划分:
train.jsonl:58,121 行(LLaMA-Factory sharegpt 格式)val.jsonl:6,519 行- 两个文件中的图像路径均为相对路径,assistant 答案由数据库生成。
- 注册配置:
dataset_info.json用于 LLaMA-Factory 的注册。
图片来源与许可
| 来源 | 数量 | 许可类型 |
|---|---|---|
| iNaturalist(研究级) | ~110,000 张 | 逐张许可:cc0 / cc-by / cc-by-sa / cc-by-nc / cc-by-nc-sa / cc-by-nc-nd(详见 sidecar 文件) |
| DeepWeeds(5 个澳大利亚物种) | ~5,200 张 | CC BY 4.0 |
| GBIF 补缺 | 数十张 | 逐条记录许可(见 sidecar 文件) |
重要提示:整个数据集整体为非商业用途,因为 iNaturalist 中的 cc-by-nc 图片不可重新许可。如需商业使用,必须移除 NC 类图片或与摄影师单独协商。使用时应按照 sidecar 文件中的要求标注摄影师信息。
构建方法
可通过 scripts/vision/build_llamafactory_dataset.py 脚本重新生成训练/验证划分,支持设置每物种数量上限、随机种子(seed 42)及相对图像路径。