us-patents-citation-company-dataset
收藏资源简介:
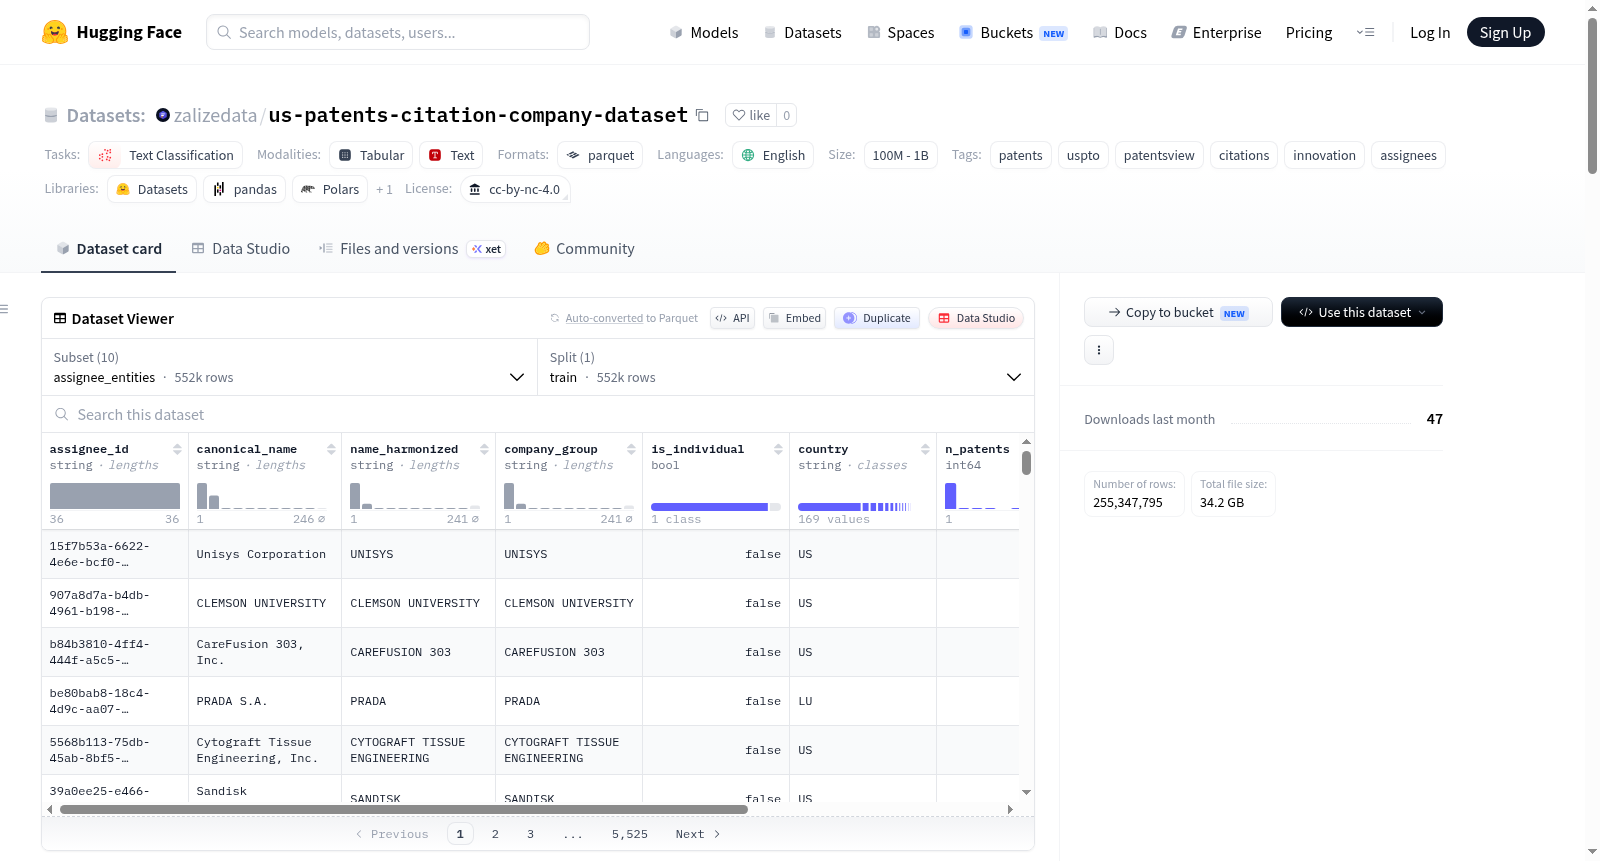
该数据集为美国专利、引用与受让人关系图(USPTO / PatentsView),由DataForge基于USPTO/PatentsView官方批量数据构建。包含自1976年至今的约910万项美国授权专利,以及完整的引用网络、受让人、发明人和CPC分类信息。全图版本总计超过2.55亿行数据。数据集以多个表(config)形式组织,包括:patents(专利主表,约9,075,421行)、citations(引用关系,约145,878,465行)、assignees(受让人,约8,385,078行)、inventors(发明人,约22,884,194行)、cpc(CPC分类,约56,755,723行)、assignee_entities(受让人实体,约552,495行)、citation_metrics(引用指标,约9,075,421行)、company_citations(公司引用,约2,229,371行)、company_profiles(公司画像,约481,780行)、cpc_trends(CPC趋势,约29,847行)。数据以Parquet格式存储,提供Snappy压缩分片。该数据集适用于创新与研发格局分析、现有技术及引用网络研究、公司技术画像、以及基于专利文本元数据的AI训练。学术与个人使用遵循CC BY-NC 4.0许可(需署名并回链至data.zalize.com),商业使用需获取DataForge商业许可。上游数据(USPTO PatentsView)遵循CC BY 4.0。
This dataset is a US patent, citation, and assignee relationship graph (USPTO/PatentsView), constructed by DataForge based on the official bulk data from USPTO/PatentsView. It contains approximately 9.1 million US granted patents from 1976 to the present, along with a complete citation network, assignees, inventors, and CPC classification information. The full graph version totals over 255 million rows of data. The dataset is organized into multiple tables (configs), including: patents (main patent table, ~9,075,421 rows), citations (citation relationships, ~145,878,465 rows), assignees (~8,385,078 rows), inventors (~22,884,194 rows), cpc (CPC classification, ~56,755,723 rows), assignee_entities (~552,495 rows), citation_metrics (~9,075,421 rows), company_citations (~2,229,371 rows), company_profiles (~481,780 rows), and cpc_trends (~29,847 rows). Data is stored in Parquet format with Snappy compression shards. This dataset is suitable for innovation and R&D landscape analysis, prior art and citation network studies, company technology profiling, and AI training based on patent text metadata. Academic and personal use follows CC BY-NC 4.0 license (attribution and backlink to data.zalize.com required), while commercial use requires a commercial license from DataForge. Upstream data (USPTO PatentsView) follows CC BY 4.0.
数据集概述
该数据集为美国专利、引用及受让人图谱数据集,基于美国专利商标局(USPTO)/PatentsView的官方批量数据构建,涵盖1976年至今的910万项美国授权专利及其完整的引用图谱、受让人、发明人和CPC分类信息。
关键信息
- 名称:US Patents, Citations & Assignee Graph (USPTO / PatentsView)
- 许可协议:CC BY-NC 4.0(学术/个人使用),商业使用需获得DataForge商业许可;上游数据为USPTO PatentsView批量数据,遵循CC BY 4.0
- 语言:英语
- 任务类型:文本分类
- 数据规模:1亿至10亿条记录
- 数据格式:Parquet(snappy压缩)
数据内容与规模
| 数据表 | 行数 | Parquet分片数 | 大小 |
|---|---|---|---|
| assignee_entities | 552,495 | 1 | 48.0 MB |
| assignees | 8,385,078 | 1 | 390.2 MB |
| citation_metrics | 9,075,421 | 1 | 92.8 MB |
| citations | 145,878,465 | 2 | 1,314.5 MB |
| company_citations | 2,229,371 | 1 | 36.5 MB |
| company_profiles | 481,780 | 1 | 13.2 MB |
| cpc | 56,755,723 | 2 | 614.6 MB |
| cpc_trends | 29,847 | 1 | 0.3 MB |
| inventors | 22,884,194 | 2 | 741.1 MB |
| patents | 9,075,421 | 6 | 3,637.5 MB |
此外还提供两个归档压缩包:
- patents-tier1-S-2026-08-02.zip:核心专利数据,9,075,421行,7.92 GB
- patents-tier1-M-2026-08-02.zip:完整图谱数据,255,347,795行,17.24 GB
数据配置
共包含10个可加载的数据配置:
assignee_entities、assignees、citation_metrics、citations、company_citationscompany_profiles、cpc、cpc_trends、inventors、patents
使用场景
- 创新与研发格局分析
- 现有技术和引文网络研究
- 公司技术画像刻画
- 面向专利文本元数据的AI训练
数据来源与方法
数据来源于USPTO/PatentsView批量下载,配套提供数据字典、数据表说明和质量评估报告。原始发布压缩包内含CSV/JSONL副本、数据字典、数据表说明及质量评估报告。
引用方式
PatentsView (CC BY 4.0); packaged by DataForge (data.zalize.com) — https://data.zalize.com/datasets/us-patents-citation-company-dataset