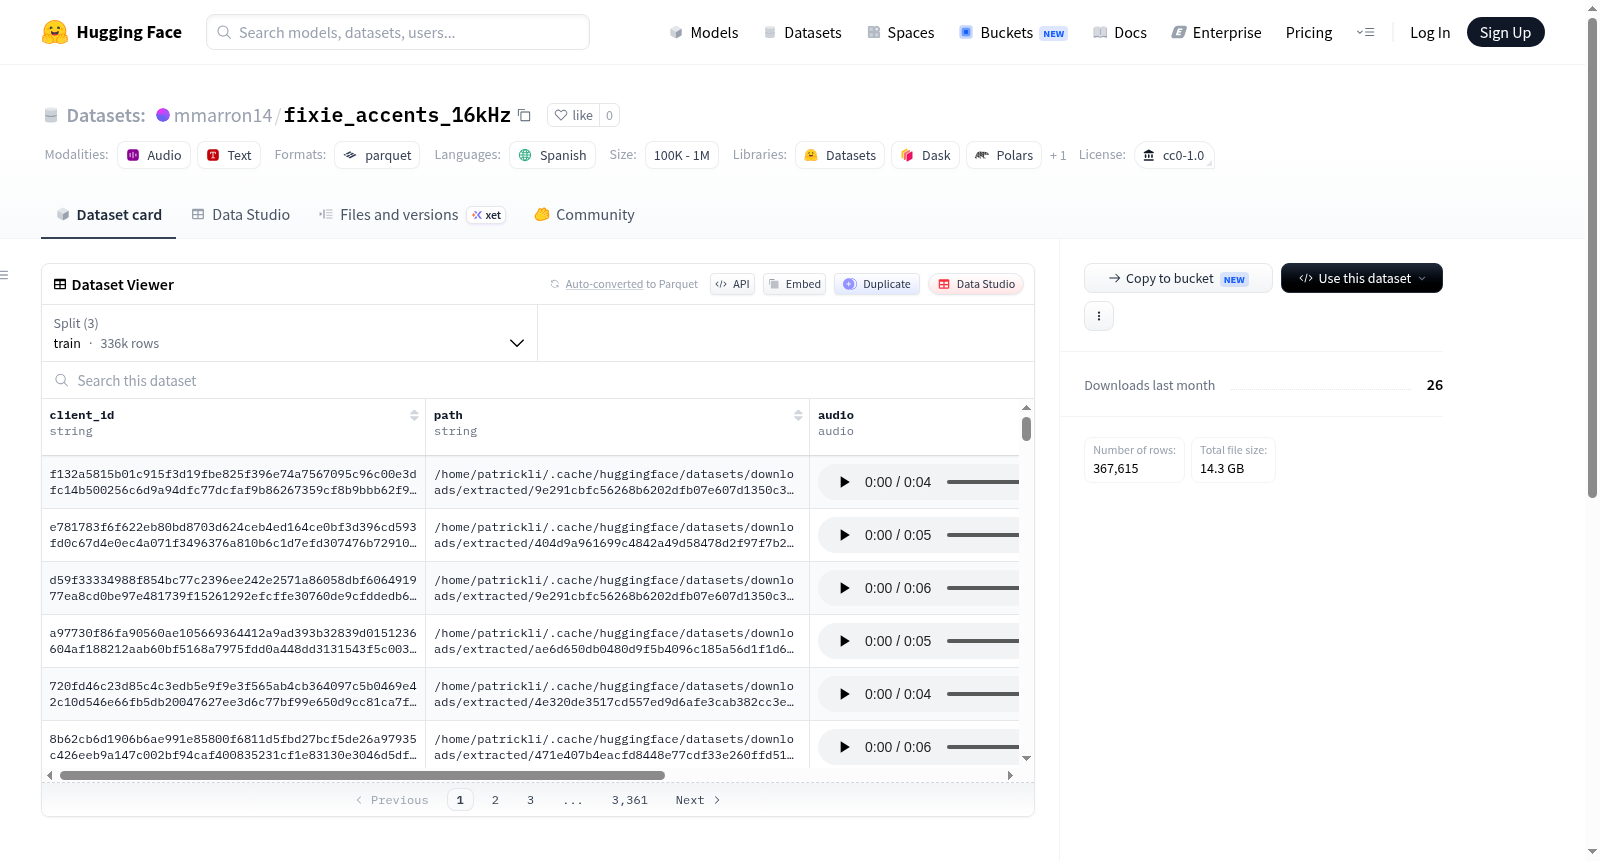
fixie_accents_16kHz
收藏资源简介:
本数据集是开源语音数据集fixie-ai/common_voice_17_0中西班牙语(es)配置的一个处理版本。主要修改包括:移除了原始数据中的部分列;对说话者口音(accents)信息进行了标准化过滤,仅保留Common Voice项目(由Mozilla基金会维护)在用户个人资料创建中定义的官方口音标签;并将所有音频统一重采样至16kHz的采样率。数据集包含367,615个语音样本,划分为训练集(336,051个样本)、验证集(15,823个样本)和测试集(15,741个样本)。每个样本提供音频文件(16kHz单声道)及其对应的转录文本(句子),并附带说话者的元数据,包括匿名客户端ID、年龄、性别和经过过滤的标准口音信息。该数据集适用于西班牙语的自动语音识别(ASR)模型训练与评估,以及语音技术研究中涉及说话者属性(如口音、年龄、性别)分析的任务。数据以CC0 1.0通用公共领域贡献许可发布。
This dataset is a processed version of the Spanish (es) configuration of the open-source speech dataset fixie-ai/common_voice_17_0. The main modifications are as follows: some columns in the original data have been removed; the speaker accent information has been standardized and filtered, only retaining the official accent tags defined by the Common Voice project (maintained by the Mozilla Foundation) during user profile creation; and all audio files have been uniformly resampled to a sampling rate of 16kHz. The dataset contains 367,615 speech samples, which are split into training set (336,051 samples), validation set (15,823 samples), and test set (15,741 samples). Each sample provides an audio file (16kHz mono) and its corresponding transcribed text (sentence), along with speaker metadata including anonymous client ID, age, gender, and filtered standard accent information. This dataset is suitable for training and evaluating automatic speech recognition (ASR) models for Spanish, as well as tasks involving speaker attribute (e.g., accent, age, gender) analysis in speech technology research. The data is released under the CC0 1.0 Universal Public Domain Dedication license.
数据集概述
数据集名称: mmarron14/fixie_accents_16kHz
语言: 西班牙语(es)
许可证: CC0-1.0(公共领域)
数据来源
本数据集是对 fixie-ai/common_voice_17_0 数据集中西班牙语(es)配置的加工版本,主要包括以下修改:
- 移除了一些列(字段)。
- 仅保留用户资料中由 Mozilla Foundation 定义的官方口音标签(
accent字段)。 - 将所有音频重采样至 16kHz。
数据集结构
特征(Features)
| 字段名 | 类型 | 描述 |
|---|---|---|
client_id |
string | 用户标识符 |
path |
string | 音频文件路径 |
audio |
audio (sampling_rate: 16000) | 音频数据,采样率为 16kHz |
sentence |
string | 对应的文本句子 |
age |
string | 说话人年龄 |
gender |
string | 说话人性别 |
accent |
string | 说话人口音(仅保留官方标签) |
数据集划分(Splits)
| 划分 | 样本数 | 字节数 |
|---|---|---|
train |
336,051 | 12,994,843,429 |
test |
15,741 | 740,016,337 |
validation |
15,823 | 764,908,014 |
| 总计 | 367,615 | 14,499,767,780 |
下载大小: 14,311,641,491 字节(约 13.3 GB)
数据集总大小: 14,499,767,780 字节(约 13.5 GB)
配置(Configs)
数据集包含一个配置 es,对应的数据文件路径模式为:
- 测试集:
data/test-* - 训练集:
data/train-* - 验证集:
data/validation-*
引用
- Fixie-ai (2024). Common Voice (Version 17.0). [Dataset]. Hugging Face. (https://huggingface.co/datasets/fixie-ai/common_voice_17_0)
- Ardila, R., Branson, M., Davis, K., Henretty, M., Kohler, M., Meyer, J., Morais, R., Saunders, L., Tyers, F. M., & Weber, G. (2020). Common voice: A massively-multilingual speech corpus. LREC 2020 - 12th International Conference on Language Resources and Evaluation, Conference Proceedings, 4218-4222.