
遇见数据集

TrishanuDas/rebus-dataset

收藏
Hugging Face2025-11-08 更新2025-11-15 收录
官方服务:

资源简介:

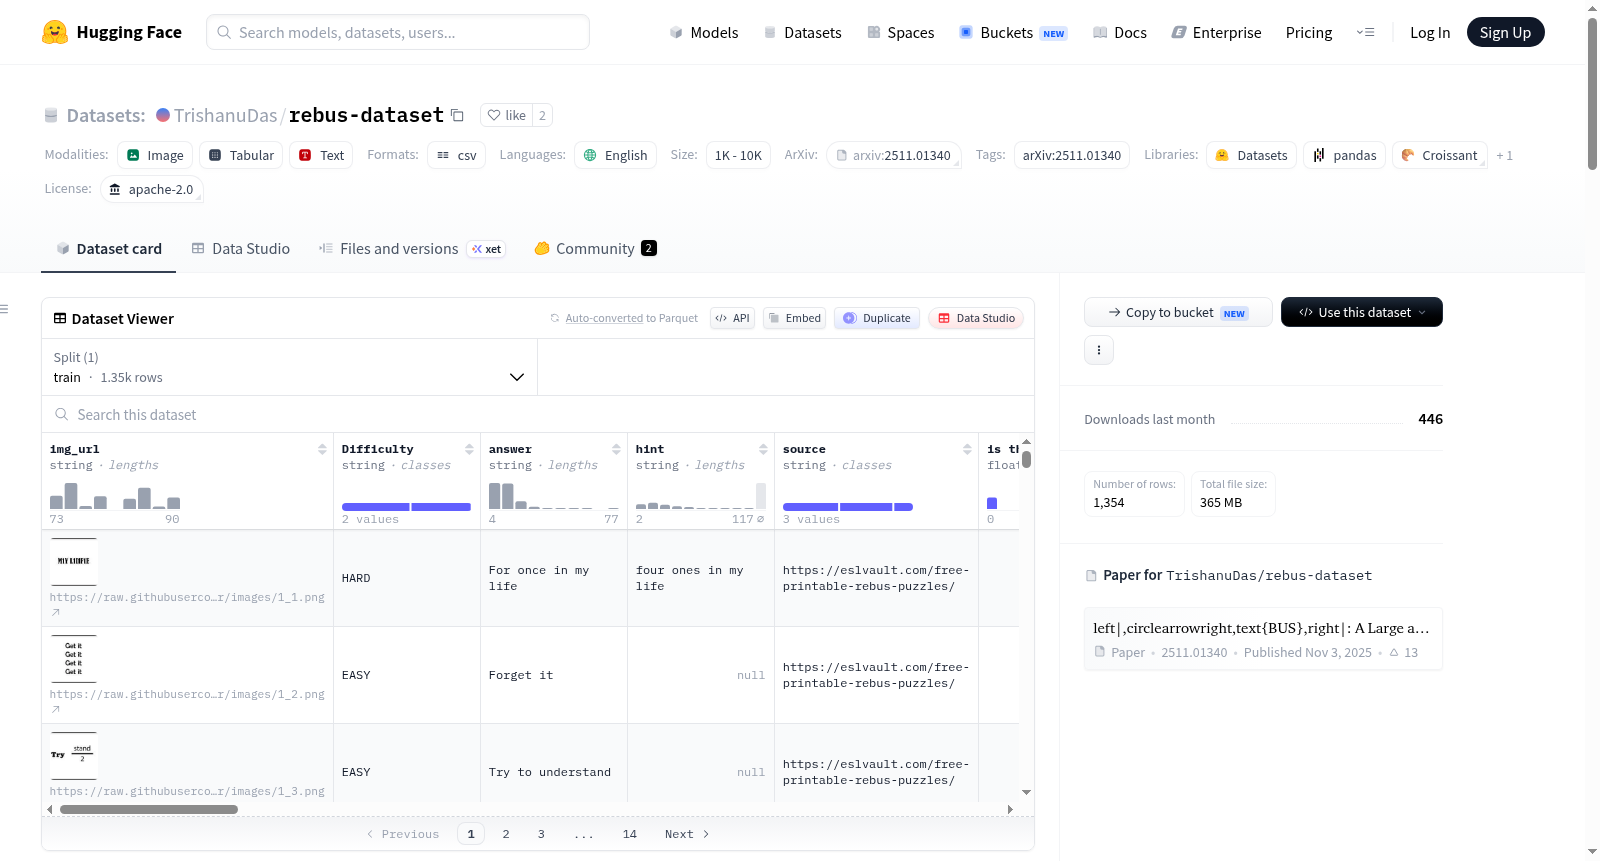
Re-Bus数据集是一个高质量注释的多模态推理基准,设计用于评估视觉语言模型的复杂推理能力。谜语谜题是一种文字游戏,使用图像、符号和字母来表示单词或短语,需要结合视觉感知和语言及常识知识的分层推理过程。该数据集经过精心策划,以挑战模型进行多步骤推理和理解创作者意图的能力。它高度多样化,涵盖18个类别(例如,惯用表达、地理名称、金融术语)和多种艺术风格。

The Re-Bus dataset is a high-quality annotated multimodal reasoning benchmark designed to evaluate the complex reasoning capabilities of vision-language models. Rebus Puzzles are a form of wordplay that use images, symbols, and letters to represent words or phrases, requiring a layered reasoning process that combines visual perception with linguistic and commonsense knowledge. The dataset is curated to challenge models on their ability to perform multi-step reasoning and understand creator intent. It is highly diverse, covering 18 categories (e.g., Idiomatic Expressions, Geographical Names, Financial Terms) and various artistic styles.
提供机构:
TrishanuDas
搜集汇总
数据集介绍
TrishanuDas/rebus-dataset 数据集图片
构建方式
在视觉-语言模型日益精进的当下,评估其深层推理能力成为关键挑战。Rebus谜题作为一种融合图像、符号与文字的字谜游戏,要求模型具备多步推理与常识整合能力。为此,研究者构建了Re-Bus数据集,包含1,333个英文谜题,覆盖饮食、习语、体育等18个类别。数据集构建分为三阶段:首先从eslvault.com等公开来源收集722个原始谜题,经人工去重与答案校验;随后由四位英语母语院校的本科生标注员为每个谜题添加难度、提示、推理步骤及视觉属性重要性等元数据;最后利用ControlNet为611个谜题添加干扰背景以提升视觉复杂度,并由标注员筛选确保可解性,形成包含原始与增强版本的完整基准。
特点
该数据集的核心特色在于其多维度的复杂性与精细的标注体系。1,333个谜题不仅包含原始与增强两种版本,还覆盖了从食物、体育到金融术语的18个语义类别,并呈现多种艺术风格,极大挑战模型的泛化能力。每个谜题均附有丰富的元数据,包括二元难度分级、推理步骤数、以及颜色、位置、方向等视觉属性对解题的重要性标记。此外,数据集还提供了结构化代码推理与非结构化图像描述两种注释文件,支持对模型推理过程的多角度剖析。这种设计使其成为评估视觉-语言模型在认知推理、常识应用与多步逻辑整合方面能力的独特试金石。
使用方法
该数据集专为视觉-语言模型的多模态推理能力评估而设计。研究者可直接使用HuggingFace上的CSV文件加载全部1,333个谜题及标注,其中‘is_augmented’列标识增强样本。典型用法包括:将谜题图像与元数据作为输入,要求模型输出正确短语,通过准确率等指标衡量性能;或利用提供的结构化推理注释文件,测试模型在零样本或少样本条件下的多步推理能力。数据集特别适用于验证如REBUSDESCPROGICE等新型提示框架的效果。需注意,数据集仅限学术研究用途,且其英文文化偏见与难度主观性可能影响跨语言或跨文化场景的泛化结果。
背景与挑战
背景概述
在视觉语言模型(VLM)迅猛发展的当下,尽管其在视觉问答等任务上表现卓越,但面对需要深度认知整合与多步推理的复杂任务时仍显捉襟见肘。Rebus谜题作为一种融合图像、符号与文字的智力游戏,要求模型同时调动视觉感知、语言理解、常识推理及对创作者意图的揣摩,为评估VLM的类人推理能力提供了独特的试金石。由Trishanu Das、Abhilash Nandy等研究者于2025年创建的Re-Bus数据集,源自arXiv预印本(编号2511.01340),包含1333个精心标注的英文Rebus谜题,覆盖食物、习语、体育等18个类别,并引入ControlNet生成干扰背景以增加难度。该数据集通过提供高多样性、多风格、多难度的样本,填补了当前缺乏深层多模态推理基准的空白,对推动VLM从浅层感知向深层认知跨越具有里程碑意义。
当前挑战
Re-Bus数据集所应对的核心领域挑战在于,现有VLM难以胜任需要多步推理与常识整合的复杂视觉语言任务。具体而言,模型需在识别图像元素的基础上,解析符号隐喻、文字游戏及文化典故,并综合空间关系、颜色暗示等细微线索才能得出正确答案,这对当前模型的跨模态对齐与逻辑推理能力构成严峻考验。在数据集构建过程中,挑战同样突出:初始722个谜题需从三个网络来源手动去重并校正答案,确保标注准确性;随后利用ControlNet生成611个增强版时,需精心筛选以保证谜题在添加干扰背景后仍具可解性。此外,18类谜题覆盖的广泛文化习语与艺术风格,以及四名标注者主观评判难度等级带来的偏差,均为数据集的质量控制与泛化性增添了复杂性。
常用场景
经典使用场景
Re-Bus数据集的核心应用在于为视觉-语言模型(VLM)提供一项极具挑战性的多模态推理评估基准。该数据集包含1,333个英文画谜图像,跨越18个语义类别(如习语、运动、娱乐等),并融合了多种艺术风格与难度层级。经典使用场景是让模型在给定图像的情况下,通过多步推理、图像识别、常识推理与语言理解的协同作用,准确推断出隐藏的词语或短语,从而系统性地检验VLM在复杂认知任务上的综合表现。
衍生相关工作
围绕Re-Bus数据集,研究者已衍生出若干关键工作。其中,论文提出的REBUSDESCPROGICE框架将非结构化图像描述与结构化代码式推理相结合,显著提升了VLM在画谜任务上的表现,成为后续多模态提示工程的重要参照。此外,该数据集催生了对模型推理步骤可解释性的探索,以及针对文化偏见与难度主观性等局限性的改进方案,如扩展至多语言画谜或引入动态难度标注策略,进一步推动了多模态推理基准向更真实、更包容的方向发展。
数据集最近研究
最新研究方向
在视觉-语言模型(VLM)研究领域,复杂多模态推理能力的评估正成为前沿热点。Re-Bus数据集应运而生,它包含1,333个英文画谜,横跨18个类别,并通过ControlNet增强视觉复杂度,旨在挑战VLM在图像识别、常识推理与多步逻辑整合上的深层能力。这一基准揭示了当前模型在理解创作者意图与处理文化隐喻方面的显著局限,推动了诸如REBUSDESCPROGICE框架等新型推理方法的探索。其发布不仅为评估VLM的认知深度提供了严苛标尺,更呼应了多模态AI从感知走向理解的研究转向,对提升模型在复杂场景下的泛化性与鲁棒性具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

