
TransLegal/legal-sources-raw
收藏官方服务:
资源简介:
该数据集包含多个语言配置,主要用于存储不同语言的文档数据。其中,en-us配置包含英文文档的元数据和内容,如创建日期、修改日期、作者信息、文档类型、文本内容等。hr-hr配置则包含克罗地亚语的文本数据,如术语、意见ID和意见文本。每个配置都有对应的训练集大小和下载大小。
This dataset comprises multiple language-specific configurations, which are mainly used to store document data in different languages. The en-us configuration includes metadata and content of English documents, such as creation date, modification date, author information, document type, text content and other relevant details. The hr-hr configuration contains Croatian text data, including terminology, comment IDs and comment texts. Each configuration has its corresponding training set size and download size.
提供机构:
TransLegal搜集汇总
数据集介绍
构建方式
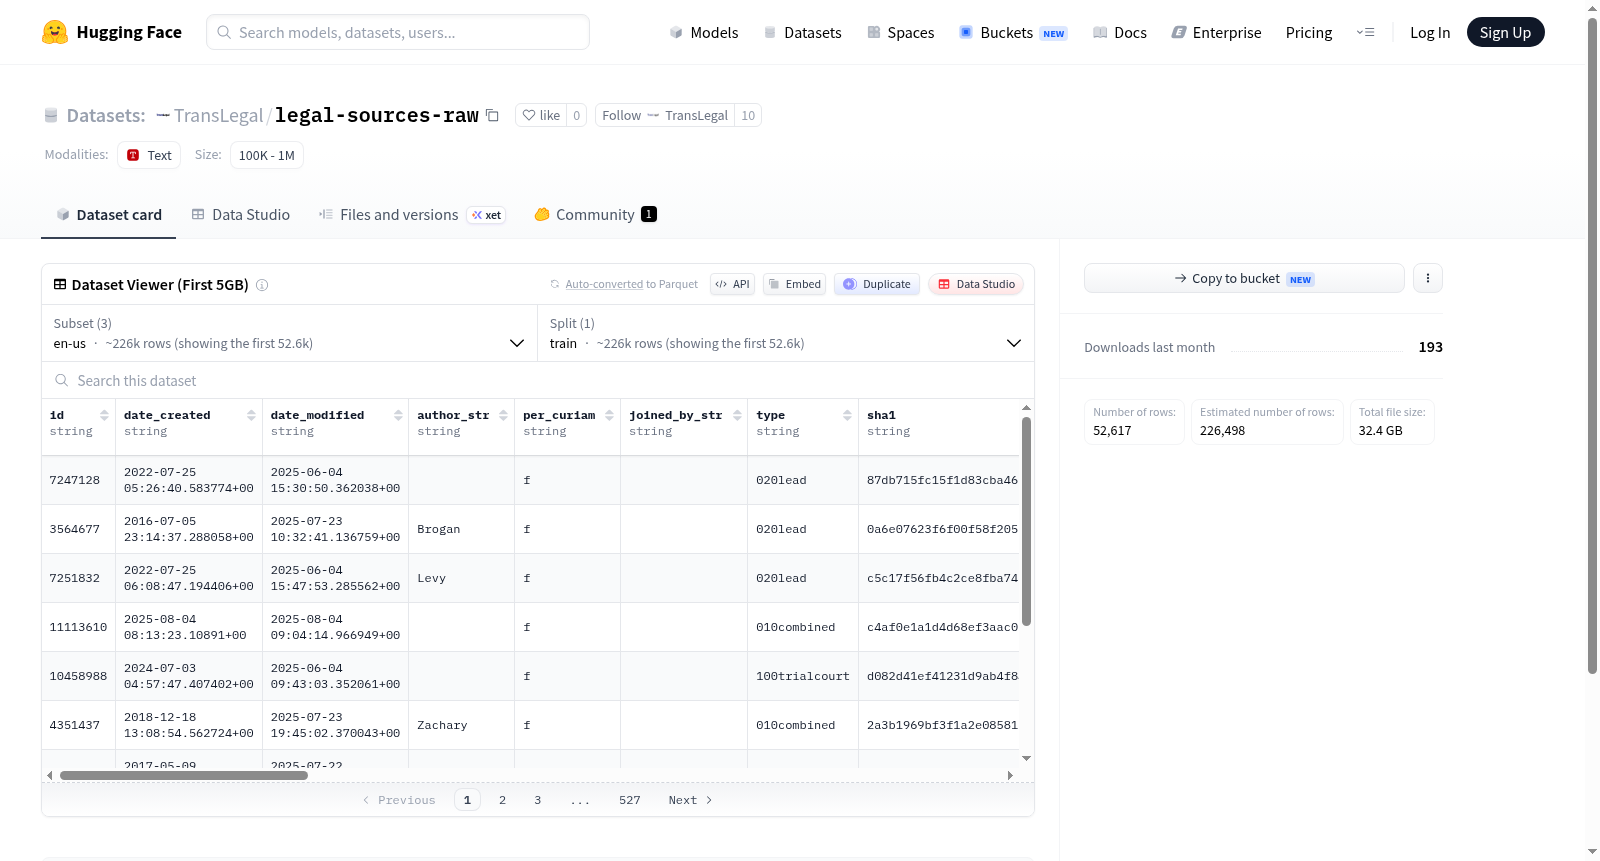
legal-sources-raw数据集旨在为法律人工智能与自然语言处理研究提供原始法律文本资源。该数据集通过聚合来自多个司法管辖区的公开法律意见构建而成,目前收录了美国(en-us)、克罗地亚(hr-hr)及瑞典(sv-se)的司法文书。美国子集包含超过41万条训练样本,每条样本均具备丰富的结构化元数据,如唯一标识符、创建与修改日期、作者信息、裁判类型、关联案件簇ID、页面数及多种格式的文本表示(纯文本、HTML、XML等)。克罗地亚子集则包含约5200条训练样本,主要以术语、意见ID及意见文本的形式组织。所有子集均以Parquet格式存储,并通过分片文件实现高效加载。
使用方法
使用legal-sources-raw数据集时,可通过Hugging Face的datasets库轻松加载。首先指定en-us或hr-hr等配置名称,利用load_dataset函数及分片通配符模式(如'en-us/train-*')读取数据。加载的数据集为标准Dataset对象,支持pandas转换、数据过滤及特征选择。研究者可根据任务需求提取plain_text字段用于文本分类或摘要,或利用html及xml字段进行结构化法律文档分析。请注意,某些字段仅适用于特定子集,需结合元数据字段如type或author_id进行精细化筛选,以适配下游法律推理或信息检索任务。
背景与挑战
背景概述
法律文本作为司法实践与法学研究的核心载体,其数字化整理与分析对推动法律智能化发展至关重要。legal-sources-raw数据集由多机构合作构建,旨在汇聚来自不同司法管辖区的原始法律文书,涵盖美国联邦法院(en-us)、克罗地亚法院(hr-hr)及瑞典法院(sv-se)的裁判文书与法律意见。该数据集创建于近年来法律人工智能勃兴之际,核心研究问题在于为法律文本挖掘、司法预测模型及法律知识图谱构建提供大规模、多语言、结构化的原始语料基础。其发布显著降低法学研究者与人工智能开发者获取法律文本的门槛,已在法律信息检索、判决结果预测及法律论证挖掘等领域产生深远影响,成为法律领域预训练语言模型的重要训练来源。
当前挑战
该数据集所面临的挑战首先源于法律文本的领域特殊性:司法文书语言高度结构化且充满专业术语与引证体系,对自然语言处理模型的语义理解与逻辑推理能力提出严苛要求;不同法系间的法律体系差异、判例引用惯例及文化背景的多变性,进一步加剧了跨语言迁移学习的难度。在构建过程中,数据采集面临来源分散、格式异构(多平台HTML、XML、OCR文本)的难题,需进行耗时的手动清洗与格式统一;此外,克区域数据(如hr-hr仅5200条)导致样本不均衡,以及部分历史文档的OCR识别误差,共同构成了该数据集在推动法律人工智能发展时必须克服的核心瓶颈。
常用场景
经典使用场景
legal-sources-raw数据集汇聚了来自美国联邦与州法院、克罗地亚及瑞典等多个司法管辖区的原始法律文本,为法律自然语言处理研究提供了大规模、多语言的语料基础。其经典使用场景聚焦于法律判决书的文本挖掘与分析,学者们利用该数据集训练模型以自动识别判决书的结构化要素,如案件事实、法律争议焦点与裁判理由,进而推动法律文书智能解析技术的发展。
解决学术问题
该数据集有效解决了法律领域学术研究中标注数据稀缺与多语言法律文本对齐的瓶颈问题。通过提供逾41万份美国判决书及数千份克罗地亚与瑞典的司法意见,研究者得以深入探索跨法系的法律语言特征、论证模式与判决预测任务。这极大促进了计算法学的发展,使自动法律推理、先例引用网络分析及司法决策的可解释性研究成为可能,对理解法律体系的运作机制具有深远意义。
实际应用
在实际应用层面,legal-sources-raw为法律科技产品提供了关键的数据支撑。律师事务所与法务部门利用基于该数据集训练的模型,能够高效完成合同条款自动审查、法律检索智能索引及判决结果预测等任务。此外,该数据集还赋能公共法律服务,助力开发面向普通民众的法律咨询机器人,使其能够基于海量真实判例提供初步的法律意见,从而降低法律服务的门槛。
数据集最近研究
最新研究方向
legal-sources-raw数据集为法律文本挖掘与司法智能分析提供了丰富的多语言语料基础,其收录的美国联邦法院判例全文及克罗地亚、瑞典等国的司法文书,正推动着法律领域大语言模型的预训练与微调研究。当前前沿方向聚焦于利用该数据集训练法律专用语言模型,以提升法律文本摘要、判决预测及法律推理等任务的性能。此外,结合OCR校正与多格式法律文档的结构化解析,该数据集在促进跨司法管辖区法律比较研究、自动化法律检索与证据分析方面展现出重要价值,为构建可解释的人工智能法律助手奠定了数据基石。
以上内容由遇见数据集搜集并总结生成


