law-links-votes
收藏资源简介:
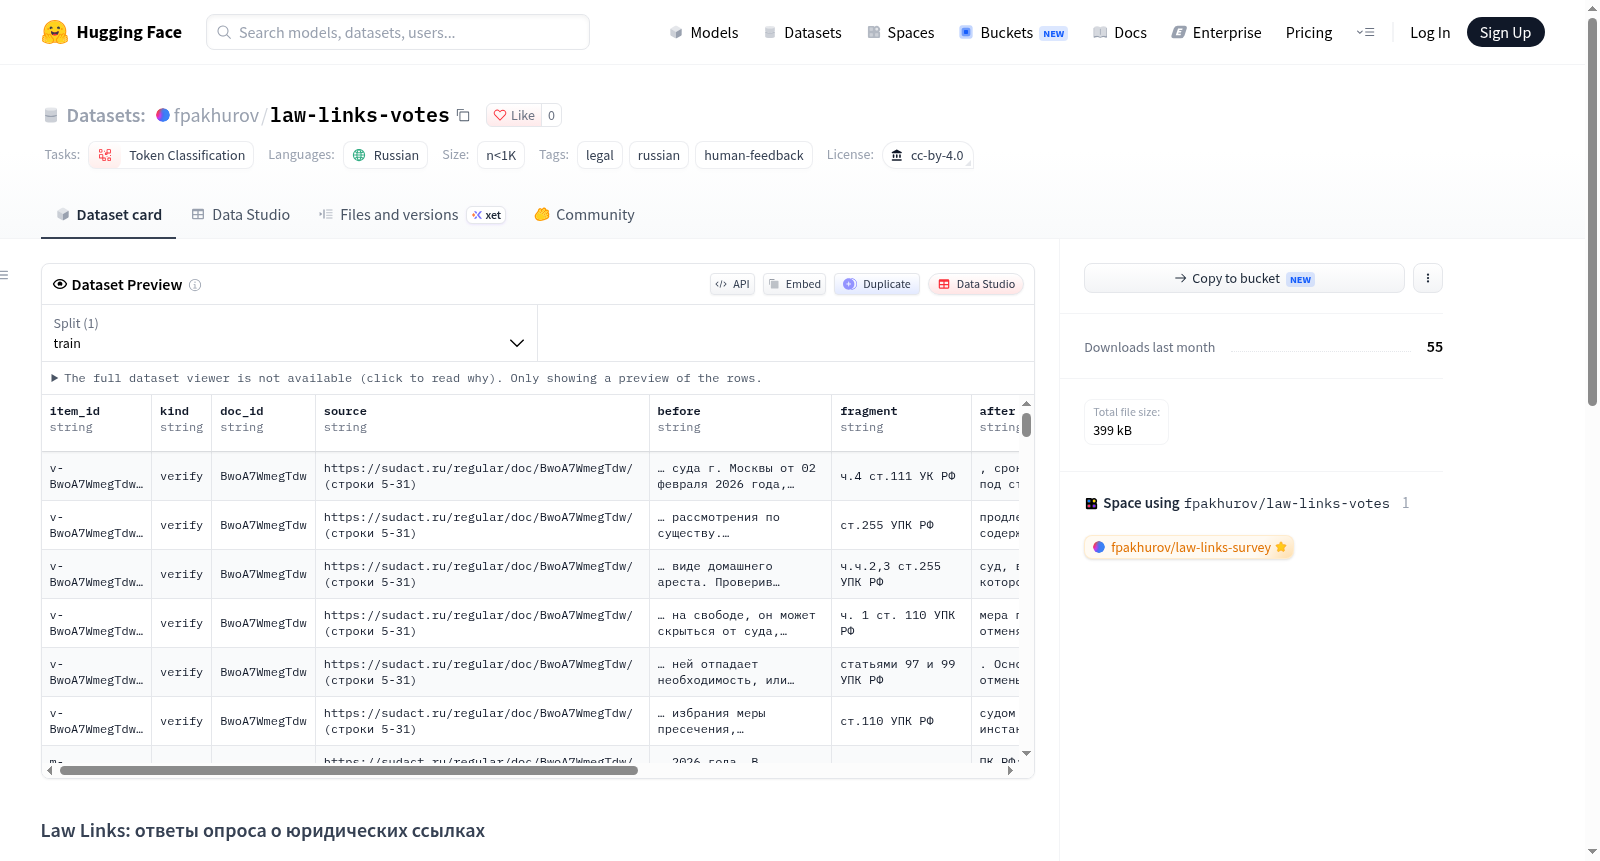
Law Links Survey Votes 是一个用于评估法律引用识别系统的数据集,基于俄罗斯司法判决文本中的法律引用标注(如 ч. 3 ст. 158 УК РФ)。数据集包含两类文件:items(问题)和 votes(投票结果)。问题分为三类:verify(验证程序已找到的引用是否正确)、missed(候选遗漏的引用,判断是否确实存在引用)、control(已知答案的控制问题)。每个问题包含上下文片段(before、fragment、after)、程序对引用的解析(claim)以及结构化字段(law、article、lower)。投票记录包含每个参与者对问题的回答(对于 verify/control:yes、no_law、no_article、no_part、no_ref、unsure;对于 missed:yes、other_doc、no、unsure),以及响应时间、参与者随机标识符和自定义姓名。数据来源为 sudact.ru 上的司法判决片段(已匿名,不受版权保护),问题由 law-links v1.0.1 模型生成。投票者是非法律专业的学生,通过控制问题筛选注意力不集中者。数据集规模小于1K样本,使用 CC-BY-4.0 许可证,仅用于研究和评估目的。
Law Links Survey Votes is a dataset for evaluating legal citation recognition systems, based on legal citation annotations (e.g., ч. 3 ст. 158 УК РФ) from Russian judicial decisions. The dataset contains two types of files: items (questions) and votes (voting results). Questions are divided into three categories: verify (verify whether program-found citations are correct), missed (candidate missed citations, decide if a citation actually exists), and control (control questions with known answers). Each question includes context snippets (before, fragment, after), the programs parsed citation (claim), and structured fields (law, article, lower). Each vote record contains the participants answer to the question (for verify/control: yes, no_law, no_article, no_part, no_ref, unsure; for missed: yes, other_doc, no, unsure), along with response time, participant random identifier, and custom name. The data source is anonymously processed judicial decision excerpts from sudact.ru (not copyrighted), and questions are generated by the law-links v1.0.1 model. Voters are non-law students, with attention filters via control questions. Dataset size is under 1K samples, licensed under CC-BY-4.0, for research and evaluation purposes only.
数据集概述
基本信息
- 数据集名称:Law Links Survey Votes(俄语:Law Links: ответы опроса о юридических ссылках)
- 数据集地址:https://huggingface.co/datasets/fpakhurov/law-links-votes
- 许可证:CC-BY-4.0
- 语言:俄语(ru)
- 任务类别:Token Classification(标记分类)
- 标签:legal、russian、human-feedback
- 数据规模:n<1K
数据集简介
该数据集包含关于俄罗斯法院判决文本中法律条文引用问题的“是/否”回答,用于验证程序是否正确找到并理解了法律引用(例如“ч. 3 ст. 158 УК РФ”对应 статья 158、часть 3、Уголовный кодекс),以及程序是否遗漏了片段中的引用。
相关资源
- 调查问卷:https://huggingface.co/spaces/fpakhurov/law-links-survey
- 服务、调查与分析代码:https://github.com/fpakhurov/law-links
- 方法论:https://github.com/fpakhurov/law-links/blob/master/docs/SURVEY.md
- 技术报告:https://github.com/fpakhurov/law-links/blob/master/REPORT.md
- 回答分析命令:
python -m annotation.survey analyze survey1 --votes <папка с votes>
文件结构
items/survey1.jsonl(问题)
字段包括:
item_id:问题标识kind:问题类型verify:验证已找到的引用missed:候选遗漏项control:已知答案的控制问题
doc_id:文档标识source:sudact.ru 上的判决链接及行号before/fragment/after:上下文与突出显示的片段claim:程序对片段的理解(以引用格式记录,如п. 6 ч. 1 ст. 24.5 — КоАП РФ)fields:按元素拆分(law、article、lower)links:引用格式{law_id, article, point_article, subpoint_article},law_id依据任务词典expected:control类型问题的答案
votes/votes-*.jsonl(回答,调查期间追加)
字段包括:
vote_id:回答标识item_id:问题标识kind:问题类型answer:答案- 对于
verify/control:yes、no_law(错误法律)、no_article(错误条款)、no_part(错误部分、点或子点)、no_ref(非引用)、unsure(跳过);早期回答中以no_numbers代替no_article/no_part - 对于
missed:yes(指向法律或法典的引用)、other_doc(指向其他文档)、no、unsure
- 对于
voter:浏览器随机标识name:参与者自拟名称ms:回答耗时time:UTC 时间
来源与限制
- 文本为 sudact.ru 的法院判决片段,已由来源去标识化;法院判决不受版权保护(俄罗斯联邦民法典第 1259 条第 6 款)。
- 问题由 law-links v1.0.1 模型生成。
- 回答者为学生,非律师;不认真的参与者通过控制问题筛除(
python -m annotation.survey analyze)。 - 基于
missed问题评估的完整度仅针对候选池,而非文本中的所有引用。