electricsheepasia/asia-ilo-ees-tees-sex-ifl-ec2-nb-employees-by-sex-informal-formal-job-and-economic
收藏资源简介:
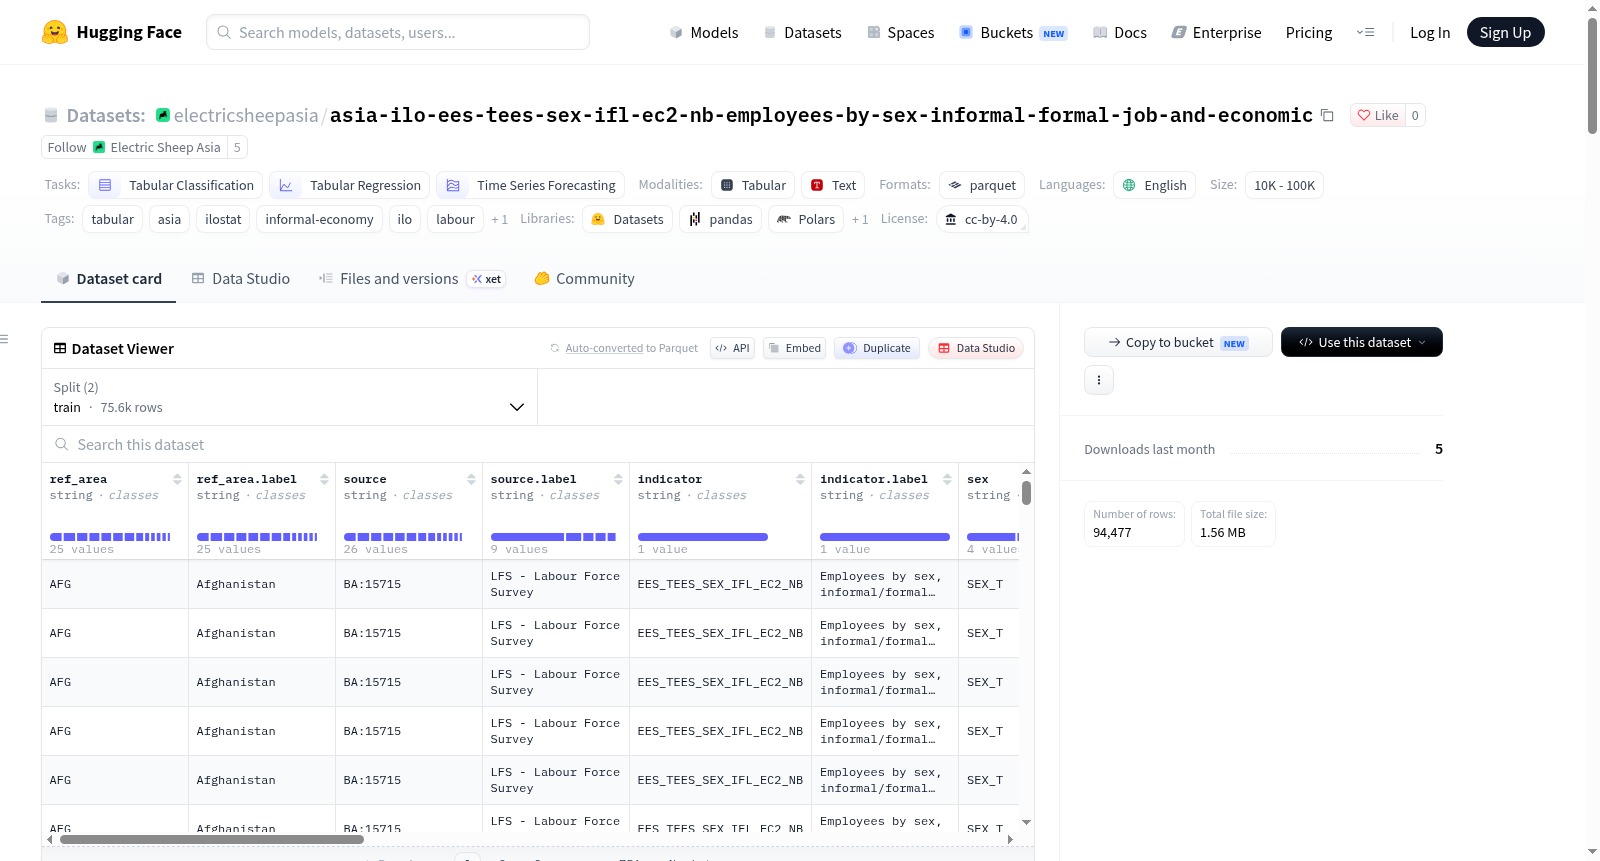
该数据集包含关于按性别、非正规/正规工作和经济活动划分的雇员 - ISIC 2级(千)的统计信息,专门针对亚洲地区。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,主题为非正规经济。数据集共有94,477个观测值,覆盖27个亚洲国家,时间跨度为2004年至2025年,包含1个主要指标(EES_TEES_SEX_IFL_EC2_NB)。数据以表格形式组织,包括国家代码、国家名称、数据来源、指标代码、性别分类、经济活动分类、观测年份、观测值等列。数据经过ILO的标准化处理,基于国际劳工统计学家会议(ICLS)定义,并提供了数据质量说明,如年度频率、最佳来源选择等。该数据集适用于表格分类、回归和时间序列预测等任务,旨在为亚洲地区的劳动力和就业研究提供机器学习就绪的数据层。
许可证:CC-BY-4.0 语言: - 英语 任务类别: - 表格分类 - 表格回归 - 时间序列预测 多语言属性:单语言 样本规模: - 10000 < 样本量 < 100000 标签: - 表格数据 - 亚洲 - 国际劳工组织统计数据库(ILOSTAT) - 非正规经济 - 国际劳工组织(ILO) - 劳动 - 就业 美观名称:"分性别、非正规/正规就业与经济活动的雇员——ISIC二级分类(千人) | 亚洲(ILOSTAT)" # 分性别、非正规/正规就业与经济活动的雇员——ISIC二级分类(千人) | 亚洲(ILOSTAT) 🌏 **94477条观测样本** · **27个亚洲国家** · **2004–2025年** · *由[Electric Sheep Asia](https://huggingface.co/electricsheepasia)重新整理发布*      ## 简短摘要 本数据集包含覆盖27个亚洲国家、时间跨度为2004至2025年的**非正规经济**相关数据,共计**94477条观测样本**,仅包含**1项核心指标**。 ## 数据源说明 **国际劳工组织统计数据库(ILOSTAT)**是国际劳工组织(ILO)的官方核心统计数据库,也是全球领先的劳动统计数据源。其收录涵盖就业、失业、薪资、工作时长、童工、非正规经济、社会保障、职业伤害以及可持续发展目标(SDG)体面工作目标等领域的指标,数据来源包括国家劳动力调查、家庭收入调查、机构调查与行政记录。该数据库覆盖全球200余个经济体,由国际劳工组织统计司负责数据的标准化协调。 - **数据来源**:[ILOSTAT](https://www.ilo.org/shinyapps/bulkexplorer/?id=EES_TEES_SEX_IFL_EC2_NB) - **发布方**:国际劳工组织(ILO) - **许可证**:[CC-BY-4.0](https://creativecommons.org/licenses/by/4.0/) - **研究主题**:非正规经济 ## 数据处理方法 本数据集直接从ILOSTAT的REST API接口`https://rplumber.ilo.org/data/indicator?id=EES_TEES_SEX_IFL_EC2_NB`拉取数据,并筛选出亚洲地区的ISO 3166-1 alpha-3国家代码对应的样本。ILOSTAT采用国际劳工统计学家会议(ICLS)的定义对原始调查微观数据进行标准化处理;数据来源将在`source.label`字段中标记,以保证可追溯性。 ## 地理覆盖范围 覆盖27个亚洲国家,以下按样本行数排序展示部分国家: | 国家(ISO代码) | 样本行数 | 起始年份 | 截止年份 | |---------|-----:|-----------:|----------:| | `TUR` | 14,840 | 2004 | 2024 | | `VNM` | 10,535 | 2007 | 2024 | | `LKA` | 7,830 | 2010 | 2024 | | `MNG` | 7,705 | 2006 | 2024 | | `THA` | 7,009 | 2014 | 2024 | | `IND` | 6,885 | 2010 | 2025 | | `PSE` | 6,618 | 2010 | 2025 | | `KGZ` | 6,601 | 2012 | 2023 | | `PAK` | 5,109 | 2009 | 2025 | | `BRN` | 3,431 | 2014 | 2024 | | `JOR` | 3,232 | 2017 | 2023 | | `BGD` | 3,229 | 2010 | 2024 | | `GEO` | 3,072 | 2019 | 2024 | | `MMR` | 2,360 | 2015 | 2020 | | `IDN` | 779 | 2023 | 2023 | | ... | _另有12个国家_ | | | ## 指标(示例) - `EES_TEES_SEX_IFL_EC2_NB` — 分性别、非正规/正规就业与经济活动的雇员——ISIC二级分类(千人) ## 数据字段结构 | 字段名 | 数据类型 | 字段说明 | 示例 | |--------|------|-------------|---------| | `ref_area` | 字符串 | ISO 3166-1 alpha-3国家代码 | `AFG` | | `ref_area.label` | 字符串 | 英文国家名称 | `阿富汗` | | `source` | 字符串 | ILOSTAT来源代码(例如劳动力调查) | `BA:15715` | | `source.label` | 字符串 | 英文来源名称 | `LFS - 劳动力调查` | | `indicator` | 字符串 | ILOSTAT指标代码 | `EES_TEES_SEX_IFL_EC2_NB` | | `indicator.label` | 字符串 | 英文指标名称 | `分性别、非正规/正规就业与经济活动的雇员……` | | `sex` | 字符串 | 性别分组(SEX_T=总计,SEX_M=男性,SEX_F=女性) | `SEX_T` | | `sex.label` | 字符串 | 性别分组中文名称 | `总计` | | `classif1` | 字符串 | 第一分类变量(年龄、教育程度、就业身份等) | `IFL_NATURE_TOTAL` | | `classif1.label` | 字符串 | 第一分类变量中文名称 | `就业性质:总计` | | `classif2` | 字符串 | 第二分类变量(如适用) | `EC2_ISIC4_TOTAL` | | `classif2.label` | 字符串 | 第二分类变量中文名称 | `经济活动(ISIC修订版4),2位分类……` | | `time` | 64位整数 | 观测年份 | `2021` | | `obs_value` | 64位浮点数 | 观测指标值(单位详见指标定义) | `1709.649` | | `obs_status` | 字符串 | 观测状态标记(例如暂定、不可靠) | `U` | | `obs_status.label` | 字符串 | 观测状态中文说明 | `不可靠` | | `note_indicator` | 字符串 | 指标相关备注 | `I11:264` | | `note_indicator.label` | 字符串 | 指标备注中文说明 | `序列中断:方法学修订` | | `note_source` | 字符串 | 来源相关备注 | `R1:3513_S3:8` | | `note_source.label` | 字符串 | 来源备注中文说明 | `存储库:国际劳工组织统计数据库-微观数据……` | ## 数据细分维度 以下字段提供数据细分维度: - **`sex`**(共4种唯一取值):`SEX_T`、`SEX_M`、`SEX_F`、`SEX_O` ## 数据质量与注意事项 - 本数据集采用年度频率数据。部分指标另有月度或季度序列,此类数据未包含在本数据集中。 - 若同一国家×年份的同一指标存在多个数据来源,将采用国际劳工组织选定的“最优来源”数据。 - 仅当指标支持对应细分维度时,细分字段(`sex`、`classif1`、`classif2`)才不会为空值。 ## 使用示例 python from datasets import load_dataset # 加载数据集 ds = load_dataset("electricsheepasia/asia-ilo-ees-tees-sex-ifl-ec2-nb-employees-by-sex-informal-formal-job-and-economic") # 转换为Pandas数据框 df = ds["train"].to_pandas() # 打印前5条样本 print(df.head()) ### 筛选单个国家数据 python # 筛选印度尼西亚数据 indonesia = df[df["ref_area"] == "IDN"] ### 单个指标的时间序列可视化 python # 筛选目标指标并按年份排序 sample = (df[df["indicator"] == "EES_TEES_SEX_IFL_EC2_NB"] .sort_values("time")) # 绘制时间序列折线图 sample.plot(x="time", y="obs_value", title="EES_TEES_SEX_IFL_EC2_NB") ### 转换为国家×年份矩阵 python # 转换为以年份为行、国家为列的矩阵 matrix = (df[df["indicator"] == "EES_TEES_SEX_IFL_EC2_NB"] .pivot_table(index="time", columns="ref_area", values="obs_value")) # 打印最后5条数据 print(matrix.tail()) ## 引用格式 bibtex @misc{asia_ilo_ees_tees_sex_ifl_ec2_nb_employees_by_sex_informal_formal_job_and_economic_2025, title = {分性别、非正规/正规就业与经济活动的雇员——ISIC二级分类(千人) | 亚洲(ILOSTAT)}, author = {国际劳工组织(ILO)}, year = {2025}, url = {https://www.ilo.org/shinyapps/bulkexplorer/?id=EES_TEES_SEX_IFL_EC2_NB}, publisher = {HuggingFace Datasets, 由Electric Sheep Asia重新整理发布}, howpublished = {url{https://huggingface.co/datasets/electricsheepasia/asia-ilo-ees-tees-sex-ifl-ec2-nb-employees-by-sex-informal-formal-job-and-economic}} } ## 许可证 本数据集采用[CC-BY-4.0](https://creativecommons.org/licenses/by/4.0/)许可证发布。原始数据版权归国际劳工组织(ILO)所有。使用本数据集时,请同时引用上述原始数据源与Electric Sheep Asia的重新整理版本。 ## 关于Electric Sheep Electric Sheep Asia是Electric Sheep项目的组成部分,该项目旨在HuggingFace平台上构建统一的、可供机器学习直接使用的亚洲地区数据层。我们从权威开放数据源拉取数据,对数据schema进行标准化处理,以Parquet格式打包,并发布格式统一的数据集卡片,使研究人员与开发者可通过`load_dataset()`函数在数秒内启动数据分析工作。 浏览完整数据集集合:[huggingface.co/electricsheepasia](https://huggingface.co/electricsheepasia) --- _数据溯源:2026年5月26日通过Electric Sheep数据管道获取。源数据链接:https://www.ilo.org/shinyapps/bulkexplorer/?id=EES_TEES_SEX_IFL_EC2_NB_