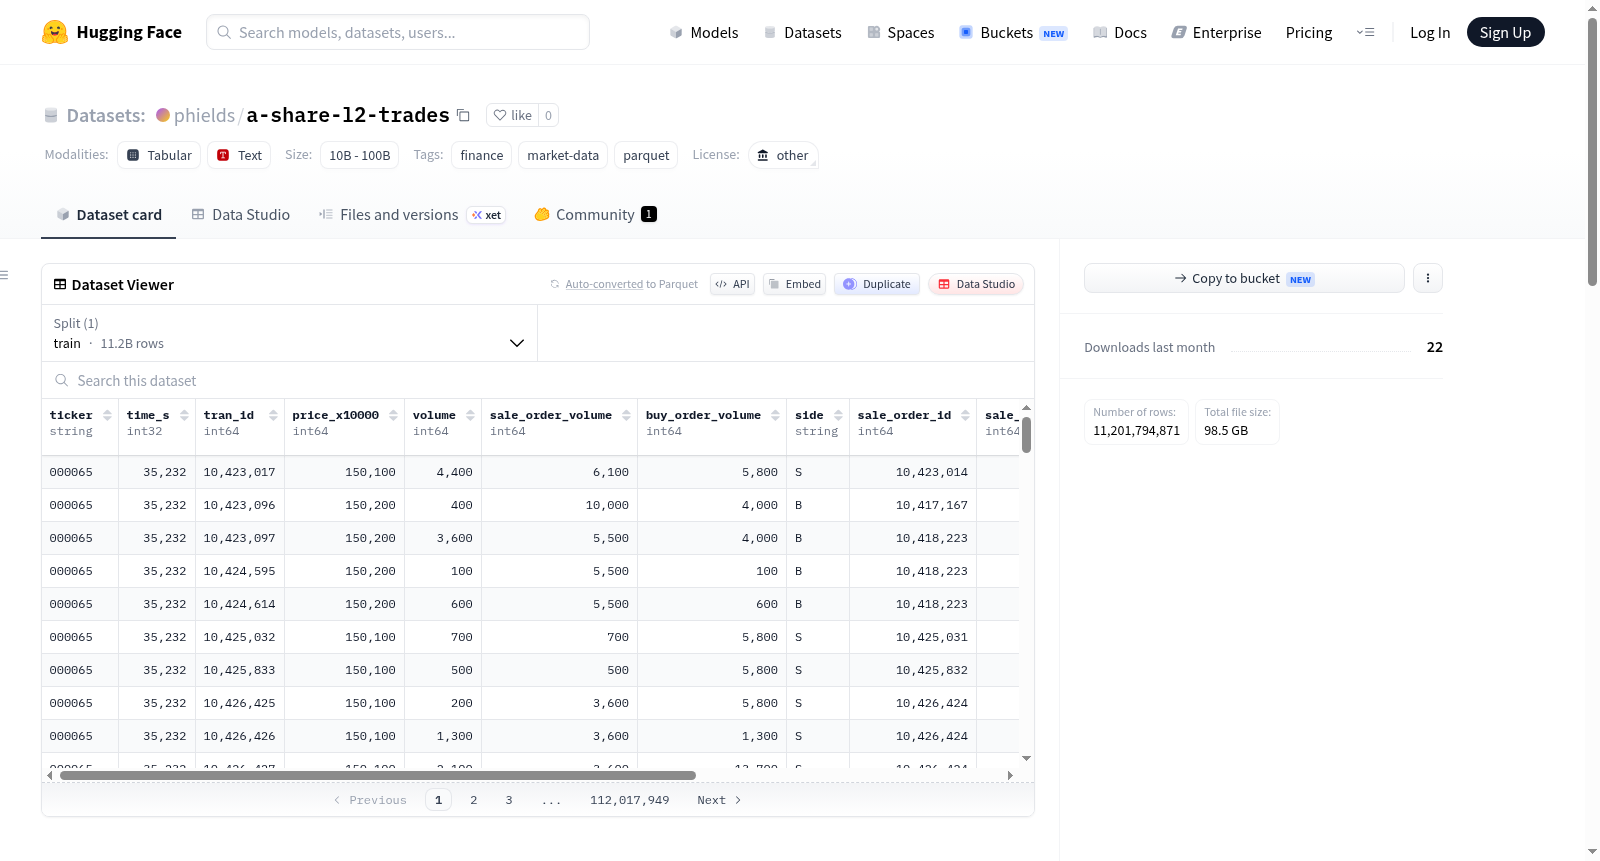
a-share-l2-trades
收藏资源简介:
该数据集是中国A股市场Level 2交易记录的规范数据集,以单一事实表形式存储。数据集覆盖2026年4月1日至2026年7月10日期间,包含65个交易日,总计10,689,329,078行交易记录,存储为467个Parquet文件,压缩后本地大小为87.52 GiB。数据采用Hive分区格式组织,按交易日(trade_date)和股票代码前缀(code_prefix)进行分区,其中code_prefix取股票代码的前两位字符。数据包含12个核心字段:股票代码(ticker)、时间戳(time_s)、交易ID(tran_id)、价格(price_x10000,需除以10000得到实际价格)、成交量(volume)、卖方订单量(sale_order_volume)、买方订单量(buy_order_volume)、交易方向(side)、卖方订单ID(sale_order_id)、卖方订单价格(sale_order_price_x10000)、买方订单ID(buy_order_id)和买方订单价格(buy_order_price_x10000)。数据集还提供三个元数据文件:每日清单(daily_manifest.parquet)、股票日历(ticker_calendar.parquet)和模式定义(schema.json)。该数据集适用于金融市场分析、高频交易研究、算法交易策略开发等金融科技应用场景。
This dataset is a standardized dataset of Level 2 trading records for the Chinese A-share market, stored as a single fact table. Covering the period from April 1, 2026 to July 10, 2026, it includes 65 trading days and a total of 10,689,329,078 trading records. The data is stored in 467 Parquet files, with a compressed local size of 87.52 GiB. Organized in Hive partitioned format, the data is partitioned by trading date (trade_date) and stock code prefix (code_prefix), where code_prefix is the first two characters of the stock code. The dataset contains 12 core fields: ticker, time_s, tran_id, price_x10000 (actual price is obtained by dividing the value by 10000), volume, sale_order_volume, buy_order_volume, side, sale_order_id, sale_order_price_x10000, buy_order_id, and buy_order_price_x10000. Additionally, the dataset provides three metadata files: daily_manifest.parquet (daily manifest), ticker_calendar.parquet (stock calendar), and schema.json (schema definition). This dataset is suitable for fintech application scenarios such as financial market analysis, high-frequency trading research, and algorithmic trading strategy development.
数据集概述
- 名称:China A-share Level 2 Trades
- 许可证:其他(需自行确认合规性)
- 标签:金融、市场数据、Parquet格式
- 数据集类型:中国A股二级市场逐笔成交记录,以事实表形式存储
数据覆盖范围
- 日期范围:2026-04-01 至 2026-07-10
- 交易日数:65天
- 总行数:10,689,329,078
- Parquet文件数量:467个
- 压缩后本地存储大小:87.52 GiB
数据存储与分区布局
- 目录结构:
data/l2_trades/trade_date=YYYY-MM-DD/code_prefix=XX/part-00000.parquettrade_date:交易日期(Hive分区列)code_prefix:股票代码前两位(Hive分区列),例如000001 -> 00、300750 -> 30、600519 -> 60、688981 -> 68
- 文件排序:按
ticker、time_s、tran_id排序 - 行组参数:每行组200万行,使用zstd压缩
数据列说明
| 列名 | 类型 | 说明 |
|---|---|---|
ticker |
string | 股票代码 |
time_s |
int32 | 交易时间(秒级) |
tran_id |
int64 | 交易唯一标识 |
price_x10000 |
int64 | 成交价格(乘以10000) |
volume |
int64 | 成交量 |
sale_order_volume |
int64 | 卖单委托量 |
buy_order_volume |
int64 | 买单委托量 |
side |
string | 成交方向 |
sale_order_id |
int64 | 卖单委托编号 |
sale_order_price_x10000 |
int64 | 卖单委托价格(乘以10000) |
buy_order_id |
int64 | 买单委托编号 |
buy_order_price_x10000 |
int64 | 买单委托价格(乘以10000) |
元数据文件
metadata/daily_manifest.parquet:每日清单metadata/ticker_calendar.parquet:包含字段trade_date、ticker、code_prefix、row_count、min_time_s、max_time_smetadata/schema.json:数据模式定义
使用注意事项
- 数据来源为Level 2市场数据
- 用户需自行确认使用方式符合数据供应商、交易所及再分发条款