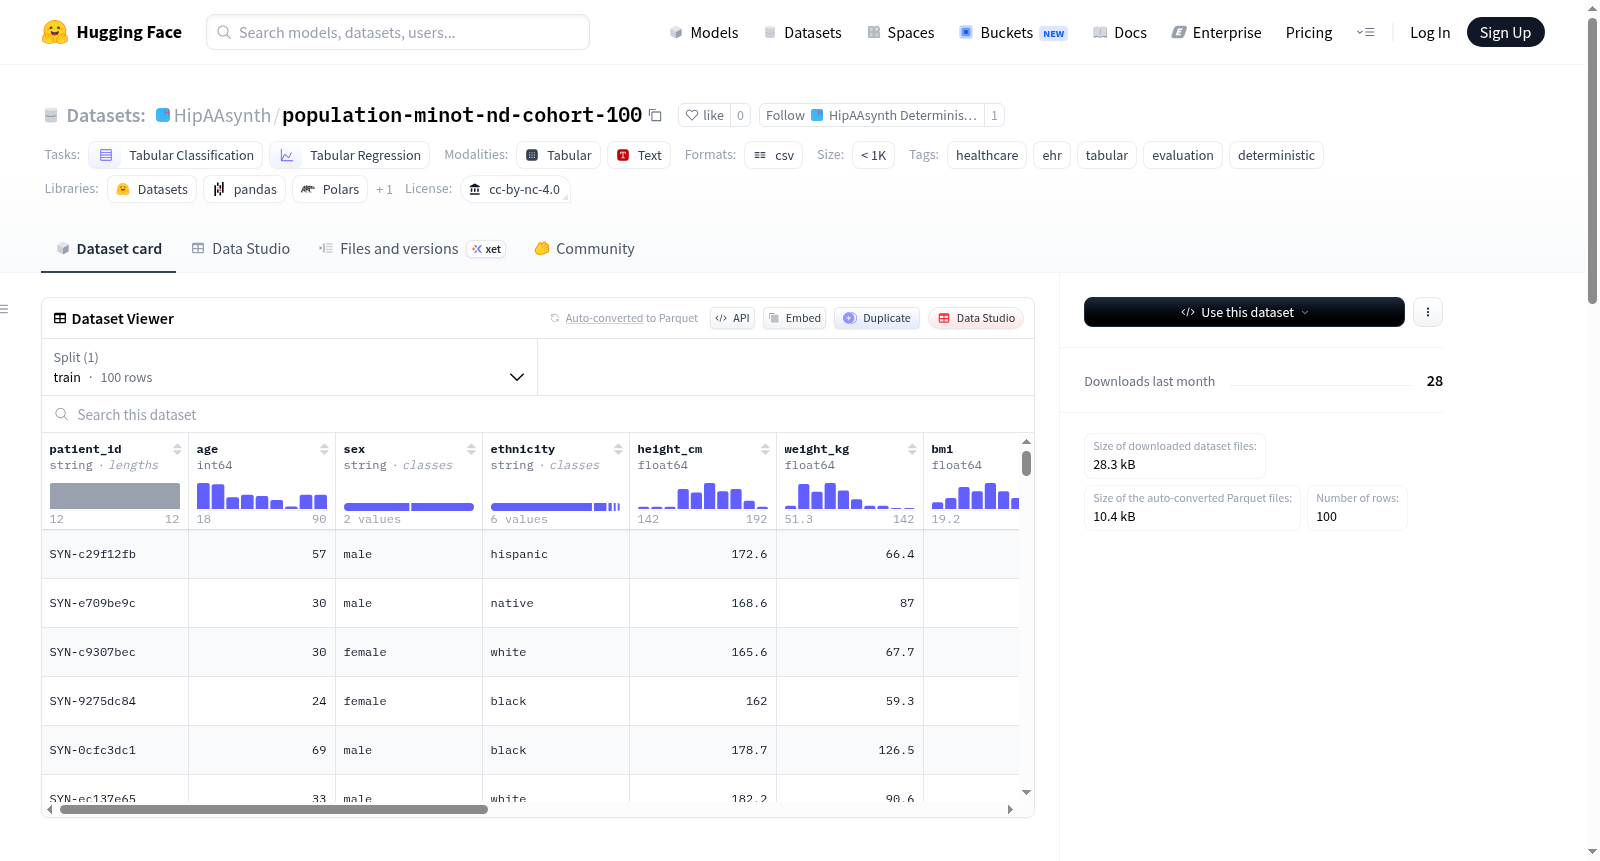
population-minot-nd-cohort-100
收藏资源简介:
HipAAsynth数据集是一个用于验证的合成数据集,由HipAAsynth服务生成。该服务通过确定性方法模拟真实世界中的变异性,用于评估医疗保健系统在部署条件下的表现。数据集代表一个用于测试和基准测试的受控队列,模拟患者群体、人口统计分布和共病模式的表现。数据集采用13列结构化CSV格式,包含患者ID、年龄、性别、种族、身高、体重、BMI、BMI分类、临床条件列表、就诊次数、实验室检查次数等字段。所有数据均为合成数据,不含真实患者信息。该数据集适用于医疗保健领域的表格分类和回归任务评估,特别适合需要可重复测试场景的研究。
The HipAAsynth dataset is a synthetic validation dataset generated by the HipAAsynth service. The service simulates real-world variability via deterministic methods to evaluate the performance of healthcare systems under operational deployment conditions. The dataset constitutes a controlled cohort for testing and benchmarking, which mimics the characteristics of patient populations including their demographic distributions and comorbidity patterns. It is formatted as a structured 13-column CSV file, containing fields such as patient ID, age, gender, ethnicity, height, weight, BMI, BMI category, list of clinical conditions, number of patient visits, number of laboratory tests, and other relevant fields. All data in this dataset is synthetic and contains no real patient information. This dataset is suitable for evaluating tabular classification and regression tasks in the healthcare domain, and is particularly well-suited for research requiring reproducible test scenarios.
数据集概述
基本信息
- 数据集名称: HipAAsynth Dataset
- 版本: 1.0.0
- 许可协议: CC-BY-NC-4.0
- 规模类别: n<1K
- 配置名称: default
- 数据文件: synthetic_minot_nd_sample_100_seed1001.csv (训练集)
任务与标签
- 任务类别: 表格分类、表格回归
- 标签: 医疗保健、电子健康记录、表格数据、评估、确定性
数据集描述
该数据集是由HipAAsynth生成的验证工件。HipAAsynth是一种确定性测试和验证服务,通过模拟真实世界的变异性来评估医疗保健系统在部署条件下的性能。
此数据集代表一个用于测试和基准测试的受控队列。HipAAsynth生成队列以模拟以下方面的状况呈现:
- 患者群体
- 人口统计分布
- 共病模式
数据集专为可重复的评估和跨系统的一致比较而设计。
数据模式
数据集为13列的结构化CSV文件,具体列信息如下:
| 列名 | 描述 |
|---|---|
| patient_id | 唯一患者标识符 |
| age | 年龄(岁) |
| sex | 生理性别 |
| ethnicity | 患者种族 |
| height_cm | 身高(厘米) |
| weight_kg | 体重(千克) |
| bmi | 身体质量指数 |
| bmi_category | BMI分类(体重过轻 / 正常 / 超重 / 肥胖) |
| conditions | 活动性临床状况列表(竖线分隔) |
| num_visits | 总就诊次数 |
| num_labs | 总实验室检查订单数 |
| synthetic | 始终为true — 不含真实患者数据 |
| disclaimer | 数据使用免责声明 |