
us-caselaw-ak
收藏官方服务:
资源简介:
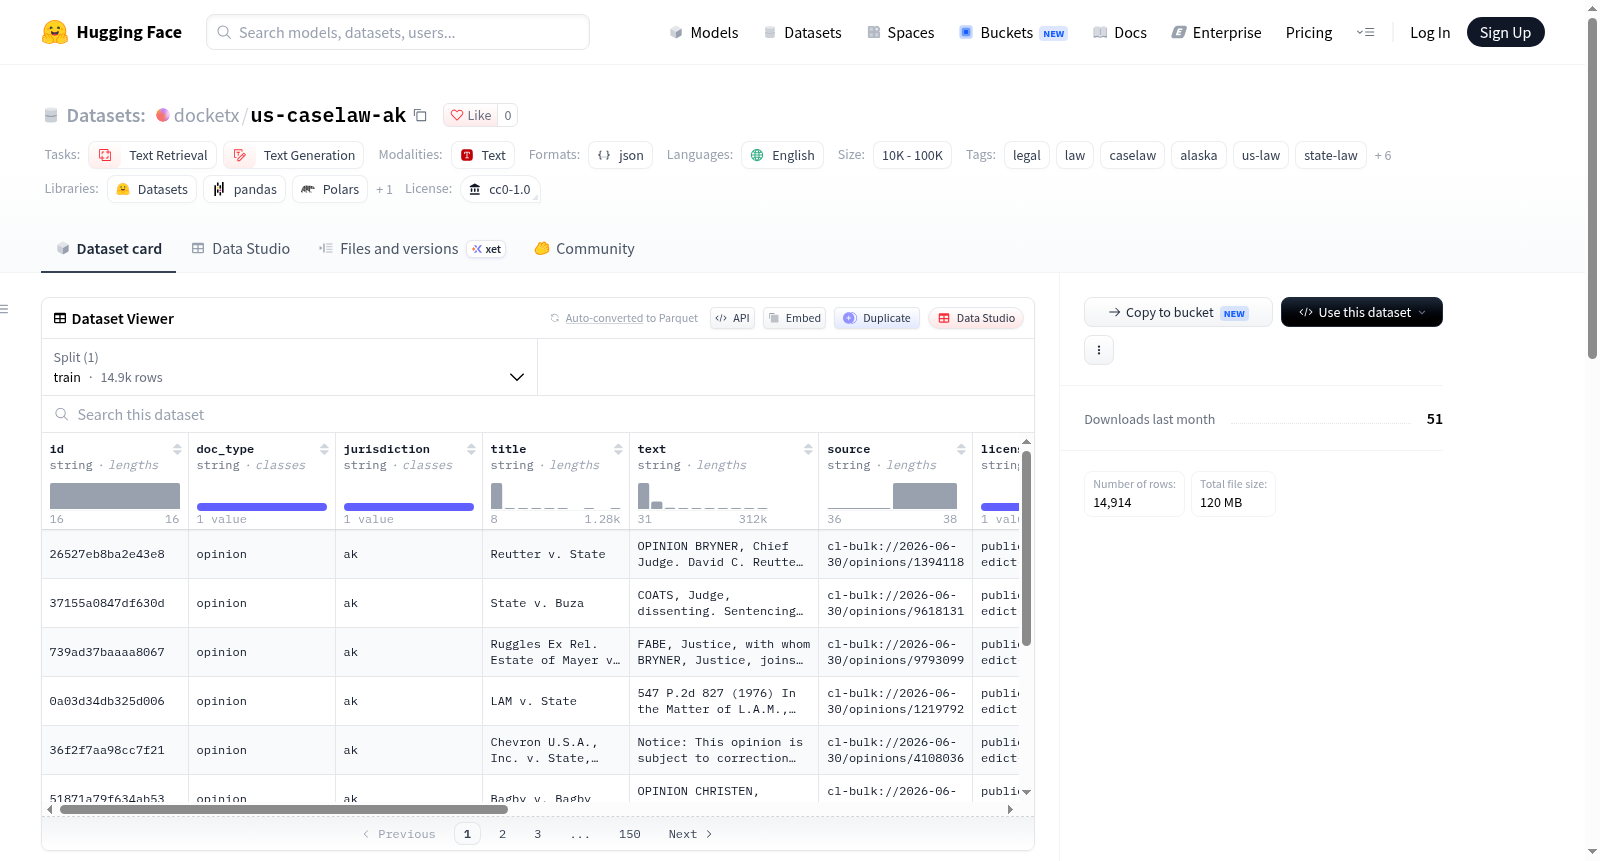
该数据集名为“阿拉斯加判例法”(Alaska Case Law),包含从公共记录中提取的14,914份阿拉斯加上诉意见全文。数据来源于 Free Law Project / CourtListener 在2026年6月30日的批量导出,覆盖两个法院(阿拉斯加最高法院和阿拉斯加上诉法院)。数据集包含了主要意见和单独意见,并排除了长度小于1个字符的文档。为确保公共记录的完整性,短暂文档(如拒绝调卷令、一行命令和判决条目)被刻意保留。数据格式采用统一的 docketx record v1 模式,每个意见一行,包含以下字段:id、doc_type、jurisdiction、title、text、source、license、retrieved_at,以及 citation、court、date 和 extra(包含 CourtListener 意见/案件簇 ID 和意见类型)。该数据集可用于法律文本检索、生成、RAG(检索增强生成)、法律 NLP 研究和法律研究等任务。所有司法意见作为政府法令属于公共领域,数据打包以 CC0 1.0 许可发布,不添加任何注释,不主张任何权利。
创建时间:
2026-09-06
搜集汇总
数据集介绍
构建方式
本数据集立足于美国阿拉斯加上诉法院公开裁判文书的完整汇编,其构建遵循可溯源与最小干预原则。具体而言,研究团队自Free Law Project旗下的CourtListener批量导出文件中,以2026年6月30日为时间切片,采用显式白名单方式精准选取法院标识为“alaska”与“alaskactapp”的文书,排除前缀匹配可能引入的噪声,最终获得14,914份上诉意见书全文。每份记录均剔除正文不足1字符的异常文档,同时保留主意见与独立意见,并生成SHA-256校验值以确保切片完整性,从而在源头上保障了数据集合的权威性与可复现性。
使用方法
在应用层面,使用者可借助Hugging Face Datasets库以一行代码加载全部数据,即调用load_dataset("docketx/us-caselaw-ak")即可获得标准化的数据集对象。加载后,研究者可根据文本长度字段进行筛选,若需聚焦实质性裁判意见,可保留字符数超过2,000的文档;若旨在考察司法文书的完整生态,则可保留全部记录。该数据集适用于文本检索、文本生成、法律信息抽取与检索增强生成等任务,亦可作为法律自然语言处理领域预训练或微调的语料来源。使用时建议遵循来源标注惯例,结合slice.manifest.json中的校验信息确保数据版本一致。
背景与挑战
背景概述
法律判例文本的可计算化利用,素来是法律信息学与自然语言处理交叉领域的关键议题。阿拉斯加判例法数据集(us-caselaw-ak)由DocketRouter项目团队构建,于2026年自Free Law Project的CourtListener批量导出中切片而成,涵盖阿拉斯加上诉法院与阿拉斯加上诉法院的14,914份公开裁判文书。该数据集以docketx记录格式统一封装,旨在为法律检索、文本生成及检索增强生成等任务提供权威、完整的州级判例语料,其公共领域属性与开放许可为法律NLP研究扫清了版权障碍,对推动判例法语义检索和司法裁判预测具有基础性意义。
当前挑战
该数据集所应对的领域问题,在于从卷帙浩繁且格式驳杂的司法文书中实现判例法的高效检索与语义理解,其核心挑战包括裁判文书的长文本建模、法律术语的领域适应性,以及判例间引用关系的精准映射。构建过程中则面临多重现实困难:原始导出数据包含大量简短记录,如调卷令驳回与单行命令,需在保持公共记录完整性与筛选实质性意见之间取得平衡;州级法院标识须以显式白名单精确匹配,避免前缀误关联;跨来源文书的结构化统一亦要求严格的格式规范与溯源校验,以确保数据在异构法律语料间的互操作性和可复现性。
常用场景
经典使用场景
在法律信息检索与自然语言处理的交叉领域中,判例法文本的获取与结构化始终是构筑可靠研究基线的先决条件。us-caselaw-ak数据集汇聚了阿拉斯加上诉法院与阿拉斯加上诉法院(阿拉斯加上诉法院)两个具有明确管辖标识的司法机构所发布的14,914份上诉意见全文,涵盖主意见与独立意见,完整保留了从篇幅短小的调卷令驳回令到长篇论证判决在内的公共记录。该数据集最经典的使用场景在于支撑法律文本检索与生成任务,研究者可依托其规范化的docketx记录格式,开展判例相似性检索、判决要旨抽取以及面向法律问答的检索增强生成系统构建,从而在真实且完整的州级判例语料上验证方法有效性。
解决学术问题
长期以来,法律自然语言处理研究受困于高质量、可自由使用的判例语料稀缺,尤其在州级司法层面,公开数据的碎片化与授权限制使得跨机构、跨审级的实证研究难以复现。us-caselaw-ak以明确的法院白名单机制杜绝前缀匹配带来的数据污染,并以最小字符阈值保留全部公共记录,从而为学术共同体提供了一个边界清晰、来源可溯且完全处于公有领域的判例语料库。该数据集有效缓解了法律检索模型评估中基准缺失的问题,使得关于判决文本分类、引用网络分析与法律论证生成的探讨得以建立在一致且可审计的数据基础之上,对推动法律信息学的可复现研究具有实质意义。
实际应用
在实务层面,该数据集为法律科技产品与公共法律服务提供了可直接落地的语料支撑。律所与法律检索平台可利用其构建面向阿拉斯加辖区的判例搜索引擎,辅助律师快速定位相关先例;法律援助机构可借助检索增强生成技术,将冗长的判决文本转化为易于理解的摘要与问答,降低公众获取司法知识的门槛。与此同时,该数据集采用的docketx统一记录格式便于与其他司法辖区的判例语料进行横向整合,为跨州法律比较、合规风险监测以及司法数据分析等应用场景提供了标准化的数据接口。
数据集最近研究
最新研究方向
在司法裁判文书公开化与法律人工智能深度融合的背景下,阿拉斯加上诉判例数据集(us-caselaw-ak)为法律信息检索与生成任务提供了稀缺的州级司法语料。当前前沿研究聚焦于检索增强生成(RAG)框架下的判例法问答系统构建,借助该数据集完整收录的14,914份上诉意见书,研究者得以在低资源司法管辖区开展跨法院层级的法律推理实验。与此同时,判例引证网络分析与判决结果预测等任务亦因该数据集的公开而获得可复现的基准支撑,其CC0许可与公共领域属性进一步推动了法律语料的开放科学实践,对促进司法透明与智能法律服务均具有深远的规范意义与技术价值。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


