
遇见数据集

FBK-MT/GeNTE

收藏
Hugging Face2025-01-20 更新2024-05-25 收录
官方服务:

资源简介:

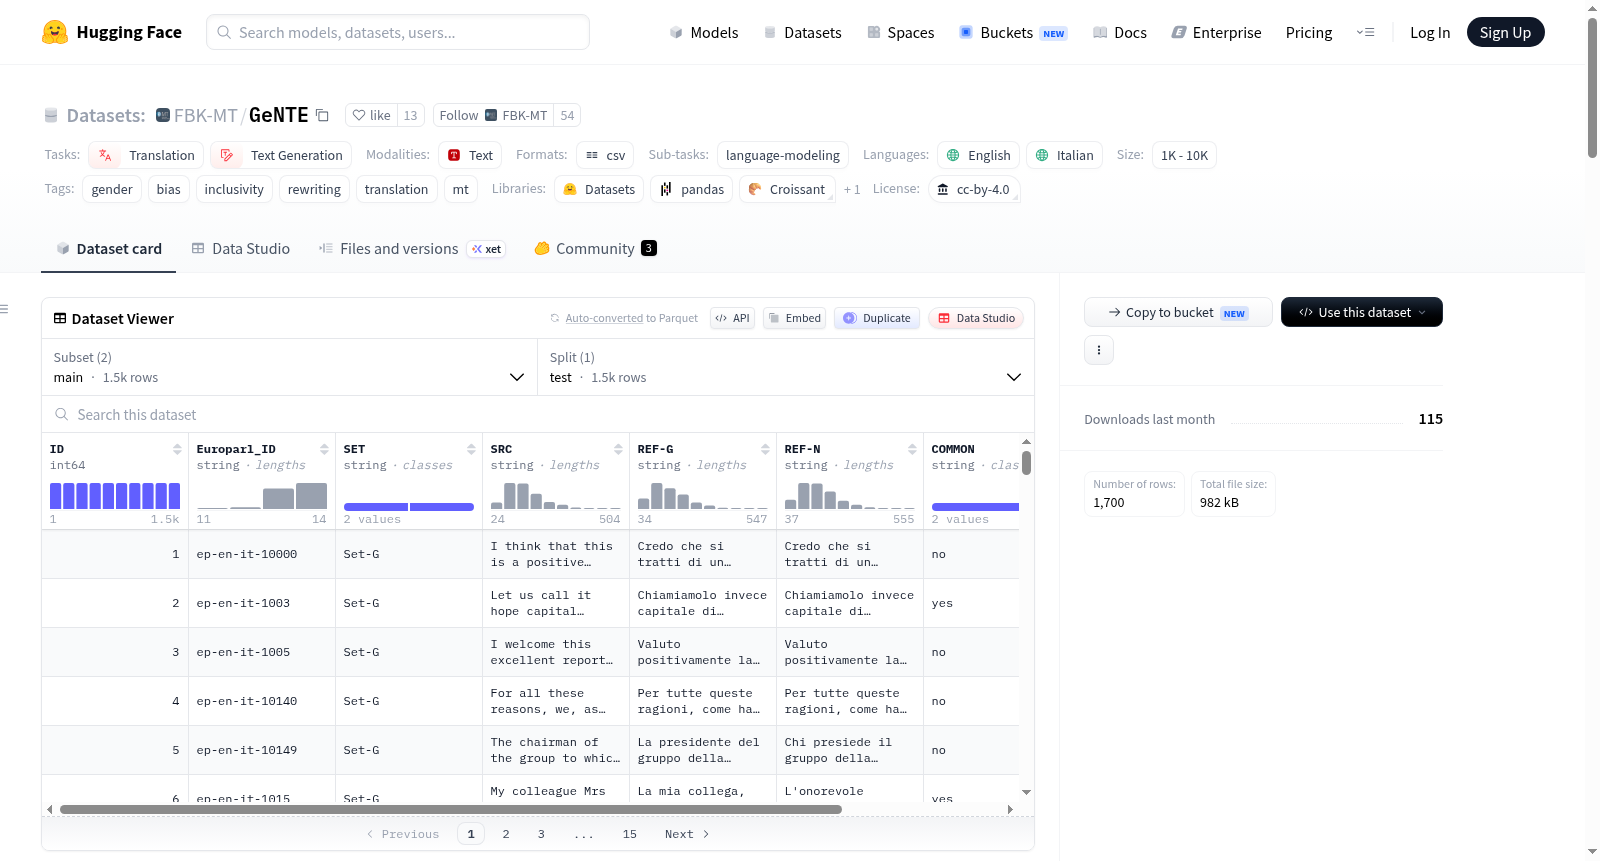
GeNTE(性别中立翻译评估)是一个自然双语语料库,旨在评估机器翻译系统生成性别中立翻译的能力。该数据集基于欧洲议会演讲的Europarl语料库,包含1500个平行句子,并进行了人工注释。数据集分为两个子集:Set-N(需要性别中立翻译的句子)和Set-G(需要性别化翻译的句子)。数据集支持跨语言(英语-意大利语)和语内(意大利语-意大利语)的性别包容翻译任务。

GeNTE(性别中立翻译评估)是一个自然双语语料库,旨在评估机器翻译系统生成性别中立翻译的能力。该数据集基于欧洲议会演讲的Europarl语料库,包含1500个平行句子,并进行了人工注释。数据集分为两个子集:Set-N(需要性别中立翻译的句子)和Set-G(需要性别化翻译的句子)。数据集支持跨语言(英语-意大利语)和语内(意大利语-意大利语)的性别包容翻译任务。

提供机构:
FBK-MT
原始信息汇总

数据集概述

名称: GeNTE: Gender-Neutral Translation Evaluation

描述: GeNTE是一个双语自然语言数据集,旨在评估机器翻译系统生成性别中性翻译的能力。该数据集基于欧洲议会的演讲,包含1500个平行句,分为性别中性翻译(set-N)和目标语言中性别化翻译(set-G)两部分。

数据集结构

配置类型:

  • main: 包含完整的GeNTE语料库及其设置注释。
  • common: 包含GeNTE语料库的子集,提供3种性别中性参考翻译。

数据文件:

  • GeNTE.tsv: 包含8个字段,如ID、Europarl_ID、SET、SRC、REF-G、REF-N、COMMON、GENDER。
  • GeNTE_common.tsv: 包含9个字段,如ID、Europarl_ID、SET、SRC、REF-G、REF-N1、REF-N2、REF-N3、GENDER。

数据集内容

语言: 英语(en)和意大利语(it)

许可证: CC-BY-4.0

任务类别: 翻译、文本生成

标签: 性别、偏见、包容性、重写、翻译、机器翻译

数据集创建

源数据: 从Europarl语料库(common test set 2)提取和编辑的文本数据。

注释: 每个句子对包含一个额外的意大利语参考,使用中性表达方式指代人类实体。

数据集策划者:

  • Beatrice Savoldi (FBK): bsavoldi@fbk.eu
  • Luisa Bentivogli (FBK): bentivo@fbk.eu
  • Andrea Piergentili (FBK): apiergentili@fbk.eu

引用信息

bibtex @inproceedings{piergentili-etal-2023-hi, title = "Hi Guys or Hi Folks? Benchmarking Gender-Neutral Machine Translation with the {G}e{NTE} Corpus", author = "Piergentili, Andrea and Savoldi, Beatrice and Fucci, Dennis and Negri, Matteo and Bentivogli, Luisa", editor = "Bouamor, Houda and Pino, Juan and Bali, Kalika", booktitle = "Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing", month = dec, year = "2023", address = "Singapore", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2023.emnlp-main.873", doi = "10.18653/v1/2023.emnlp-main.873", pages = "14124--14140" }
搜集汇总
数据集介绍
FBK-MT/GeNTE 数据集图片
构建方式
GeNTE(Gender-Neutral Translation Evaluation)语料库从欧洲议会演讲中提取,基于Europarl语料库的英意平行句对精心构建。数据集包含1500个平行句,由专业翻译人员依据明确的性别中立翻译指南进行人工注释,确保翻译现象均衡分布。语料分为Set-N和Set-G两个子集:Set-N收录性别模糊的源语句,需在译文中实现中性表达;Set-G则包含性别明确的源语句,要求译文恰当地使用阳性或阴性形式。这种设计旨在为机器翻译系统提供评估性别中立翻译能力的标准化基准。
特点
该数据集的核心特点在于其双语自然语料属性与精细的注释结构。每个样本均包含英语源句、原始意大利语参考译文以及专业译员提供的性别中立参考译文。数据集的独特之处在于提供了两种配置:主配置(main)包含完整语料及集合标注;公共配置(common)则包含200个句子的三种替代性性别中立参考译文,为评估提供多维度基准。此外,数据集还标注了每句所属集合类型及性别属性,支持细粒度的翻译现象分析。
使用方法
GeNTE支持跨语言(英-意)和语内(意-意)的性别包容性翻译任务评估。研究人员可利用Hugging Face平台上的专用分类器FBK-MT/GeNTE-evaluator自动评估译文性别中立性,或参考配套代码库fbk-NEUTR-evAL进行深入分析。数据集以TSV格式提供,包含ID、源句、参考译文等字段,便于直接加载至标准数据处理流程。建议使用者注意,该数据集已被更新的多语言版本mGeNTE所替代,新研究应优先采用扩充版语料库。
背景与挑战
背景概述
GeNTE(Gender-Neutral Translation Evaluation)语料库由意大利布鲁诺·凯斯勒基金会(FBK)的研究团队于2023年创建,旨在系统性地评估机器翻译系统在性别中立翻译场景下的表现。该语料库从欧洲议会演讲的英意双语平行语料Europarl中精心筛选出1500个句子对,并依据翻译需求将其划分为两类:Set-N(需要生成性别中立译文的源句)与Set-G(需保留性别信息的源句)。研究团队通过专业译者手工标注,为每个句子提供了性别中立与性别化两种参考译文,从而构建了一个兼具自然性与平衡性的评测基准。GeNTE的提出填补了机器翻译性别公平性评估领域的空白,其论文发表于EMNLP 2023,并迅速成为该方向的重要参考资源,后续催生了多语扩展版本mGeNTE。
当前挑战
GeNTE所解决的领域挑战在于机器翻译中性别信息的过度泛化问题:当源语言中的指代对象性别不明或无关紧要时,系统常基于统计偏见错误地推断性别,造成歧视性输出;而当性别信息明确时,系统又可能不当采用中性化策略,导致信息失真。在语料库构建过程中,团队面临两大挑战:其一,从大规模议会语料中精准识别出那些同时满足性别模糊性(Set-N)与性别明确性(Set-G)条件的句子,需兼顾语言现象的代表性与分布均衡性;其二,设计一套可操作的性别中立翻译指南,确保多位专业译者在改写参考译文时既能消除性别标记,又能保持语义自然流畅,避免因人为干预引入新的偏差。
常用场景
经典使用场景
GeNTE数据集的核心用途在于评估机器翻译系统在性别中性翻译任务上的表现,尤其聚焦于英语到意大利语的跨语言翻译场景。该数据集精心选取了欧洲议会演讲中的平行语料,并划分为两类关键测试集:Set-N要求模型在源语言性别模糊时生成中性译文,而Set-G则检验模型在性别明确时能否正确使用阳性和阴性形式。通过对比模型输出与专家标注的性别中性和性别化参考译文,研究者能够系统性地量化翻译系统在处理性别信息时的偏差程度与中性化能力。
实际应用
在实际应用层面,GeNTE为开发更包容的翻译工具提供了关键测试基准。例如,在公共服务、法律文件和职场沟通等需要避免性别偏见的场景中,翻译系统可借助该数据集进行针对性优化,确保对‘chairperson’或‘folks’等中性表述的准确转换。此外,该数据集也支持意大利语内部的性别中性改写任务,帮助内容创作者生成符合现代包容性语言规范的文本,减少对特定性别的隐性预设。
衍生相关工作
GeNTE的发布催生了一系列重要后续工作,包括其多语言扩展版本mGeNTE,将评估范围扩展至更多语言对。基于该数据集,研究者开发了专用性别中性分类器GeNTE-evaluator,实现了自动化的翻译质量评估。在学术论文方面,Piergentili等人(2023)在EMNLP上提出了基准测试框架,Savoldi等人(2024)在EACL上探索了基于提示的性别中性翻译方法,而Attanasio等人(2024)将其整合进意大利语综合评估基准ItaEval中,显著推动了性别公平语言生成领域的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

