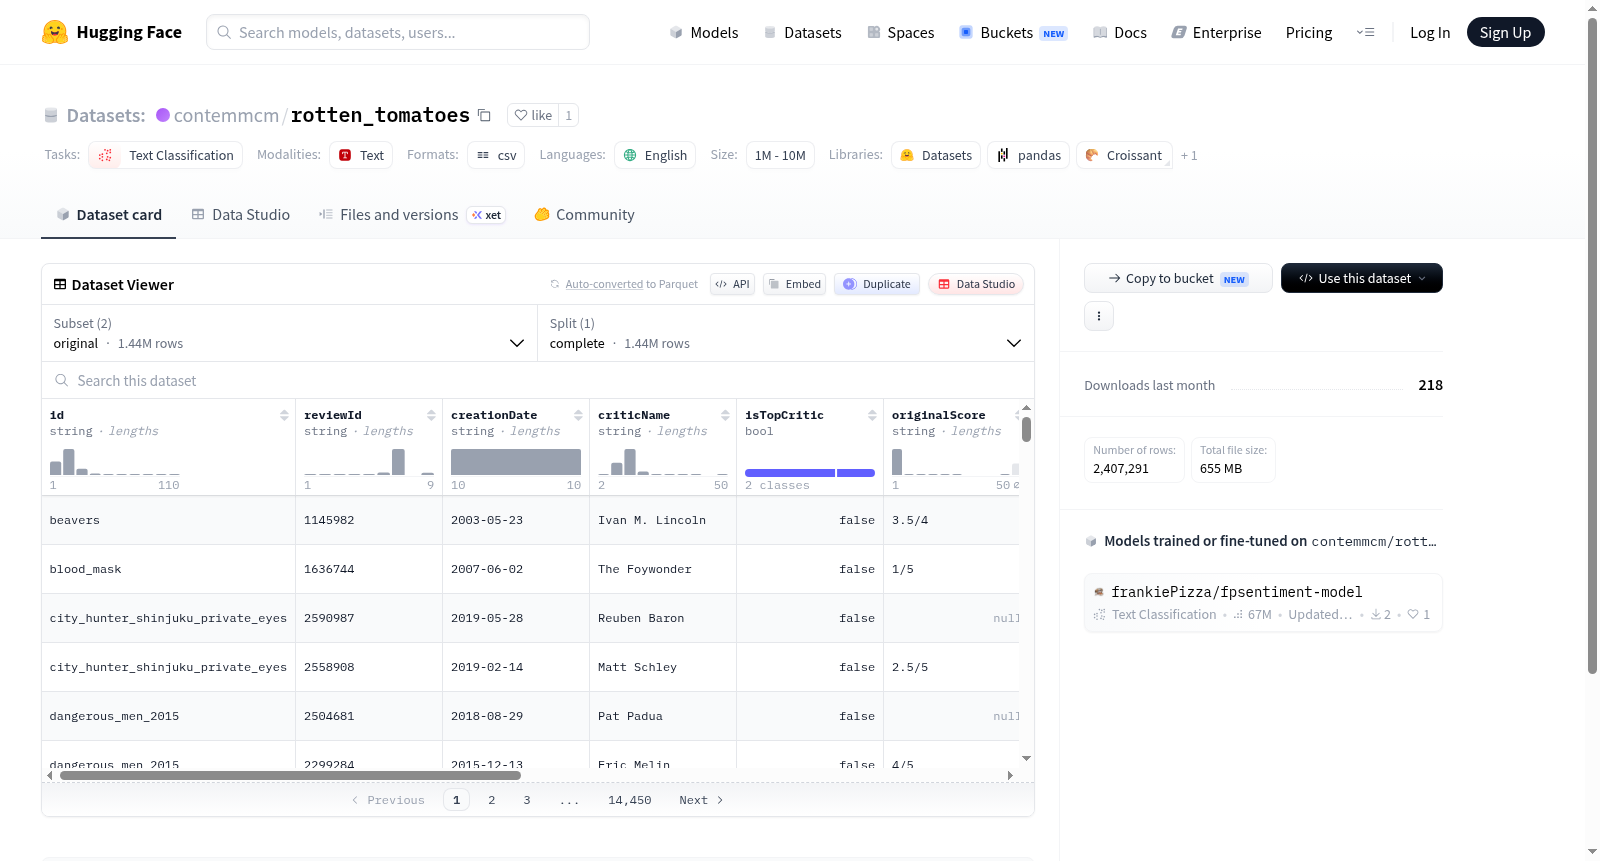
contemmcm/rotten_tomatoes
收藏资源简介:
--- language: - en task_categories: - text-classification dataset_info: - config_name: original features: - name: id dtype: string - name: reviewId dtype: string - name: creationDate dtype: string - name: criticName dtype: string - name: isTopCritic dtype: bool - name: originalScore dtype: string - name: reviewState dtype: class_label: names: '0': 'rotten' '1': 'fresh' - name: publicatioName dtype: string - name: reviewText dtype: string - name: scoreSentiment dtype: class_label: names: '0': Negative '1': Positive - name: reviewUrl dtype: string - config_name: balanced features: - name: id dtype: string - name: reviewId dtype: string - name: creationDate dtype: string - name: criticName dtype: string - name: isTopCritic dtype: bool - name: originalScore dtype: string - name: reviewState dtype: class_label: names: '0': 'rotten' '1': 'fresh' - name: publicatioName dtype: string - name: reviewText dtype: string - name: scoreSentiment dtype: class_label: names: '0': Negative '1': Positive - name: reviewUrl dtype: string configs: - config_name: original data_files: - split: complete path: "original.csv" default: true - config_name: balanced data_files: - split: complete path: "balanced.csv" ---
语言: - 英语 任务类别: - 文本分类 数据集信息: - 配置名称:原始(original) 特征: - 特征名:id,数据类型:字符串型 - 特征名:reviewId,数据类型:字符串型 - 特征名:creationDate,数据类型:字符串型 - 特征名:criticName,数据类型:字符串型 - 特征名:isTopCritic,数据类型:布尔型 - 特征名:originalScore,数据类型:字符串型 - 特征名:reviewState,数据类型:类别标签,类别映射: '0': 坏评(rotten) '1': 鲜评(fresh) - 特征名:publicatioName,数据类型:字符串型 - 特征名:reviewText,数据类型:字符串型 - 特征名:scoreSentiment,数据类型:类别标签,类别映射: '0': 负向情感(Negative) '1': 正向情感(Positive) - 特征名:reviewUrl,数据类型:字符串型 - 配置名称:均衡(balanced) 特征: - 特征名:id,数据类型:字符串型 - 特征名:reviewId,数据类型:字符串型 - 特征名:creationDate,数据类型:字符串型 - 特征名:criticName,数据类型:字符串型 - 特征名:isTopCritic,数据类型:布尔型 - 特征名:originalScore,数据类型:字符串型 - 特征名:reviewState,数据类型:类别标签,类别映射: '0': 坏评(rotten) '1': 鲜评(fresh) - 特征名:publicatioName,数据类型:字符串型 - 特征名:reviewText,数据类型:字符串型 - 特征名:scoreSentiment,数据类型:类别标签,类别映射: '0': 负向情感(Negative) '1': 正向情感(Positive) - 特征名:reviewUrl,数据类型:字符串型 配置项: - 配置名称:原始(original) 数据文件: - 划分:完整集(complete),路径:"original.csv" 设为默认配置 - 配置名称:均衡(balanced) 数据文件: - 划分:完整集,路径:"balanced.csv"
数据集概述
配置信息
-
原始配置(original)
- 数据文件:
- 完整数据集路径:"original.csv"
- 默认配置:是
- 数据文件:
-
平衡配置(balanced)
- 数据文件:
- 完整数据集路径:"balanced.csv"
- 数据文件:
特征描述
-
通用特征
- id:字符串类型
- reviewId:字符串类型
- creationDate:字符串类型
- criticName:字符串类型
- isTopCritic:布尔类型
- originalScore:字符串类型
- publicatioName:字符串类型
- reviewText:字符串类型
- reviewUrl:字符串类型
-
分类特征
- reviewState:
- 类别标签:
- 0: rotten
- 1: fresh
- 类别标签:
- scoreSentiment:
- 类别标签:
- 0: Negative
- 1: Positive
- 类别标签:
- reviewState: