
DCAgent3/bfcl_parity_rl__24GPU_base_excl_timeouts__exp_rpt_pymethods2test_large__GLM_4_7429ead19
收藏数据链接:
官方服务:
资源简介:
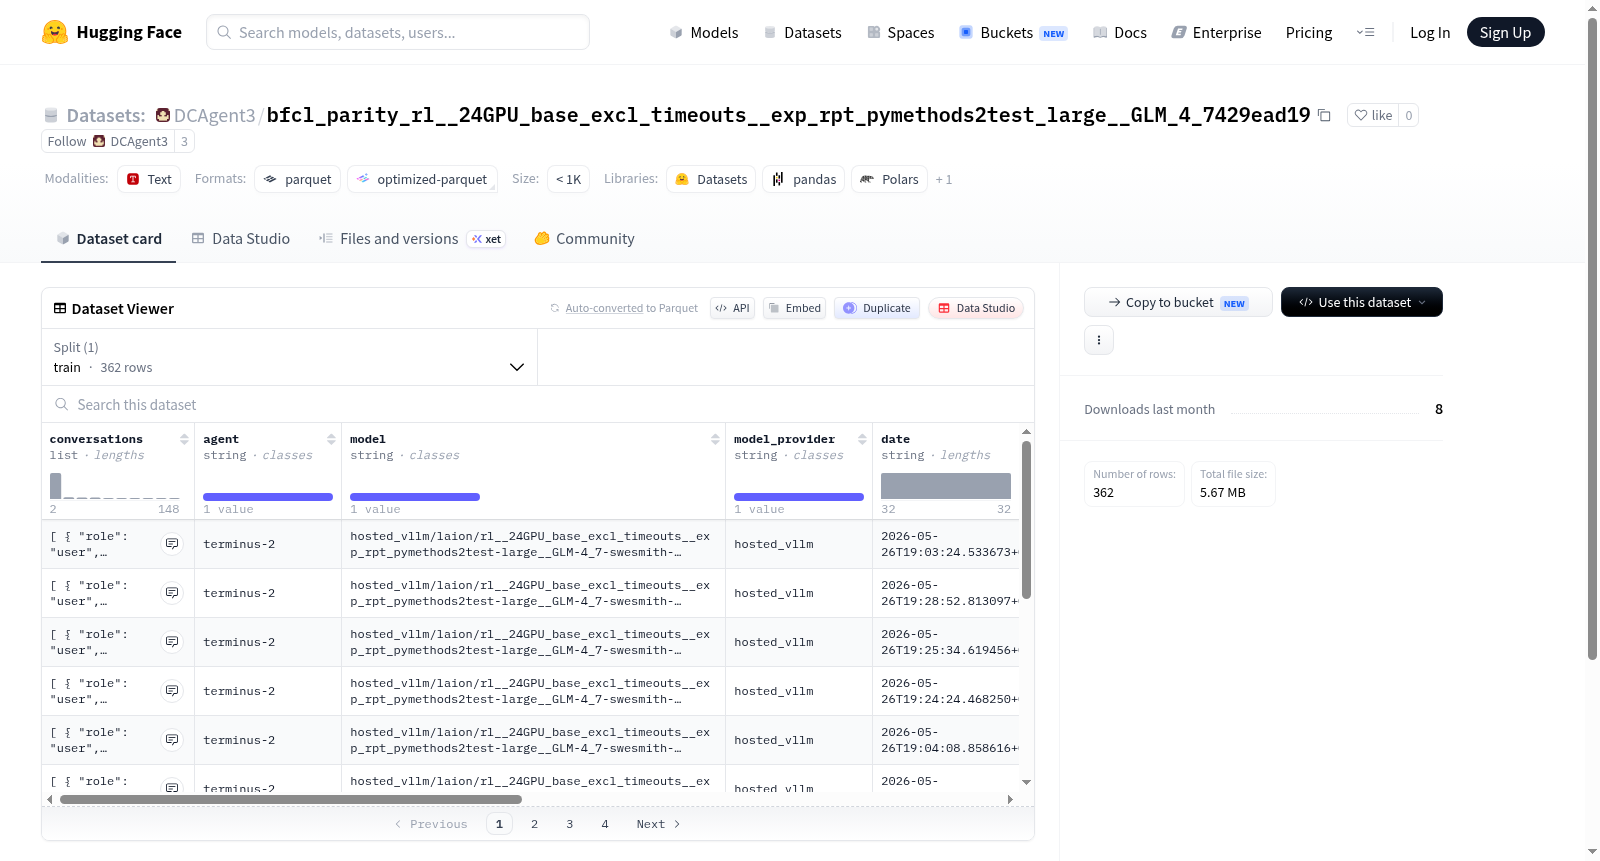
--- dataset_info: features: - name: conversations list: - name: role dtype: string - name: content dtype: string - name: agent dtype: string - name: model dtype: string - name: model_provider dtype: string - name: date dtype: string - name: task dtype: string - name: episode dtype: string - name: run_id dtype: string - name: trial_name dtype: string - name: result dtype: string - name: verifier_output dtype: string splits: - name: train num_bytes: 5855460 num_examples: 362 download_size: 5662044 dataset_size: 5855460 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
DCAgent3搜集汇总
数据集介绍
构建方式
该数据集名为bfcl_parity_rl__24GPU_base_excl_timeouts__exp_rpt_pymethods2test_large__GLM_4_7429ead19,其构建过程融合了强化学习与大规模语言模型微调范式。具体而言,基于GLM-4模型在24块GPU上进行分布式并行训练,通过排除超时样本以聚焦有效交互,并采用pymethods2test_large策略生成测试用例,最终以对话形式记录模型、智能体及验证器之间的交互历程。数据集中每个样本包含角色与内容组成的多轮对话、模型标识、任务类型、运行ID及验证器输出等字段,共362条训练样本,总大小约5.8MB。
使用方法
数据集以HuggingFace标准格式存储,可通过datasets库直接加载使用。用户只需指定配置为‘default’,即可自动加载训练分片数据。每个样本的‘conversations’字段为对话列表,适合用于构建多轮对话训练任务或评估模型响应质量。研究者可根据‘agent’、‘task’等字段筛选特定场景的数据,或利用‘verifier_output’作为弱监督信号进行奖励模型训练。建议将数据解析为角色-内容对后,按需进行格式转换以接入下游微调或评估流程。
背景与挑战
背景概述
该数据集名为bfcl_parity_rl__24GPU_base_excl_timeouts__exp_rpt_pymethods2test_large__GLM_4_7429ead19,由研究团队于近期创建,旨在探索基于强化学习的大规模语言模型(如GLM-4)在复杂任务中的性能评估与优化。数据集聚焦于对话代理(agent)的交互质量,通过多轮对话、任务类型、运行实例等维度记录模型输出与验证结果,服务于自然语言处理领域中智能体行为一致性与鲁棒性的研究。其核心研究问题在于如何利用强化学习策略提升语言模型在多样化任务场景下的执行效能,对推动大模型在自动化决策、人机交互等领域的应用具有重要参考价值。
当前挑战
该数据集所解决的领域挑战主要集中在:1)大语言模型在非确定性任务中表现的不稳定性,传统监督学习难以捕获长期依赖与动态策略调整,而强化学习范式虽具潜力,但面临奖励稀疏与样本效率低下的瓶颈;2)构建过程中需确保训练/测试数据在任务类型、代理行为模式上的分布平衡,避免过拟合至特定场景。此外,数据采集涉及对模型输出的实时验证与合规性筛选(如超时排除),加之资源限制(24GPU集群)下的并行化实验设计,进一步加剧了数据代表性、可重复性与规模可扩展性之间的权衡。
常用场景
经典使用场景
该数据集名为bfcl_parity_rl__24GPU_base_excl_timeouts__exp_rpt_pymethods2test_large__GLM_4_7429ead19,其核心用途在于评估和强化基于大型语言模型(LLM)的智能体在工具调用与多轮对话任务中的表现。通过记录模型与环境的完整交互历史(包括角色、内容、任务、回合等字段),研究人员可系统性地分析模型在复杂指令遵循、工具选择及结果验证等环节的决策行为。该数据集尤其适用于对比不同强化学习策略对智能体工具调用能力的影响,是探索LLM自主执行多步骤任务(如API调用、代码生成与测试)的经典基准。
解决学术问题
学术界长期面临如何量化衡量LLM在真实动态环境中工具利用效率的难题。该数据集通过结构化存储模型执行任务时的完整轨迹(含结果与验证器输出),解决了两个关键问题:其一,提供了细粒度的失败模式分类依据,区分因超时、逻辑错误或工具误用导致的失败;其二,支持对强化学习训练策略(如PPO、DPO)在工具调用场景下的收敛速度与泛化能力进行实证对比。其意义在于推动从单纯语言生成向‘规划—执行—验证’闭环能力的评估范式转变,为构建更鲁棒的AI智能体奠定数据基础。
实际应用
在实际产业应用中,该数据集可被用于优化智能客服、代码自动修复及自动化数据分析流水线等场景。例如,企业可基于此数据集微调LLM,使其能根据用户模糊指令正确调用数据库查询API或第三方服务接口,并自动处理返回结果中的异常状态(如超时或格式错误)。此外,在机器人流程自动化(RPA)领域,该数据集的交互格式可直接迁移至多步操作编排任务,显著降低人工编写规则脚本的维护成本,提升端到端任务完成的准确率与效率。
数据集最近研究
最新研究方向
该数据集聚焦于大语言模型在工具调用与智能体任务中的强化学习训练与评估,尤其是通过RL方法优化模型在复杂函数调用场景下的决策能力。结合近期AI领域对自主智能体与代码生成的强烈关注,该数据集以'bfcl_parity_rl'为标识,其命名中蕴含了基准测试与强化学习一致性的探索,反映了前沿研究对模型在真实环境(如24GPU并行训练、超时排除策略)中的鲁棒性与可泛化性的追求。通过记录多轮对话、模型行为与验证器输出,它为探究模型在工具使用、多步骤推理与错误修正上的学习机制提供了宝贵资源,对推动大模型从被动问答转向主动任务执行具有深远意义。
以上内容由遇见数据集搜集并总结生成


