
遇见数据集

ocr-annotations

收藏
Hugging Face2025-10-21 更新2025-10-22 收录
官方服务:

资源简介:

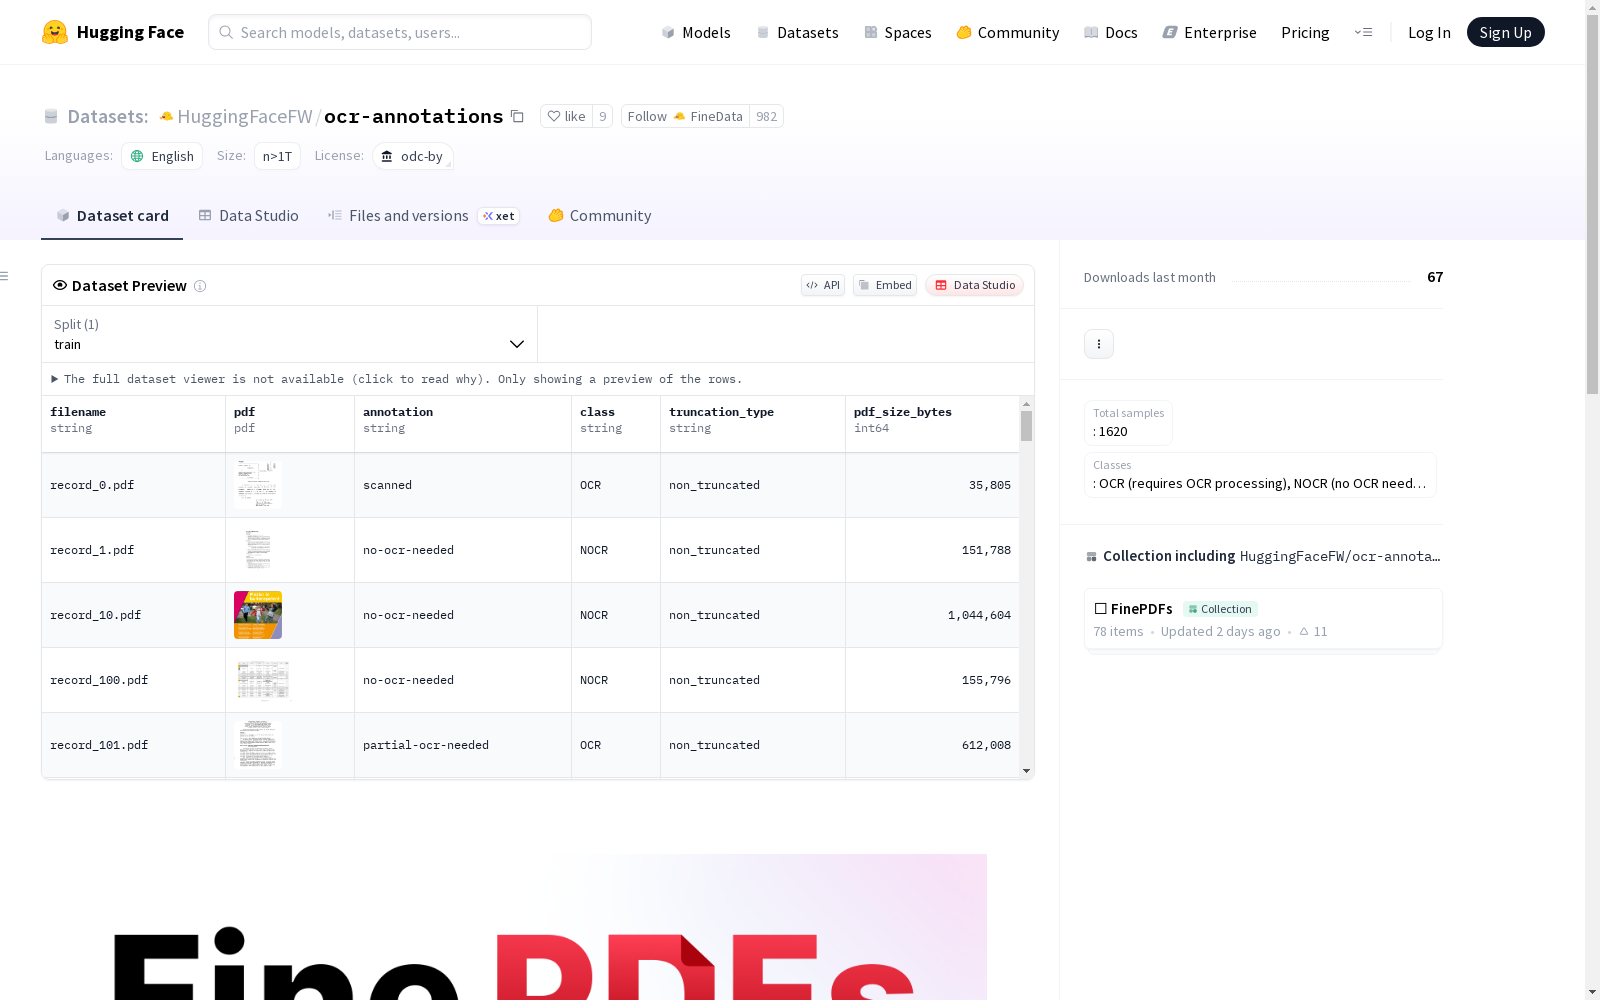
PDF OCR分类数据集包含带有OCR分类注释的PDF文档。总共有1620个样本,分为两个类别:需要OCR处理的OCR类别和不需要OCR处理的NOCR类别。每个样本包括原始PDF文件名、PDF文件的二进制数据、二进制分类标签(OCR/NOCR)、PDF是否截断的信息以及PDF文件的大小(以字节为单位)。数据集的类分布为:NOCR类别有1393个样本,OCR类别有227个样本。

The PDF OCR Classification Dataset contains PDF documents annotated with OCR classification tags. There are 1620 samples in total, divided into two categories: the OCR category requiring OCR processing and the NOCR category not requiring OCR processing. Each sample includes the original PDF filename, the binary data of the PDF file, the binary classification label (OCR/NOCR), information on whether the PDF is truncated, and the size of the PDF file in bytes. The class distribution of the dataset is: the NOCR category has 1393 samples, while the OCR category has 227 samples.

提供机构:
HuggingFaceFW
创建时间:
2025-10-15
原始信息汇总

PDF OCR分类数据集概述

数据集基本信息

  • 数据集名称: OCR-Annotations
  • 许可证类型: odc-by
  • 支持语言: 英语
  • 数据规模: 超过1TB
  • 总样本数量: 1620个

数据集内容描述

该数据集包含用于OCR分类任务的带标注PDF文档。

数据结构

每条数据记录包含以下字段:

  • filename: 原始PDF文件名
  • pdf: 二进制格式的PDF文件数据
  • class: 二元分类标签(OCR/NOCR)
  • truncation_type: PDF文件是否被截断
  • pdf_size_bytes: PDF文件大小(字节)

类别分布

  • NOCR类别: 1393个样本
  • OCR类别: 227个样本

使用方式

python from datasets import load_dataset

加载数据集

dataset = load_dataset("HuggingFaceFW/ocr-annotations")

访问训练集

train_data = dataset[train]

访问样本

sample = train_data[0] pdf_bytes = sample[pdf] # 字节格式 label = sample[class]

许可证说明

请查阅原始数据源获取详细的许可证信息。
搜集汇总
数据集介绍
ocr-annotations 数据集图片
构建方式
在文档数字化处理领域,该数据集通过系统化采集1620份PDF文档构建而成。构建过程采用二进制分类标注机制,由专业人员根据文档是否需要光学字符识别处理划分为OCR与NOCR两类。每份样本均记录原始文件名、PDF二进制数据、分类标签及文档截断状态,同时精确统计文件字节大小以支持量化分析。
特点
该数据集最显著的特征在于其严谨的类别分布设计,1393份无需OCR处理的文档与227份需处理文档形成鲜明对比,为模型训练提供均衡的样本基础。所有PDF文件均保留原始二进制格式,完整呈现真实场景中的文档状态,其标注维度涵盖文件名、分类标签、截断类型及文件大小等多层次元数据,构建出立体化的文档特征体系。
使用方法
借助HuggingFace数据集库,研究者可通过简洁的代码接口直接加载该数据集。使用load_dataset函数调用官方路径即可获取完整数据,通过指定训练集分割可访问结构化样本。每个样本以字典形式呈现,其中pdf字段存储二进制文档数据,class字段对应分类标签,支持直接嵌入OCR技术验证或文档分类模型的训练流程。
背景与挑战
背景概述
光学字符识别技术作为文档数字化处理的核心环节,其发展历程可追溯至二十世纪中叶的早期模式识别研究。OCR-Annotations数据集由HuggingFace研究团队于2023年构建,聚焦于解决文档智能处理中的关键问题——自动识别需要OCR处理的PDF文档。该数据集通过二元分类框架,将文档划分为需OCR处理与无需处理两类,有效提升了文档处理管道的自动化程度,为金融、法律等领域的批量文档分析提供了重要支撑。
当前挑战
在文档智能处理领域,PDF格式因动态渲染特性导致文本提取存在显著困难,传统方法难以区分需OCR处理的扫描文档与原生数字文档。数据集构建过程中面临标注一致性挑战,特别是处理部分截断文档时,需要结合文件结构与内容特征进行双重判断。此外,数据分布不均衡问题突出,仅14%的样本属于OCR类别,这对模型训练中的少数类识别能力提出了更高要求。
常用场景
经典使用场景
在文档数字化处理领域,OCR-Annotations数据集为光学字符识别技术的分类任务提供了标准化评估基准。该数据集通过标注PDF文档是否需要OCR处理,支持研究者构建高效的文档预处理流水线,典型应用于自动化区分扫描文档与原生数字文档,显著提升了文档管理系统的智能化水平。
衍生相关工作
基于该数据集衍生的经典研究包括文档结构理解模型DocLayout分析框架,以及多模态文档分类系统LayoutLM的改进版本。这些工作通过融合视觉与文本特征,进一步拓展了文档智能的应用边界,催生了诸如智能合同解析、学术文献自动标引等创新性研究方向。
数据集最近研究
最新研究方向
在文档数字化处理领域,OCR-Annotations数据集正推动智能文档分析的前沿探索。当前研究聚焦于多模态文档理解,结合视觉与文本特征开发端到端分类模型,显著提升了对扫描文档与原生电子文档的自动辨识能力。随着数字档案管理需求的激增,该数据集被广泛应用于金融票据识别与学术文献处理等场景,其标注体系为构建轻量化OCR决策系统提供了关键支撑,有效降低了文档处理流程中的计算资源消耗。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

