
遇见数据集

botp/COIG-CQIA

收藏
Hugging Face2024-04-21 更新2024-06-12 收录
官方服务:

资源简介:

COIG-CQIA全称为Chinese Open Instruction Generalist - Quality is All You Need,是一个开源的高质量指令微调数据集,旨在为中文NLP社区提供高质量且符合人类交互行为的指令微调数据。数据集来源于中文互联网的问答及文章,经过深度清洗、重构及人工审核构建而成。数据集包含多个子集,如社交媒体&论坛、通用百科、通用NLP任务、考试&试题、人类价值观、中国传统文化、金融&经管领域、医疗领域和法律领域等。数据格式为JSON,包含instruction、input、output等字段。数据集适用于指令微调,训练模型具备响应指令的能力。

COIG-CQIA全称为Chinese Open Instruction Generalist - Quality is All You Need,是一个开源的高质量指令微调数据集,旨在为中文NLP社区提供高质量且符合人类交互行为的指令微调数据。数据集来源于中文互联网的问答及文章,经过深度清洗、重构及人工审核构建而成。数据集包含多个子集,如社交媒体&论坛、通用百科、通用NLP任务、考试&试题、人类价值观、中国传统文化、金融&经管领域、医疗领域和法律领域等。数据格式为JSON,包含instruction、input、output等字段。数据集适用于指令微调,训练模型具备响应指令的能力。

提供机构:
botp
原始信息汇总

数据集概述

数据集名称: COIG-CQIA

全称: Chinese Open Instruction Generalist - Quality is All You Need

目的: 提供高质量且符合人类交互行为的中文指令微调数据,旨在支持中文NLP社区。

数据来源: 中文互联网的问答及文章,经过深度清洗、重构及人工审核。

语言: 中文

数据集版本: v0.1

数据集组成

配置名称及数据文件:

  • chinese_traditional: 训练数据路径为 chinese_traditional/*
  • coig_pc: 训练数据路径为 coig_pc/*
  • exam: 训练数据路径为 exam/*
  • finance: 训练数据路径为 finance/*
  • douban: 训练数据路径为 douban/*
  • human_value: 训练数据路径为 human_value/*
  • logi_qa: 训练数据路径为 logi_qa/*
  • ruozhiba: 训练数据路径为 ruozhiba/*
  • segmentfault: 训练数据路径为 segmentfault/*
  • wiki: 训练数据路径为 wiki/*
  • wikihow: 训练数据路径为 wikihow/*
  • xhs: 训练数据路径为 xhs/*
  • zhihu: 训练数据路径为 zhihu/*

任务类别:

  • 问答
  • 文本分类
  • 文本生成
  • 文本到文本生成

数据集大小: 10K<n<100K

数据格式

json { "instruction": "示例问题或者指令。", "input": "示例问题或指令的补充。", "output": "对输入的回复。", "task_type": { "major": ["问答"], "minor": ["百科问答"] }, "domain": ["百科", "医疗"], "answer_from": "human", "human_verified": true, "copyright": "作者及版权信息。", }

数据详情

社交媒体&论坛:

  • 知乎: 8837条
  • 豆瓣: 3132条
  • 小红书: 1508条
  • Segmentfault: 458条
  • 总量: 13935条

通用百科:

  • 百科文章: 980条
  • 中国大百科全书: 1706条
  • wikiHow中文: 1876条
  • 总量: 4571条

通用NLP任务:

  • COIG-PC-Core: 3000条
  • 总量: 3000条

考试&试题:

  • 高考&中考: 2000条
  • 研究生入学考试: 475条
  • 逻辑推理题: 422条
  • 总量: 2897条

人类价值观:

  • 100poison: 906条
  • COIG-human-value: 101条
  • 总量: 1007条

中国传统文化:

  • 中华传统文化试题: 232条
  • 成语释义: 112条
  • 古诗词撰写: 47条
  • 文言文互译: 112条
  • 总量: 503条

金融&经管领域:

  • MBA百科: 10689条
  • 金融NLP任务: 600条
  • 总量: 11289条

医疗领域:

  • 医疗百科: 8351条
  • 医疗文章: 186条
  • 总量: 8537条

法律领域:

  • 法律研究生入学考试: 2645条
  • 总量: 2645条

使用建议

用户应意识到数据集存在的风险、偏见和技术限制。更多信息需进一步提供。

引用信息

bibtex @misc{bai2024coig, title={COIG-CQIA: Quality is All You Need for Chinese Instruction Fine-tuning}, author={Bai, Yuelin and Du, Xinrun and Liang, Yiming and Jin, Yonggang and Liu, Ziqiang and Zhou, Junting and Zheng, Tianyu and Zhang, Xincheng and Ma, Nuo and Wang, Zekun and others}, year={2024}, eprint={2403.18058}, archivePrefix={arXiv}, primaryClass={cs.CL} }
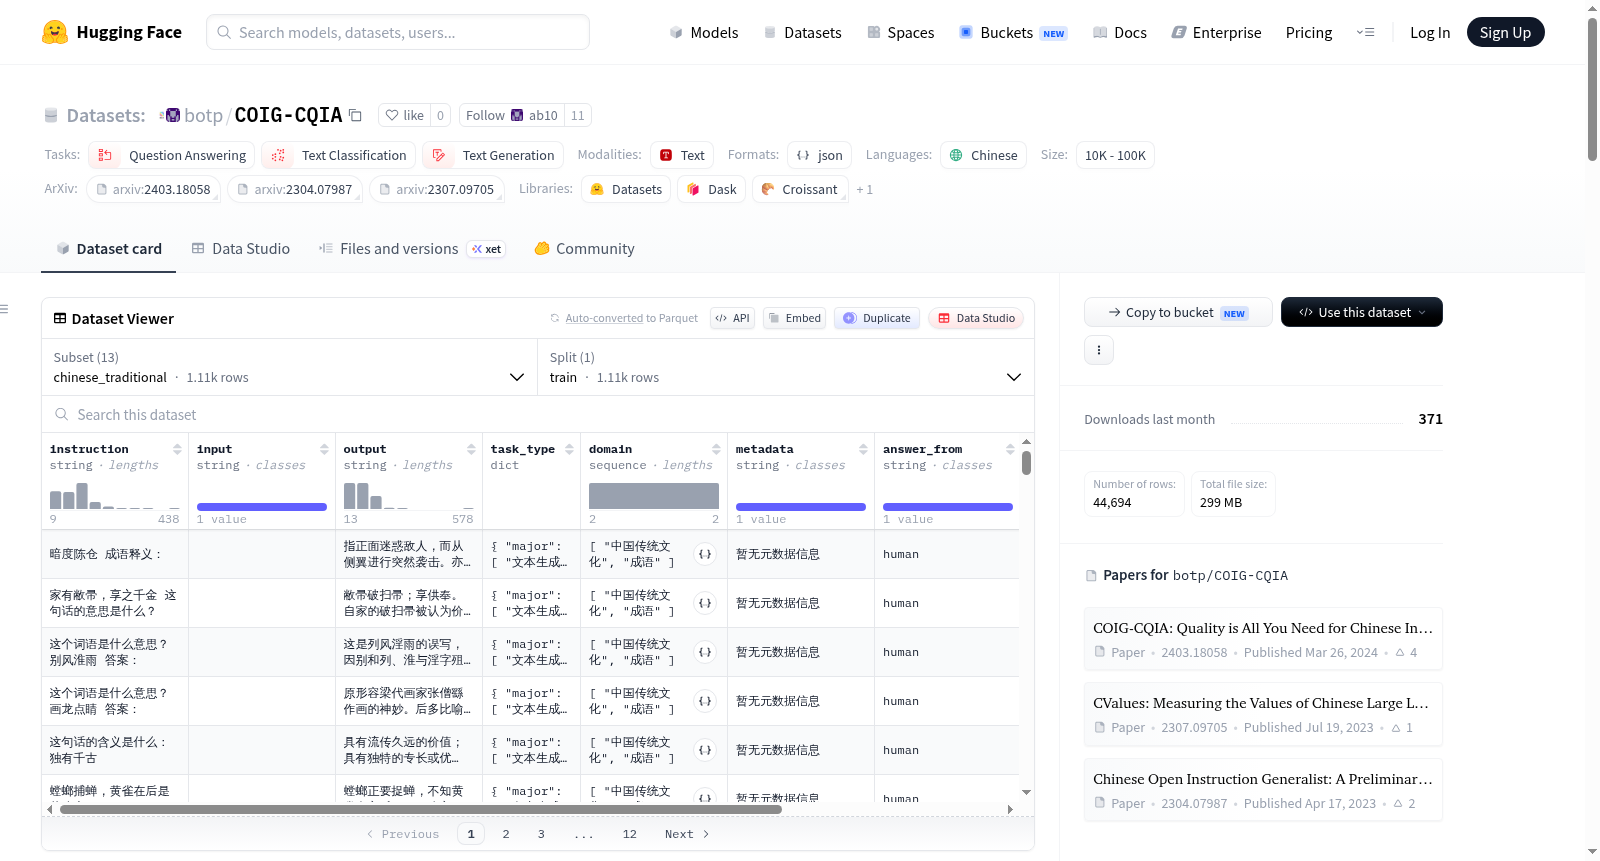
搜集汇总
数据集介绍
botp/COIG-CQIA 数据集图片
构建方式
COIG-CQIA数据集以中文互联网中获取的问答及文章为原始素材,历经深度清洗、内容重构与人工审核等多道工序精制而成。其构建过程汲取了LIMA等研究的核心理念,坚信少量优质数据足以引导大语言模型习得人类交互行为。具体而言,数据来源横跨知乎、豆瓣等社交媒体,百科、医疗等专业领域,以及高考、法律等考试试题,针对不同来源采用差异化的构造策略:对于知乎等平台,实施多阶段质量筛选与人工验证;对于豆瓣、小红书等内容,则通过人工撰写多样化提示模板进行转化;对于百科类知识,借助规则清洗并结合人工验证;部分公开数据集经人工核验后直接纳入。最终形成涵盖问答、分类、生成等多种任务类型的指令微调数据,且绝大多数回答由人类撰写,少数由大模型生成并经过人工确认。
特点
该数据集的核心特质在于对质量的极致追求与对多样性的精心平衡。其数据总量虽不及百万级,但每一例都经过严格的质量控制,确保指令与回答的契合度及人类交互的自然性。数据字段设计详尽,包含指令、输入、输出、任务类型、领域、回答来源及人工验证状态等元信息,为用户提供了充分的透明度与选择灵活性。覆盖范围广泛,横跨社交媒体、通用百科、通用NLP任务、考试试题、人类价值观、中国传统文化、金融经管、医疗及法律等九大领域,任务类型涵盖问答、分类、文本生成与文本转换。尤为突出的是,数据集中绝大部分回答源自人类,辅以人工验证机制,有效保证了回答的准确性与文化适应性,使其成为中文指令微调领域兼具深度与广度的优质资源。
使用方法
本数据集专为指令微调任务设计,旨在赋予大语言模型精准响应指令的能力。使用时,用户可通过HuggingFace Datasets库便捷加载,数据集提供了多个配置子集,如chinese_traditional、exam、finance等,每个子集对应特定的领域或来源,便于按需选择。数据格式为标准JSON结构,包含instruction、input、output、task_type、domain等字段,可直接用于训练序列到序列模型。推荐在微调过程中,结合数据集的task_type和domain字段进行任务特定或领域特定的训练,以最大化模型性能。鉴于其高质量与多样性,COIG-CQIA尤其适合作为核心训练集,用于提升模型在中文场景下的指令遵循能力、知识问答准确性及价值观对齐程度。
背景与挑战
背景概述
COIG-CQIA(Chinese Open Instruction Generalist - Quality is All You Need)是由零一万物、中国科学院深圳先进技术研究院及M-A-P等机构的研究者于2024年联合推出的高质量中文指令微调数据集。该数据集的核心研究问题在于探索如何通过少量但高质量的数据,使大语言模型习得符合人类交互行为的指令遵循能力,其理念深受《LIMA: Less Is More for Alignment》等研究的启发。通过从知乎、豆瓣、百科、医疗、金融等多元中文互联网渠道采集原始问答与文章,并经过深度清洗、结构化重构及严格人工审核,COIG-CQIA旨在为中文NLP社区提供一种不同于大规模低质数据的微调范式。该数据集的出现,对中文大语言模型的对齐研究产生了重要影响,推动了领域内对数据质量与多样性平衡的关注。
当前挑战
COIG-CQIA所面临的挑战首先体现在解决中文指令微调领域的数据质量困境上。现有中文数据集往往规模庞大但噪声严重,缺乏与人类真实交互行为的高度一致性,导致模型在细粒度指令理解与价值观对齐方面表现欠佳。其次,在数据集构建过程中,研究者遭遇了多重挑战:一是从社交媒体(如知乎、小红书)和论坛中提取数据时,需应对非结构化文本的多样性、口语化表达及潜在偏见,设计精细的规则与多阶段筛选策略以剔除低质内容;二是人工验证环节的高成本与主观性差异,确保跨领域(如医疗、法律)数据的专业性与准确性;三是版权与伦理合规问题,需在数据字段中明确标注来源与版权信息,同时平衡数据开放性与隐私保护。这些挑战共同构成了COIG-CQIA在推动中文NLP发展时必须克服的关键障碍。
常用场景
经典使用场景
COIG-CQIA数据集专为中文大语言模型的指令微调而设计,其经典使用场景在于通过少量高质量、多样化的指令-回复对,使模型习得符合人类交互行为的对话能力。研究者可基于该数据集的丰富子集,如社交媒体问答、百科知识、考试试题及专业领域内容,对预训练模型进行监督式微调,从而显著提升模型在中文语境下的指令遵循与生成质量。该数据集强调数据来源的真实性与人工审核,特别适用于探究数据质量与模型对齐效果之间关系的实验,为高效构建指令遵循模型提供了可靠基准。
实际应用
在实际应用中,COIG-CQIA可用于快速定制面向中文用户的智能客服、教育辅导及专业咨询系统。例如,利用其金融与医疗子集微调的模型,能够准确解答MBA百科问题或提供医疗百科知识;基于社交媒体数据的模型则擅长处理知乎、小红书等平台的开放域问答。该数据集还支持构建具有文化敏感性的应用,如古诗词生成与成语释义,助力传统文化传播。其高质量特性降低了部署成本,使中小企业也能基于开源模型打造具备流畅中文交互能力的垂直领域助手。
衍生相关工作
COIG-CQIA的发布催生了一系列相关研究,其中最经典的工作包括对其数据质量评估框架的深入分析,以及基于该数据集对比不同微调策略(如LoRA、全参数微调)效果的实验。此外,有研究将其作为基准,探索指令多样性对模型安全性与鲁棒性的影响。该数据集也常与LIMA、COIG等前期工作结合,用于验证‘数据质量优于数量’这一假设在中文场景下的普适性。部分衍生工作还致力于扩展其领域覆盖范围,例如引入法律判例或中医典籍数据,进一步丰富了中文指令微调的数据生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

