
DCAgent3/financeagent_terminal_a3_rl_SankalpKJ_nemotron_code_oracle_filtered_60_8B_20260e0726ab6
收藏数据链接:
官方服务:
资源简介:
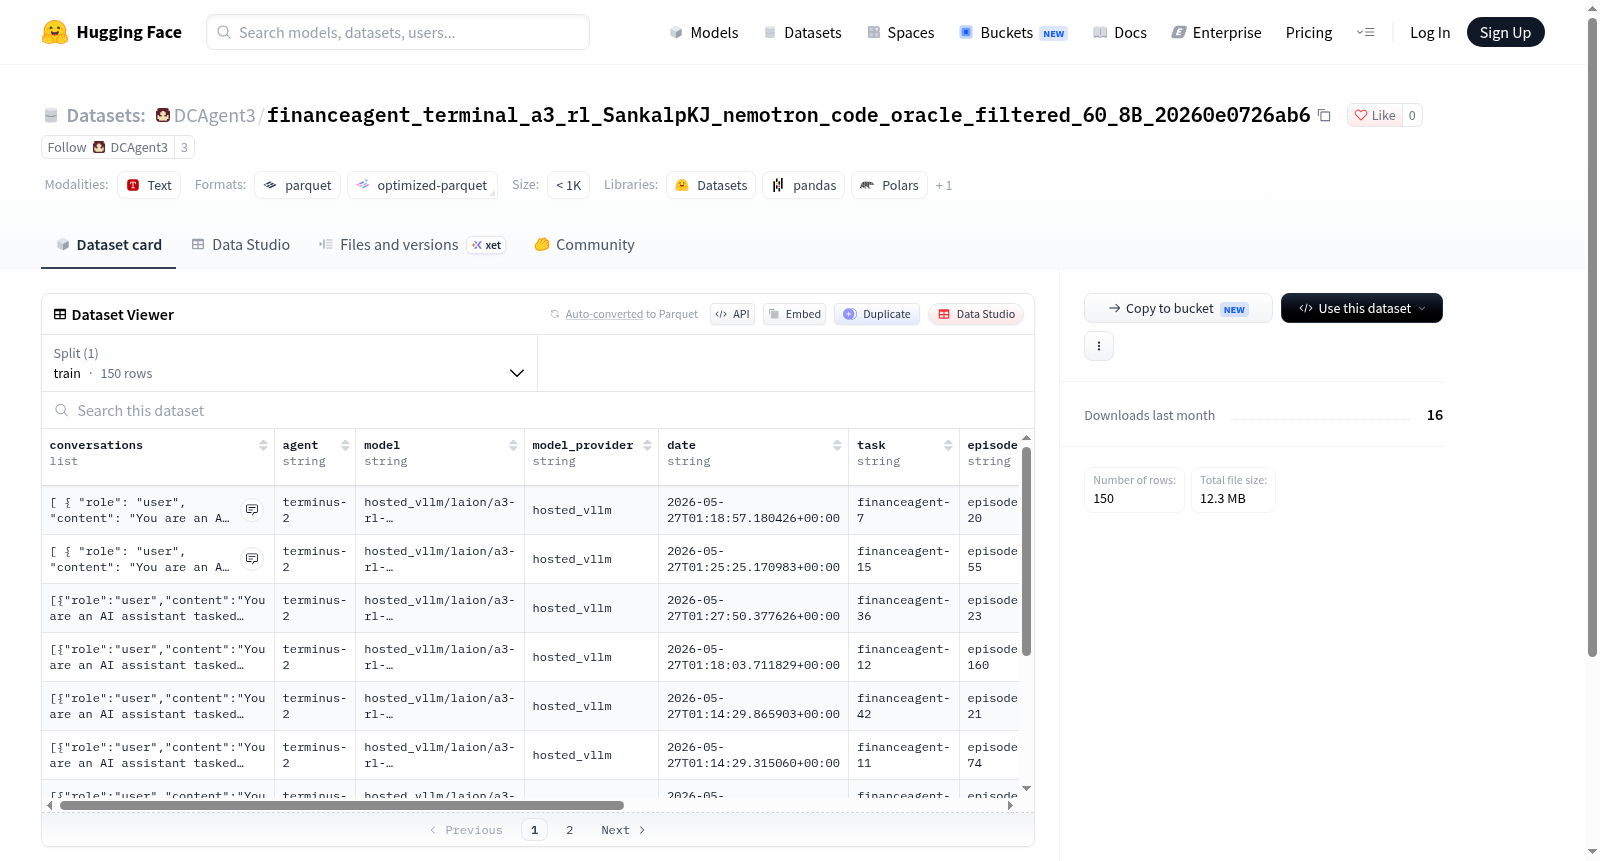
该数据集包含150个训练示例,主要用于多轮对话和任务执行场景。每个示例包含对话记录(包括角色和内容)、代理信息、模型名称、模型提供商、日期、任务类型、剧集、运行ID、试验名称、结果和验证器输出等特征字段。数据集设计用于支持对话系统、任务完成评估和模型验证的研究,文件大小约为12.4MB。
This dataset contains 150 training instances, primarily intended for multi-turn dialogue and task execution scenarios. Each instance includes feature fields such as dialogue records (covering speaker roles and their corresponding utterance content), agent information, model name, model provider, date, task type, episode, run ID, experiment name, results, and validator outputs. This dataset is designed to support research on dialogue systems, task completion evaluation, and model validation, with a file size of approximately 12.4 MB.
提供机构:
DCAgent3搜集汇总
数据集介绍
构建方式
在金融智能体强化学习领域,高质量的多轮对话与可验证执行轨迹数据是提升模型决策能力的关键。该数据集源自Nemotron代码预言机机制的筛选流程,面向终端交互场景构建。其构建过程以代理在金融任务中的实际运行为基础,完整记录每一轮对话的角色与内容,同时关联代理名称、模型标识、模型提供方、日期、任务类型、回合编号、运行标识及试验名称等元信息。通过代码预言机对执行结果进行验证,仅保留通过筛选的六十组八B规模模型交互样本,最终形成包含一百五十条训练实例、约一千二百四十三万字节的规范化数据集合。
特点
该数据集呈现出鲜明的结构化与可追溯特性。对话内容以角色-内容二元组序列存储,便于还原代理与环境的交互脉络。每条样本附带代理、模型、提供方、任务、回合、运行标识及试验名称等字段,支持细粒度的来源追踪与分组分析。结果字段与验证器输出字段共同构成执行正确性的双重记录,使样本兼具行为轨迹与质量标签。数据规模适中,训练集含一百五十例,兼顾了实验效率与场景覆盖,适用于金融终端任务中代理策略的强化学习与行为克隆研究。
使用方法
使用该数据集时,可借助HuggingFace数据集加载接口直接读取默认配置下的训练划分,获取对话序列及配套元数据字段。研究者可将对话内容按角色拼接为模型输入,利用任务与回合字段构造多轮交互上下文,并结合结果与验证器输出进行奖励建模或过滤筛选。在强化学习流程中,代理标识、模型标识与运行标识可用于划分训练与评估子集,避免数据泄漏。该数据集亦可作为离线评估基准,用于分析不同模型提供方在金融终端任务中的行为差异与执行成功率。
背景与挑战
背景概述
金融领域智能体研究近年来方兴未艾,旨在通过大语言模型驱动自动化决策以应对复杂多变的金融任务。该数据集由相关研究团队于2026年构建,聚焦于终端环境下的金融智能体强化学习,核心研究问题在于如何使智能体在真实金融操作场景中通过代码执行与反馈迭代优化策略。数据集以对话形式记录智能体与模型的交互轨迹,涵盖任务、验证器输出等多维信息,为评估智能体在金融终端操作中的推理与执行能力提供了珍贵语料,对推动金融自动化与强化学习交叉领域的发展具有潜在影响力。
当前挑战
该数据集所应对的领域问题在于金融终端操作中智能体需在动态环境下完成多步骤决策,其挑战源于金融任务固有的高风险性、实时性以及操作序列的不可逆性。构建过程中,采集真实且合规的金融交互数据面临隐私保护与监管约束,同时确保智能体行为可验证、可复现亦非易事。此外,数据规模有限,仅含150条训练样本,可能制约模型泛化能力,而验证器输出的可靠性依赖底层规则设计的完备性,这些因素共同构成了数据集应用与推广的主要障碍。
常用场景
经典使用场景
在金融智能体与代码生成交叉的实证研究中,该数据集典用于训练和评估基于强化学习的金融终端操作智能体。其核心场景在于模拟真实金融终端环境下的多轮对话与代码执行任务,通过会话记录、代理输出及验证器反馈,构建从自然语言指令到可执行代码的映射关系。研究者常将其作为离线强化学习的回放缓冲区,尤其适用于过滤高质量代码轨迹后微调大语言模型,以提升智能体在复杂金融数据查询与计算任务中的决策准确性。
解决学术问题
该数据集直面金融领域智能体研究中代码生成可靠性不足与任务验证缺失的痛点。传统方法难以在动态金融终端环境下评估智能体输出的正确性,而本数据集通过整合对话、代理动作、模型来源及验证器输出,为学术研究提供了可复现的强化学习信号。它解决了小样本条件下代码导向的金融任务微调问题,使研究者能够探究模型规模、代理架构与验证反馈对最终任务完成率的影响,推动了金融NLP与程序合成领域的交叉验证方法学发展。
衍生相关工作
围绕该数据集,后续研究衍生出多条经典工作脉络。一方面,研究者将其用于对比不同基础模型(如Nemotron系列)在金融代码任务中的强化学习效率,催生了面向终端操作的奖励建模与课程学习策略。另一方面,该数据集促使了验证器增强的智能体框架发展,例如结合规则校验与模型判别的混合评估方法。此外,部分工作将其扩展至多智能体协作场景,探索代理间分工与代码复用机制,为金融领域自主智能体的持续学习与安全部署奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


