
遇见数据集

nico8771/qm9_clean

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

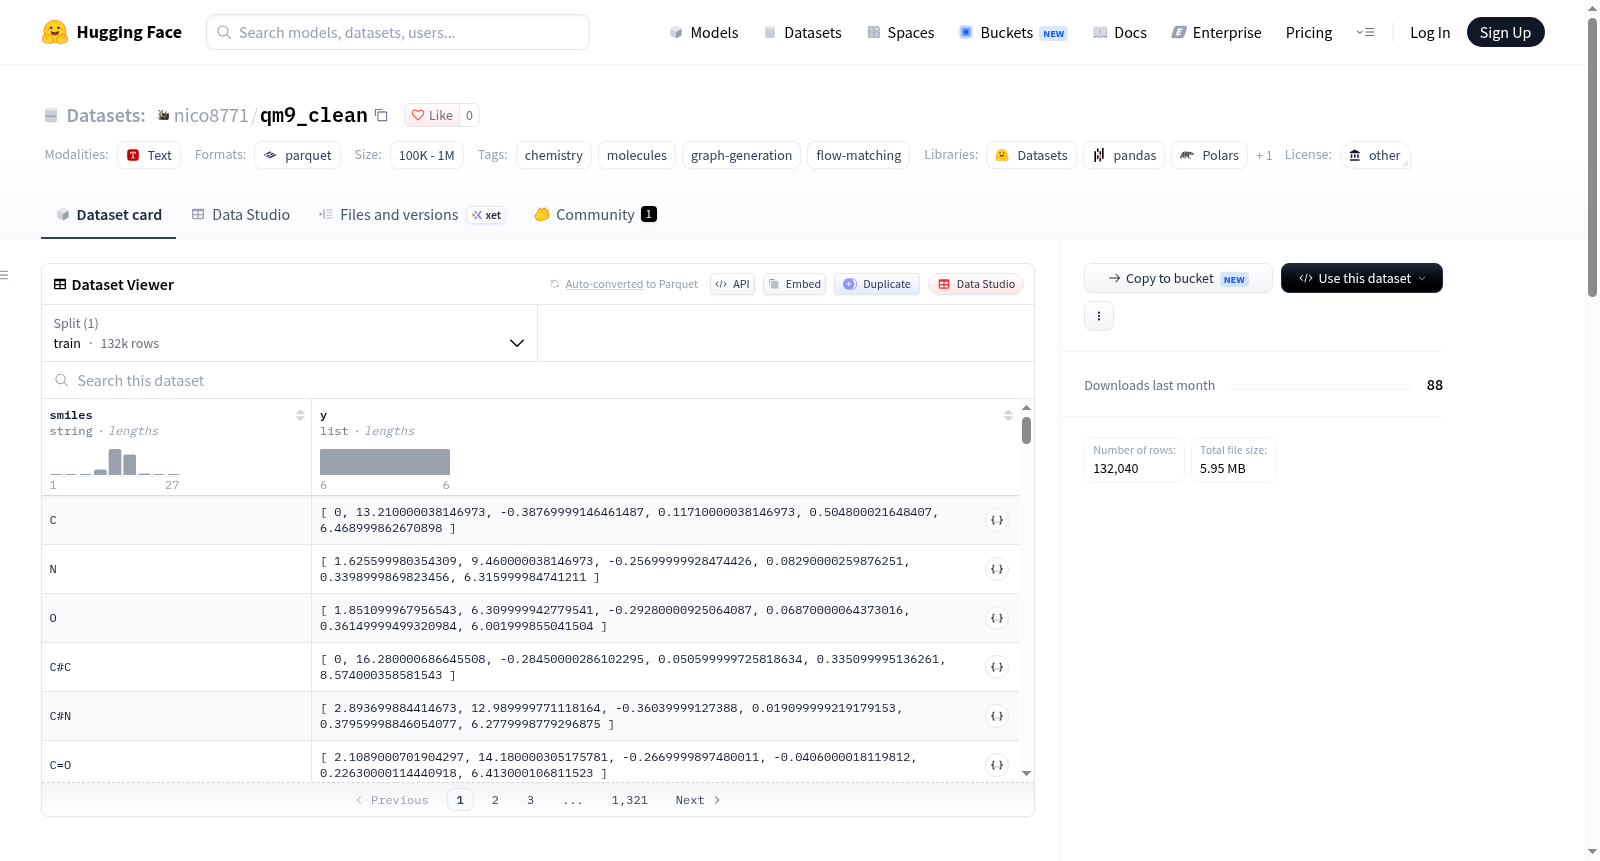
该数据集是清理过的QM9数据集,专门用于化学、分子、图生成和流匹配任务。它包含132,040个中性分子,每个分子用规范SMILES字符串表示,并附带六个DFT目标属性:mu、alpha、homo、lumo、gap和cv。数据集经过解析、标准化(去除立体化学并净化)、Kekulize化(基于原子词汇表C、N、O、F)和往返检查等处理流程。键使用四个类别:无键、单键、双键和三键。DFT属性是QM9原始提供的,无法通过RDKit重新计算。

license: 其他 pretty_name: qm9_clean tags: - 化学 - 分子 - 图生成 - 流匹配 size_categories: - 100K<n<1M # nico8771/qm9_clean — 经过清洗的QM9数据集 每一行均以中性分子形式存储,采用**标准化SMILES(canonical SMILES)** 与**EDM-six 密度泛函理论(DFT)目标值**。 > 来源:torch_molecule QM9(Hugging Face镜像仓库)。代码仓库地址:<https://github.com/Nico-Conti/flow-matching-molecules>(`dataset/`目录下)。 ## 字段结构 | 列名 | 数据类型 | 描述 | |---|---|---| | `smiles` | 字符串 | 经过标准化处理、可实现凯库勒式转换的单片段SMILES(已完成校验清理) | | `y` | 浮点型列表 | DFT目标属性,对应列依次为偶极矩`mu`、极化率`alpha`、最高占据分子轨道能级`homo`、最低未占据分子轨道能级`lumo`、能隙`gap`、定容热容`cv` | ## 数据处理流程 1. **解析**:使用RDKit化学信息学工具包进行解析,无法完成解析的样本将被直接丢弃。 2. **标准化**:移除分子的立体化学信息,执行校验清理操作(QM9数据集原始样本均为中性分子)。 3. **凯库勒式转换**:限定原子词汇表为`C`(碳)、`N`(氮)、`O`(氧)、`F`(氟),超出该词汇表的原子将被丢弃。 4. **往返校验**:执行`SMILES → (分子拓扑结构X, 化学键E) → 分子对象 → SMILES`的往返校验流程。 化学键共分为4类(无键/单键/双键/三键)。QM9数据集自带的六项DFT属性**无法通过RDKit工具包重新计算得到**。 ### 样本丢弃/保留统计(本次构建版本) | 处理结果 | 样本数量 | |---|---| | `drop_vocab`(超出词汇表被丢弃) | 1,845 | | `kept`(保留样本) | 132,040 | 本次构建共保留**132,040**个分子。
提供机构:
nico8771
搜集汇总
数据集介绍
nico8771/qm9_clean 数据集图片
构建方式
在分子机器学习与图生成模型研究中,高质量、标准化且可直接用于深度学习架构的分子数据集构成了模型性能与可复现性的基石。qm9_clean数据集以torch_molecule的QM9镜像为源,执行了一套严谨的清洗流程:首先利用RDKit对原始分子进行解析,剔除不可解析的条目;继而施行标准化操作,包括去除立体化学信息与化学价态净化,以契合QM9分子电中性的固有属性;随后在限定原子词表(C、N、O、F)内完成凯库勒化,并将词表之外的原子排除;最终通过SMILES→(X,E)→mol→smiles的往返校验,确保分子图与字符串表示之间的一致性。该流程共保留132,040个分子,丢弃1,845个词表外样本,所有键类型映射为四类(无、单、双、三键),从而生成一套结构规整、边界清晰的基准数据。
特点
该数据集以规范化的SMILES字符串及六项密度泛函理论(DFT)目标值构成,每行代表一个电中性单片段分子,其SMILES表示具备可凯库勒化与经净化处理的特点。目标属性`y`为包含`mu`、`alpha`、`homo`、`lumo`、`gap`、`cv`的浮点数列表,单位遵循原始QM9设定:偶极矩为Debye,极化率为Bohr³,轨道能量为Hartree,热容为cal·mol⁻¹·K⁻¹。值得注意的是,能量目标以Hartree存储,但加载时可借助`load_qm9(to_ev=True)`自动换算为电子伏特,以匹配FreeGress/DiGress等文献中报道的平均绝对误差。这些DFT属性为QM9原始附带,无法通过RDKit重新计算,由此保障了数据作为量子化学真值的可靠性。原子种类与键类型的有限性亦使该数据集天然适配图神经网络与流匹配等生成模型的训练与评测。
使用方法
在实践应用中,使用者可通过配套代码库(flow-matching-molecules的dataset模块)便捷地加载该数据集,并依据研究需求选择是否将能量目标转换为电子伏特。加载所得的数据结构直接提供规范SMILES与六维DFT属性向量,便于分子图生成、属性预测以及流匹配建模等任务。对于图生成任务,原子特征对应于C、N、O、F四种元素,边特征采用四类键型编码,从而无缝接入主流图神经网络框架。研究者应留意目标属性的原始单位,并在比较MAE等指标时进行必要的单位换算,以确保与既有文献(如FreeGress、DiGress)结果的可比性。此外,由于数据集已执行严格清洗与往返校验,用户可将其直接用于训练、验证与测试,无需额外预处理,从而提升研究流程的标准化程度与可复现性。
背景与挑战
背景概述
量子化学与分子机器学习领域长期依赖高质量基准数据以驱动模型发展。QM9数据集自2014年由Ramakrishnan等学者构建以来,已成为分子性质预测与生成任务的核心基准,涵盖约13.4万个小有机分子的几何、电子与热力学属性。nico8771/qm9_clean在此基础上进行清洗与标准化,保留132,040个中性单片段分子,并整合EDM-six密度泛函理论靶标,发布于HuggingFace平台。该数据集通过规范SMILES与统一原子词汇表,为流匹配等生成模型提供可靠训练资源,对分子图生成与性质预测研究具有重要支撑作用。
当前挑战
该数据集所面向的分子性质预测与图生成任务,核心挑战在于从离散拓扑中准确捕捉量子化学连续量,同时保持生成分子的化学有效性。构建过程中,需应对RDKit解析失败、原子超出词汇表、立体化学残留及非中性片段等噪声,初始数据经清洗后丢弃1,845个样本。此外,六项DFT靶标无法由RDKit重算,需确保数值单位与来源一致,避免能量标度混淆;规范SMILES的 kekulization 与单片段约束亦对数据一致性提出严格要求,为下游模型泛化带来潜在偏差风险。
常用场景
经典使用场景
在分子图生成与三维构象预测的研究中,qm9_clean数据集常被用作基准测试平台,以评估基于流匹配或扩散概率模型的生成能力。该数据集以规范SMILES和EDM-six密度泛函理论(DFT)目标的形式,提供了约13.2万个电中性小分子的标准化图结构,覆盖C、N、O、F四种原子及四种键类型。经典使用场景包括训练图神经网络以从噪声中恢复分子图,或利用条件生成模型根据目标性质(如HOMO-LUMO能隙)逆向设计分子。其清洗流程确保了SMILES的可解析性和单片段性,为生成任务提供了可靠的数据基础。
衍生相关工作
qm9_clean衍生了多项经典工作,包括基于流匹配的分子生成框架(如Flow Matching for Molecules)和基于等变图神经网络的属性预测模型。其前身torch_molecule QM9镜像被广泛用于DiGress、FreeGress等扩散生成模型的训练与评估,而本清洗版本进一步为条件生成任务(如目标性质引导的分子设计)提供了标准化数据接口。相关代码库的公开亦促进了社区在分子图表示、可逆SMILES转换及DFT靶标预测等方向的持续探索,形成了以数据清洗为起点的系列方法学创新。
数据集最近研究
最新研究方向
在分子生成与图神经网络领域,基于量子化学性质预测的分子表示学习持续成为前沿热点。qm9_clean数据集通过严格的SMILES标准化与原子词表过滤,为流匹配(flow matching)等生成模型提供了高质量的训练基底,推动了三维分子构象生成与电子性质联合建模的研究。近期工作聚焦于利用该数据集探索条件生成与性质引导的分子设计,例如以HOMO-LUMO能隙为目标的反向设计,以及结合等变图神经网络提升DFT目标预测精度。这些方向不仅深化了对分子结构与量子化学性质映射关系的理解,也为药物发现与材料筛选提供了可复现的基准,具有显著的领域影响与实用意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

