vietnamese_sms_phishing_dataset
收藏资源简介:
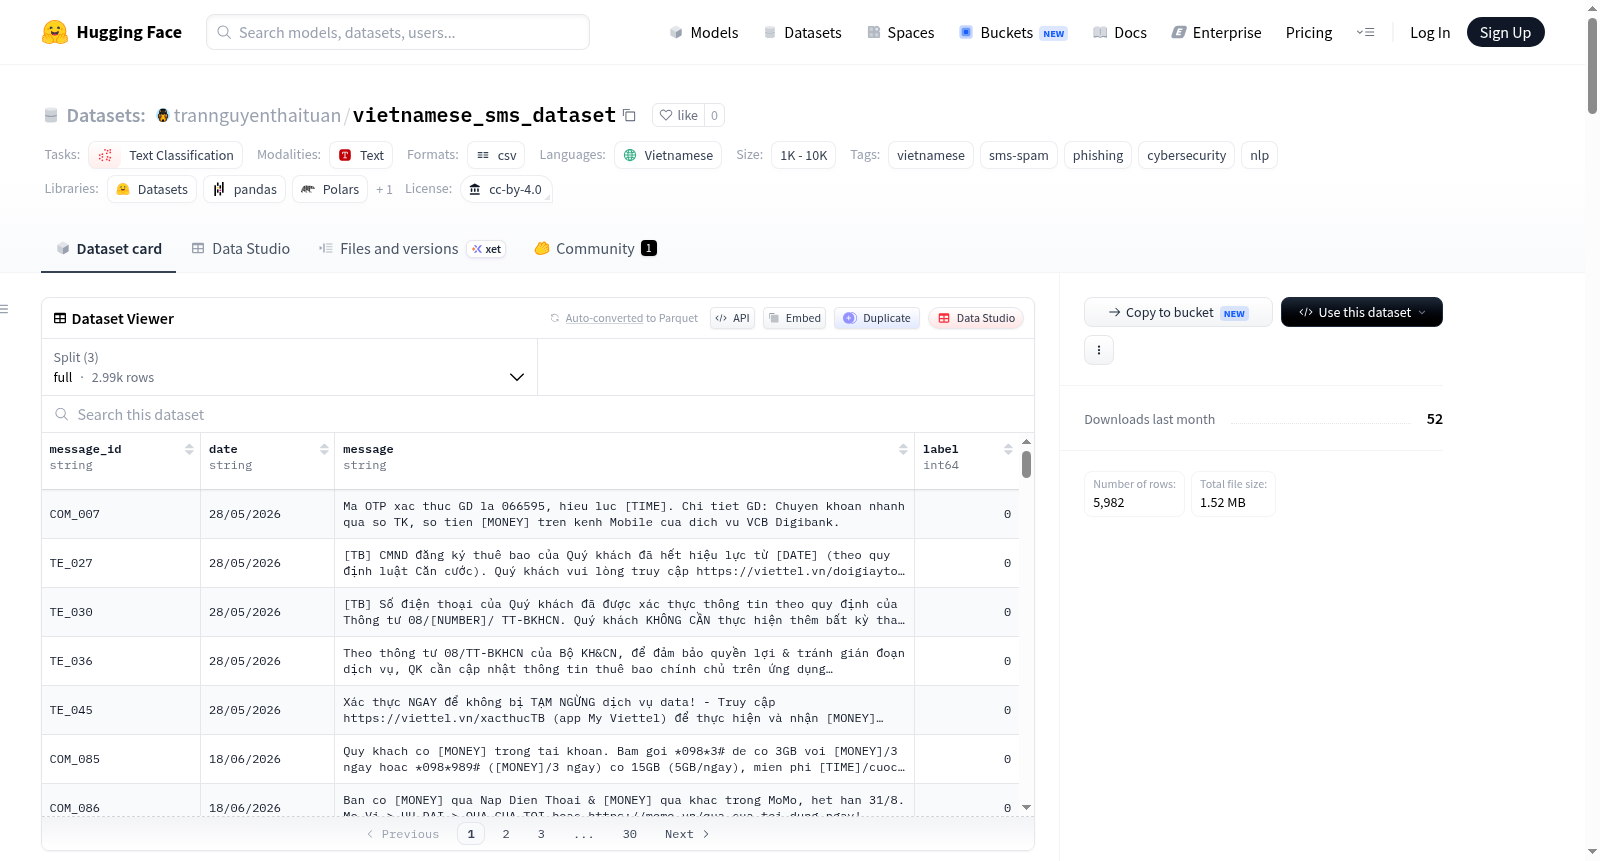
该数据集是官方发布的“质量保证的越南语 SMS 诈骗数据集”(Quality-Assured Vietnamese SMS Phishing Dataset),旨在支持网络安全、自然语言处理(NLP)和机器学习领域的研究,特别是针对 SMS 垃圾短信及诈骗短信的检测任务。数据集完全由真实世界中的越南语 SMS 短信构成,非 AI 生成,也非从其他语言翻译而来。所有短信均从多个合法来源收集,并获得了贡献者的明确同意。数据集的构建过程中,研究团队使用了包含 50,000 个恶意 URL 的数据库作为标签验证的参考标准。数据集包含 2,991 个样本,分为完整数据集(full_dataset.csv)以及训练集(train.csv,2,394 个样本)和测试集(test.csv,597 个样本)。其中完整数据集包含字段:message_id(消息ID)、date(日期)、message(短信内容)、label(标签,0=合法,1=垃圾/诈骗)。训练集和测试集仅包含 message 和 label 字段。所有个人身份信息(PII)均已使用标准化占位符(如 [PHONE]、[BANK_ACC]、[MONEY]、[NUMBER]、[TIME]、[DATE])进行匿名化处理,经人工随机抽样检验未发现残留 PII。数据集采用 CC BY 4.0 许可证发布。在基准测试中,使用 Jaccard 相似度阈值 0.85 去除重复后,对多种模型进行了 5 折交叉验证评估。其中 PhoBERT-base 模型取得了最佳性能(准确率 97.28% ± 0.88%,F1 分数 96.63% ± 1.05%)。研究遵循伦理规范,已获得机构伦理委员会 IRB 豁免(协议编号 IRB-2026-NLP-0428),所有贡献者均为自愿参与并签署了知情同意书。
This dataset is the officially released "Quality-Assured Vietnamese SMS Phishing Dataset", designed to support research in cybersecurity, natural language processing (NLP), and machine learning, particularly for the detection of SMS spam and phishing messages. The dataset consists entirely of real-world Vietnamese SMS messages, not AI-generated or translated from other languages. All messages were collected from multiple legitimate sources with explicit consent from contributors. During construction, the research team used a database of 50,000 malicious URLs as a reference standard for label verification. The dataset contains 2,991 samples, divided into a full dataset (full_dataset.csv), a training set (train.csv, 2,394 samples), and a test set (test.csv, 597 samples). The full dataset includes fields: message_id, date, message, and label (0=legitimate, 1=spam/phishing). The training and test sets only contain the message and label fields. All personally identifiable information (PII) has been anonymized using standardized placeholders such as [PHONE], [BANK_ACC], [MONEY], [NUMBER], [TIME], and [DATE], and manual random sampling confirmed no residual PII. The dataset is released under the CC BY 4.0 license. In benchmark tests, after removing duplicates using a Jaccard similarity threshold of 0.85, multiple models were evaluated via 5-fold cross-validation. The PhoBERT-base model achieved the best performance (accuracy 97.28% ± 0.88%, F1 score 96.63% ± 1.05%). The research follows ethical guidelines and has obtained an IRB exemption (protocol number IRB-2026-NLP-0428), with all contributors voluntarily participating and signing informed consent forms.
越南语短信诈骗数据集(质量保证版)
数据集概览
- 语言:越南语(
vi) - 任务类型:文本分类(二分类)——判断短信是否为垃圾/诈骗信息(
0= 合法,1= 垃圾/诈骗) - 许可证:Creative Commons Attribution 4.0 International(CC BY 4.0)
- 数据规模:1K < N < 10K(共 2,991 条样本)
- 发布时间:2026年(基于引用信息)
数据来源与构建
- 数据集完全由真实世界的越南语短信构成,非 AI 生成,也非从其他语言翻译而来
- 短信从多个合法渠道收集,所有贡献者均事先知情并同意
- 使用了 Team Chống Lừa Đảo 提供的 50,000 条恶意 URL 作为标注与验证的参考资源
- 研究方案已通过机构伦理委员会审查,获得 IRB 豁免(协议编号:
IRB-2026-NLP-0428)
数据匿名化与质量保障
- 所有个人身份信息(PII)均被标准化占位符替代,如
[PHONE]、[BANK_ACC]、[MONEY]、[NUMBER]、[TIME]、[DATE] - 对随机抽样样本进行人工检查,确认匿名化后未残留任何个人身份信息
数据集结构
| 文件 | 说明 | 规模 |
|---|---|---|
full_dataset.csv |
完整数据集(含 message_id、date、message、label) |
2,991 条 |
train.csv |
训练集(含 message、label) |
2,394 条 |
test.csv |
独立测试集,设计用于减少数据泄漏 | 597 条 |
模型基准测试结果
以下为基于 5 折交叉验证 的结果,使用 Jaccard 相似度阈值 J ≥ 0.85 去重后的官方基准数据集:
| 模型 | 准确率 | Precision (%) | Recall (%) | F1-Score (%) | 95% Bootstrap CI |
|---|---|---|---|---|---|
| PhoBERT-base | 97.28% ± 0.88% | 96.85% ± 1.10% | 96.42% ± 1.25% | 96.63% ± 1.05% | [95.60%, 97.65%] |
| Char (3–5 gram) SVM | 96.34% ± 0.68% | 93.31% ± 2.06% | 93.55% ± 2.24% | 93.40% ± 1.21% | [91.86%, 94.87%] |
| RBF SVM | 95.93% ± 0.23% | 95.29% ± 0.97% | 89.75% ± 1.62% | 92.42% ± 0.50% | [90.77%, 93.99%] |
| Linear SVM | 95.79% ± 0.44% | 93.57% ± 1.39% | 91.07% ± 0.81% | 92.30% ± 0.79% | [90.68%, 93.81%] |
| MLP (Neural Network) | 95.52% ± 0.47% | 91.79% ± 1.48% | 92.07% ± 1.34% | 91.92% ± 0.83% | [90.43%, 93.47%] |
| Logistic Regression | 93.96% ± 0.80% | 95.25% ± 1.60% | 82.31% ± 2.80% | 88.28% ± 1.69% | [86.38%, 90.19%] |
| Multinomial Naive Bayes | 89.02% ± 0.91% | 86.41% ± 2.94% | 71.74% ± 2.93% | 78.32% ± 1.86% | [75.57%, 81.08%] |
作者团队
- Trần Nguyễn Thái Tuấn – 首席研究员,负责数据集构建方法、框架设计与项目协调
- Lê Hoàng Khang – 共同作者,参与标注规则制定、标注团队协调与数据处理
- Nguyễn Minh Tài – 研究员,参与标注、数据处理与数据预处理
- Nguyễn Văn Thắng – 研究员,负责数据管理与组织、工作流优化与数据预处理
- Mai Hoàng Đỉnh – 科学顾问与学术导师
引用信息
bibtex @article{tuan2026vietnamese_sms_phishing, title={Vietnamese SMS Dataset with Quality Assurance}, author={Tran, Nguyen Thai Tuan and Le, Hoang Khang and Nguyen, Minh Tai and Nguyen, Van Thang and Mai, Hoang Dinh}, journal={IEEE Access}, year={2026} }
适用场景
该数据集适用于网络安全、自然语言处理(NLP) 和机器学习领域的研究,重点服务于短信垃圾/诈骗检测任务。