
遇见数据集

osunlp/KBQA-Agent

收藏
Hugging Face2024-02-27 更新2024-03-04 收录
官方服务:

资源简介:

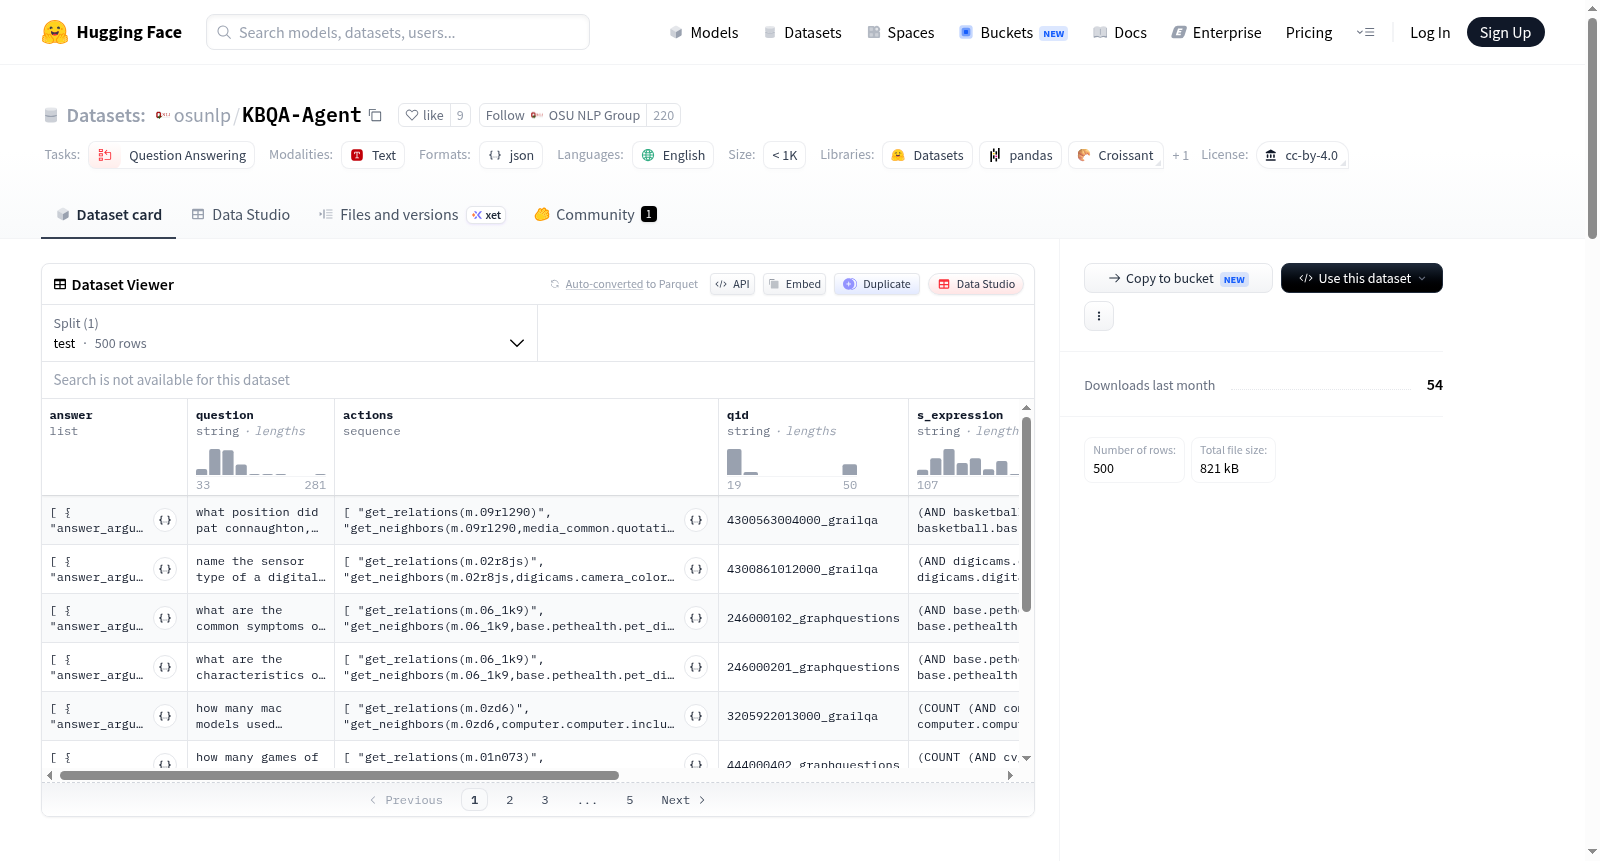
KBQA-Agent数据集旨在为语言代理提供更有针对性的知识库问答(KBQA)评估。该数据集包含500个复杂问题,这些问题来源于GrailQA、ComplexWebQuestions和GraphQuestions三个现有KBQA数据集,并基于Freebase知识库。为了支持未来研究,数据集还提供了每个问题的真实动作序列(即工具调用),以帮助语言代理回答问题。数据集的结构包括问题的唯一标识符(qid)、真实逻辑形式(s-expression)、答案实体列表(answer)、输入问题(question)、动作序列(actions)、问题中提到的主题实体(entities)以及问题的来源(source)。

KBQA-Agent数据集旨在为语言代理提供更有针对性的知识库问答(KBQA)评估。该数据集包含500个复杂问题,这些问题来源于GrailQA、ComplexWebQuestions和GraphQuestions三个现有KBQA数据集,并基于Freebase知识库。为了支持未来研究,数据集还提供了每个问题的真实动作序列(即工具调用),以帮助语言代理回答问题。数据集的结构包括问题的唯一标识符(qid)、真实逻辑形式(s-expression)、答案实体列表(answer)、输入问题(question)、动作序列(actions)、问题中提到的主题实体(entities)以及问题的来源(source)。

提供机构:
osunlp
原始信息汇总

数据集概述

简介

KBQA-Agent 是一个针对语言代理的 KBQA 评估数据集。该数据集包含 500 个复杂的 Freebase 问题,来源于三个现有的 KBQA 数据集:GrailQA、ComplexWebQuestions 和 GraphQuestions。此外,数据集还提供了语言代理回答每个问题所需的真实动作序列(即工具调用)。

数据集划分

KBQA-Agent 针对无训练设置(在原始实验中使用了一次性演示),因此只有一个测试集。

数据集结构

  • qid: 问题的唯一标识符
  • s-expression: 真实逻辑形式,从中导出真实动作
  • answer: 答案实体列表
  • question: 输入问题
  • actions: 从 s-expression 导出的真实动作序列
  • entities: 问题中提到的主题实体
  • source: 问题的来源(例如,GrailQA)

引用

如果该数据集对您的研究有价值,请引用相关文献。
搜集汇总
数据集介绍
osunlp/KBQA-Agent 数据集图片
构建方式
在知识库问答(KBQA)领域,传统方法依赖语义解析器在海量标注数据上训练,而大语言模型(LLM)的崛起催生了基于语言智能体的新范式,其无需大规模训练数据即可通过工具交互完成复杂推理。为精准评估这一新兴范式,KBQA-Agent数据集应运而生。该数据集从GrailQA、ComplexWebQuestions和GraphQuestions三个现有KBQA基准中精心筛选出500个涉及Freebase知识库的复杂问题,剔除了单跳查询等简单样本,并针对每个问题提供了标准的动作序列(即工具调用轨迹),作为智能体求解的黄金标准,从而构建了一个聚焦于复杂多跳推理的评估集合。
特点
KBQA-Agent数据集的核心特色在于其针对语言智能体评估的专门化设计。首先,它摒弃了传统数据集动辄数万条测试样本的规模,仅包含500个精心挑选的复杂问题,大幅降低了评估顶尖模型(如GPT-4)的成本。其次,所有问题均涉及多跳推理,有效挑战了LLM在知识库中自主导航与工具调用的能力。此外,数据集提供标准化的动作序列标注,支持对智能体每一步推理进行细粒度分析,且采用零样本或单样本设置,无需额外训练,契合了当前LLM应用的实际场景。
使用方法
使用KBQA-Agent数据集时,研究者可直接加载其测试集,每个样本包含问题(question)、主题实体(entities)、标准答案(answer)及动作序列(actions)等字段。在评估语言智能体时,可参考原始实验中的单样本演示设置,无需对模型进行微调。模型需基于输入问题,通过调用知识库工具(如查询、过滤等)生成动作序列,最终输出答案。通过将预测结果与标准动作序列及答案对比,可全面评估智能体在复杂KBQA任务中的规划与执行能力。数据集以JSON格式组织,便于集成到各类LLM推理框架中。
背景与挑战
背景概述
知识库问答(KBQA)作为自然语言处理领域的核心任务,长期依赖语义解析技术,需借助大规模标注数据集(如问题-答案对或问题-程序对)训练解析器。然而,大语言模型(LLM)的崛起彻底改变了这一范式。LLM凭借其强大的少样本乃至零样本上下文学习能力,能够以自然语言为通用思维载体,主动调用外部工具与知识库交互,从而摆脱对海量训练数据的依赖。为评估这一新兴的“语言代理”范式,来自俄亥俄州立大学、清华大学等机构的研究人员于2024年提出了KBQA-Agent数据集。该数据集从GrailQA、ComplexWebQuestions和GraphQuestions三个经典基准中精选500个复杂问题,覆盖Freebase知识库,并提供了标准动作序列作为推理依据,旨在为LLM代理在复杂环境中的KBQA能力提供更具针对性的评测基准,推动了该领域从传统语义解析向工具增强型智能代理的范式转型。
当前挑战
KBQA-Agent所应对的核心挑战在于现有KBQA基准难以充分评估LLM代理的复杂推理能力。传统数据集多包含大量单跳查询问题,无法有效探测LLM在多步推理、工具调用与知识库交互中的真实表现;同时,如GrailQA等基准包含数万条测试样本,对GPT-4等强模型进行全量评估代价高昂且冗余。此外,数据集构建过程本身亦面临挑战:需从不同来源的异构问题中筛选出真正复杂的多跳查询,并保证问题覆盖知识库中多样化的实体关系与逻辑结构;还需为每个问题推导并验证标准化的动作序列,确保其准确性以支持无训练场景下的评估。这些挑战共同塑造了KBQA-Agent作为针对性评测工具的价值,使其成为连接传统KBQA与新兴语言代理研究的关键桥梁。
常用场景
经典使用场景
在知识库问答(KBQA)领域,传统方法依赖大量标注数据训练语义解析器,但大语言模型(LLM)的崛起催生了基于语言代理的新范式。KBQA-Agent 数据集应运而生,专为评估 LLM 驱动的智能代理在复杂知识库上的问答能力而设计。它从 GrailQA、ComplexWebQuestions 和 GraphQuestions 三个经典基准中精选了 500 个多跳复杂问题,并提供了标准动作序列作为参照。这一数据集聚焦于训练无关的零样本或少样本场景,为衡量语言代理在真实知识库环境中的推理与工具调用能力提供了精准的测试平台。
衍生相关工作
KBQA-Agent 的提出催生了一系列相关研究,其中最具代表性的是其伴随论文《Middleware for LLMs: Tools Are Instrumental for Language Agents in Complex Environments》。该工作深入探讨了中间件在增强语言代理工具调用能力中的作用,并利用此数据集验证了多步推理与动作序列生成的有效性。此外,基于该数据集,研究者进一步探索了少样本学习、思维链提示与知识库接口设计等方向,推动了 LLM 代理在结构化环境中的泛化能力研究,为后续如 Toolformer、ReAct 等方法的改进提供了实证基础。
数据集最近研究
最新研究方向
随着大规模语言模型(LLM)的崛起,知识库问答(KBQA)领域正经历从传统语义解析范式向语言智能体(Language Agent)范式的深刻转型。osunlp/KBQA-Agent数据集应运而生,精准聚焦于评估LLM在多跳复杂查询中的工具交互与自主导航能力。该数据集从GrailQA、ComplexWebQuestions和GraphQuestions中精选500个高难度问题,涵盖真实动作序列标注,为研究LLM在不依赖大规模训练数据下的零样本或小样本推理提供了标杆。当前前沿方向集中于利用LLM的上下文学习能力与工具调用机制,探索其在动态知识环境中的决策路径与错误恢复策略。这一数据集的出现,不仅推动了KBQA评估从静态逻辑形式向动态智能体行为的演进,也呼应了可解释AI与成本效益优化等热点议题,为构建更鲁棒、更经济的问答系统奠定了关键基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

