car-insurance-eda
收藏资源简介:
该数据集名为“汽车保险索赔数据集”,来源于Kaggle,包含个人的 demographic、财务和驾驶相关信息,旨在分析影响保险索赔行为的因素。数据集主要包含数值型特征,如年龄组、信用评分、驾驶经验、年行驶里程、超速违规记录、酒驾记录、过往事故记录、车辆年份、车辆类型、子女情况、婚姻状态等。目标变量为“OUTCOME”,0表示无索赔,1表示有索赔。数据集经过数据质量检查,包括缺失值、重复行、不一致性等处理,保留了可能的极端值以反映真实驾驶行为。分析发现,保险索赔行为受多种因素影响,包括年龄、信用评分、车辆年份和驾驶经验等。数据集适用于统计分析和可视化,尤其适合保险风险预测和决策支持。
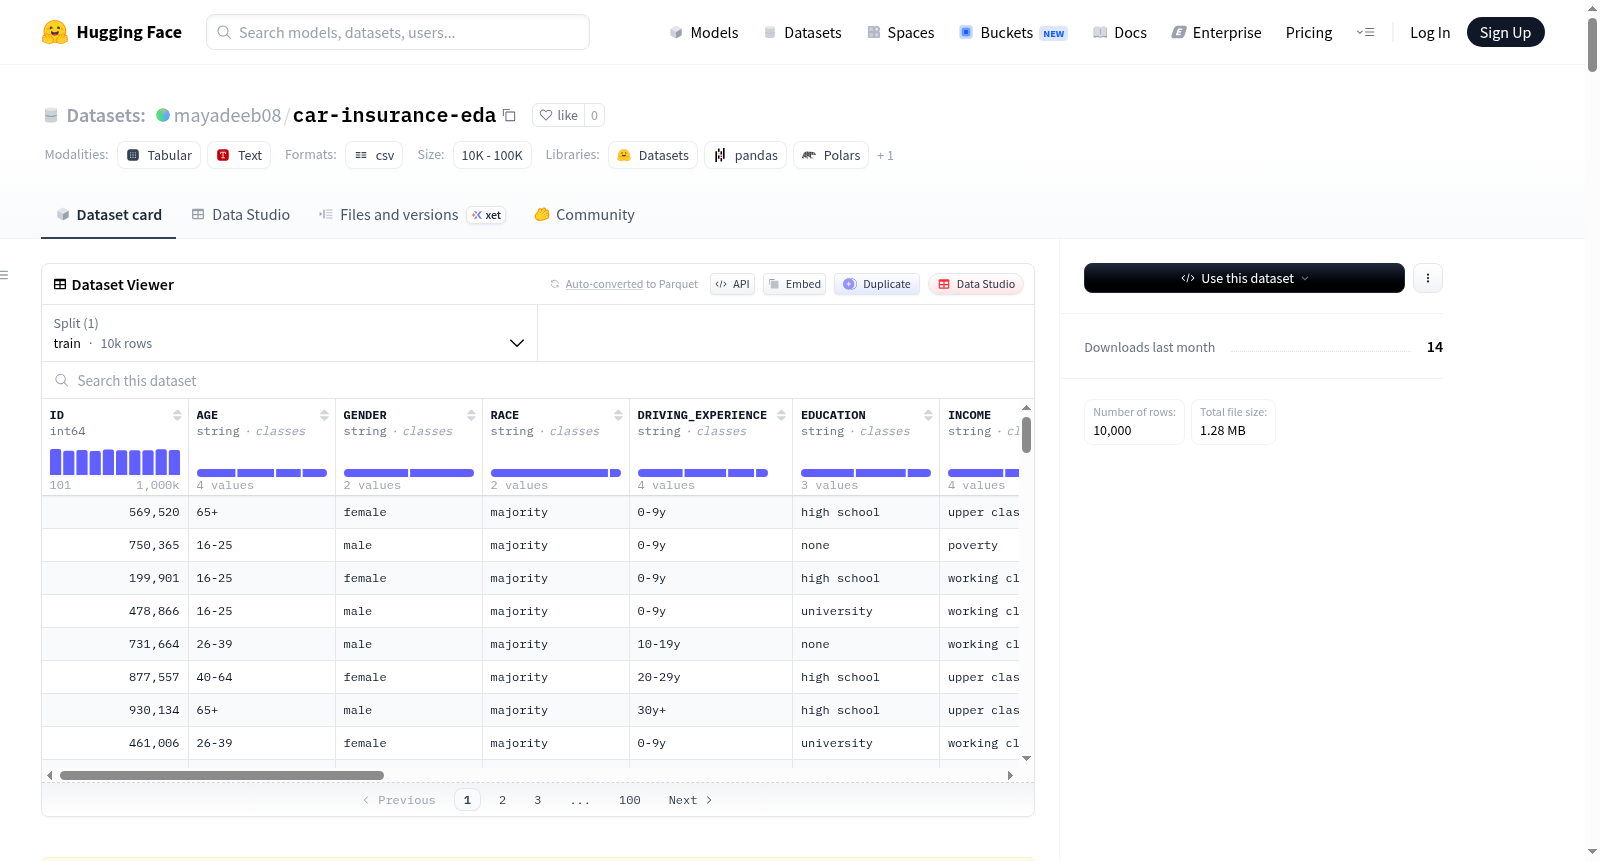
This dataset is named *Auto Insurance Claim Dataset* and is sourced from Kaggle. It contains demographic, financial and driving-related personal information, with the objective of analyzing the factors affecting insurance claim behavior. The dataset primarily comprises numerical features including age group, credit score, driving experience, annual mileage, speeding violation records, drunk driving records, prior accident records, vehicle manufacturing year, vehicle type, number of children, marital status, and more. The target variable is "OUTCOME", where 0 represents no insurance claim and 1 represents a filed insurance claim. Data quality checks have been conducted on the dataset, including handling missing values, duplicate rows and data inconsistencies, while potential extreme values are retained to reflect real-world driving behaviors. Studies have revealed that insurance claim behavior is influenced by multiple factors such as age, credit score, vehicle manufacturing year, driving experience, and others. This dataset is suitable for statistical analysis and visualization tasks, and is particularly applicable for insurance risk prediction and decision support applications.
数据集概述
数据集基本信息
- 数据集名称: Car Insurance Claim Dataset
- 来源: Kaggle
- 原始链接: https://www.kaggle.com/datasets/sagnik1511/car-insurance-data
- 目标变量: OUTCOME (0 = 无索赔,1 = 有索赔)
数据集内容
该数据集包含个人的 demographic、financial 和 driving-related 信息,主要变量包括:
- 年龄组
- 信用评分
- 驾驶经验
- 年行驶里程
- 超速违规次数
- 酒驾次数
- 过去事故次数
- 车辆年份
- 车辆类型
- 子女数量
- 婚姻状况
数据集主要包含数值型特征,适合进行统计分析和可视化。
数据质量与预处理
- 缺失值: 大部分列无缺失值,少数列存在少量缺失条目。
- 重复行: 未发现重复行。
- 不一致性: 分类列检查后未发现不一致、拼写错误或不规则值。
- 日期解析: 数据集中未发现日期或时间相关特征,无需日期解析。
- 异常值处理: 对 ANNUAL_MILEAGE、SPEEDING_VIOLATIONS、DUIS、PAST_ACCIDENTS 等变量进行了异常值检测。极端值未被移除,因其可能代表真实的高风险驾驶行为而非数据错误。
分析决策
- 在描述性统计和相关性分析中排除了 ID 和 POSTAL_CODE,因其非有意义的预测特征。
- 年龄变量从分类范围转换为有序数值(0–3),以保留年龄组的自然顺序并简化分析和可视化。
主要发现与洞察
1. 索赔分布
- 数据集在保险索赔方面不平衡:未提出索赔(OUTCOME = 0)的个体数量显著多于提出索赔(OUTCOME = 1)的个体。
2. 年龄影响
- 年轻个体提出保险索赔的可能性更高。
3. 车辆年份影响
- 拥有**较旧车辆(2015年之前)**的个体提出保险索赔的可能性更高。
4. 信用评分影响
- 提出保险索赔的个体倾向于拥有较低的信用评分,而未提出索赔的个体通常拥有较高的信用评分。
5. 子女与驾驶经验
- 驾驶经验较少的个体索赔率较高,无论其是否有子女。
- 在经验较丰富的驾驶员中,有子女的个体索赔率略低。
6. 信用评分与驾驶经验
- 信用评分低且驾驶经验少的个体索赔率最高。
- 信用评分高且驾驶经验丰富的个体索赔率显著较低。
7. 变量相关性
- 大多数变量呈现弱到中度的相关性,表明没有单一特征能强主导预测,索赔行为可能由多种因素共同影响。
总体结论
保险索赔行为受 demographic、financial 和 behavioral 等多重因素共同影响,而非单一主导变量。关键影响因素包括:年龄、信用评分、车辆年份和驾驶经验。特别是信用评分与驾驶经验的组合能有效区分高风险与低风险个体。
文件包含
该 Hugging Face 数据集仓库包含:
- 原始数据集文件
- Jupyter Notebook (
.ipynb) - README 文件
- 演示视频