swebench_verified_random_100_folders_g1_a1_top16_32b_step600_20260819_162257
收藏资源简介:
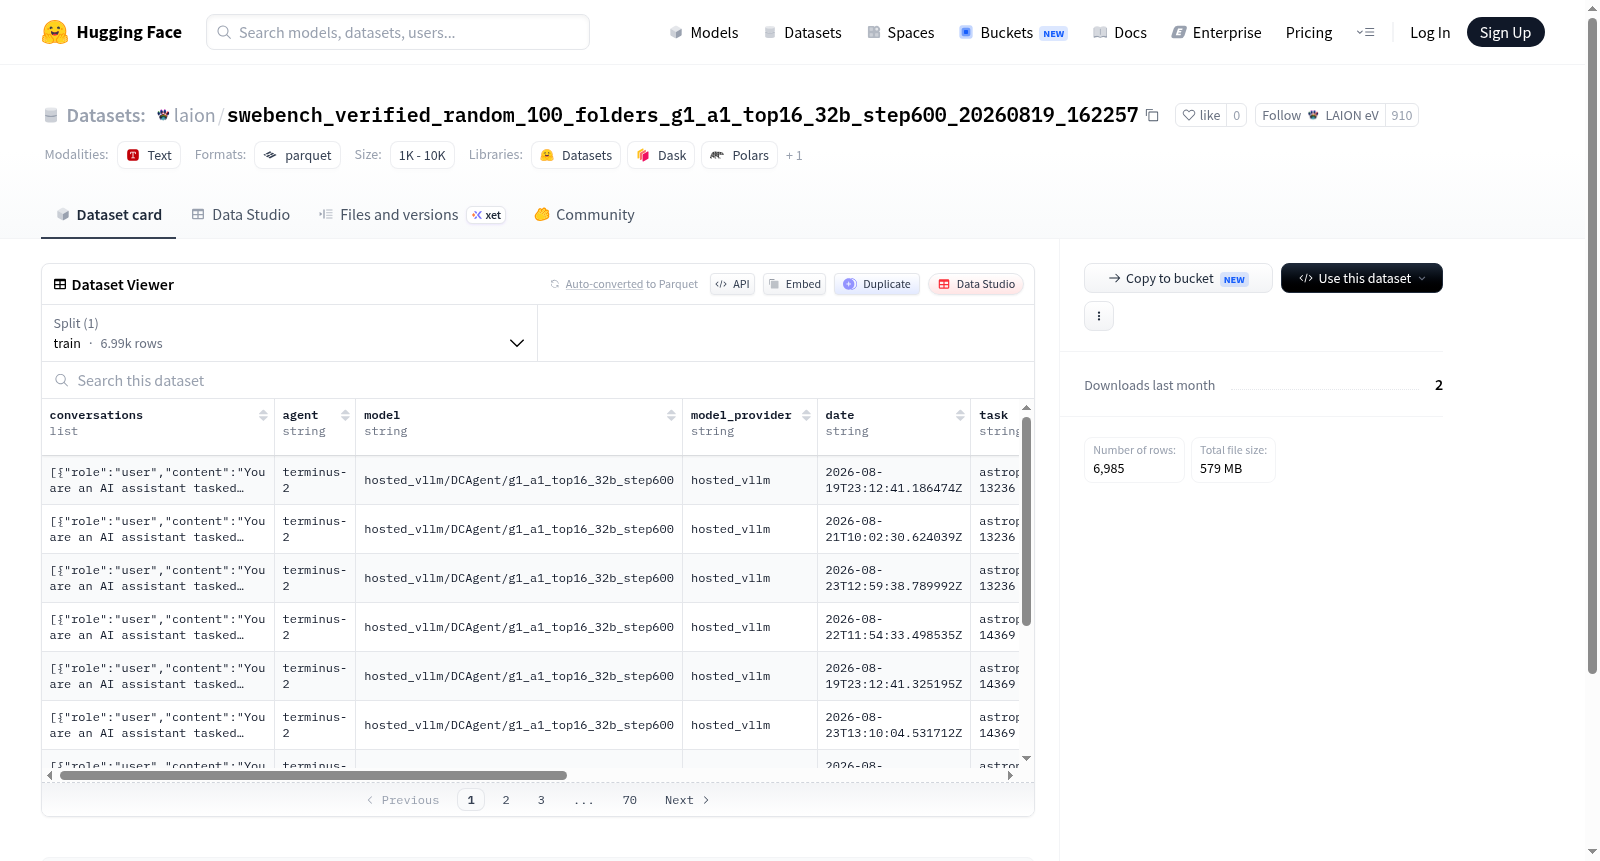
该数据集包含多轮对话轨迹,每条记录由对话列表(conversations)和丰富的元数据组成。每轮对话包含角色(role)和内容(content)。元数据包括:代理标识(agent)、模型名称(model)、模型提供商(model_provider)、日期(date)、任务描述(task)、会话期数(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及追踪来源(trace_source)。数据集共包含6985个样本,仅提供训练集划分,总大小约1.48GB。适用于对话代理评估、任务完成分析、模型行为审计等研究场景。
This dataset contains multi-turn dialogue trajectories, each record consisting of a list of conversations and rich metadata. Each turn includes role and content. Metadata includes: agent identifier, model name, model provider, date, task description, episode, run ID, trial name, result, verifier output, and trace source. The dataset contains 6985 samples, only providing a training set split, with a total size of approximately 1.48GB. It is suitable for research scenarios such as dialogue agent evaluation, task completion analysis, and model behavior auditing.
数据集概述:laion/swebench_verified_random_100_folders_g1_a1_top16_32b_step600_20260819_162257
该数据集托管于 Hugging Face,由 LAION 组织发布,旨在记录和评估 SWE-bench 任务中某个模型(推测为 32B 规模的模型)在验证集上的交互轨迹与结果。
基本信息
- 数据集名称:swebench_verified_random_100_folders_g1_a1_top16_32b_step600_20260819_162257
- 任务类型:SWE-bench(软件工程基准测试)任务轨迹数据,包含多轮对话和执行结果。
- 数据规模:训练集包含 6,985 条样本,数据集总大小约 1.48 GB(解压后),下载大小约 579 MB。
数据特征
每条样本包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表(list) | 包含多轮对话,每轮对话包含 role(角色)和 content(内容)两个字符串字段 |
agent |
string | 执行任务的智能体名称或标识 |
model |
string | 使用的模型名称 |
model_provider |
string | 模型提供方 |
date |
string | 数据记录日期 |
task |
string | 具体任务标识 |
episode |
string | 任务轮次或场景编号 |
run_id |
string | 运行标识号 |
trial_name |
string | 试验名称 |
result |
string | 任务执行结果(如通过/失败) |
verifier_output |
string | 验证器输出的详细信息 |
trace_source |
string | 轨迹数据的来源或记录方式 |
数据划分
- 单一划分:仅包含
train划分,共 6,985 个样本。
数据格式与结构
- 默认配置名为
default,数据文件位于data/train-*,采用分片存储(sharded parquet 格式)。 - 该数据集的显著特点是记录了完整的智能体-模型对话历史,适合用于研究模型在软件工程任务中的推理过程、错误模式及改进策略。
使用场景建议
- 分析模型在真实软件工程问题上的表现与失败原因。
- 微调或评估代码生成与修复模型。
- 研究多轮交互中的决策过程及验证器反馈的作用。