
遇见数据集

conversation-starter-eval_de-DE

收藏
Hugging Face2026-07-10 更新2026-07-11 收录
官方服务:

资源简介:

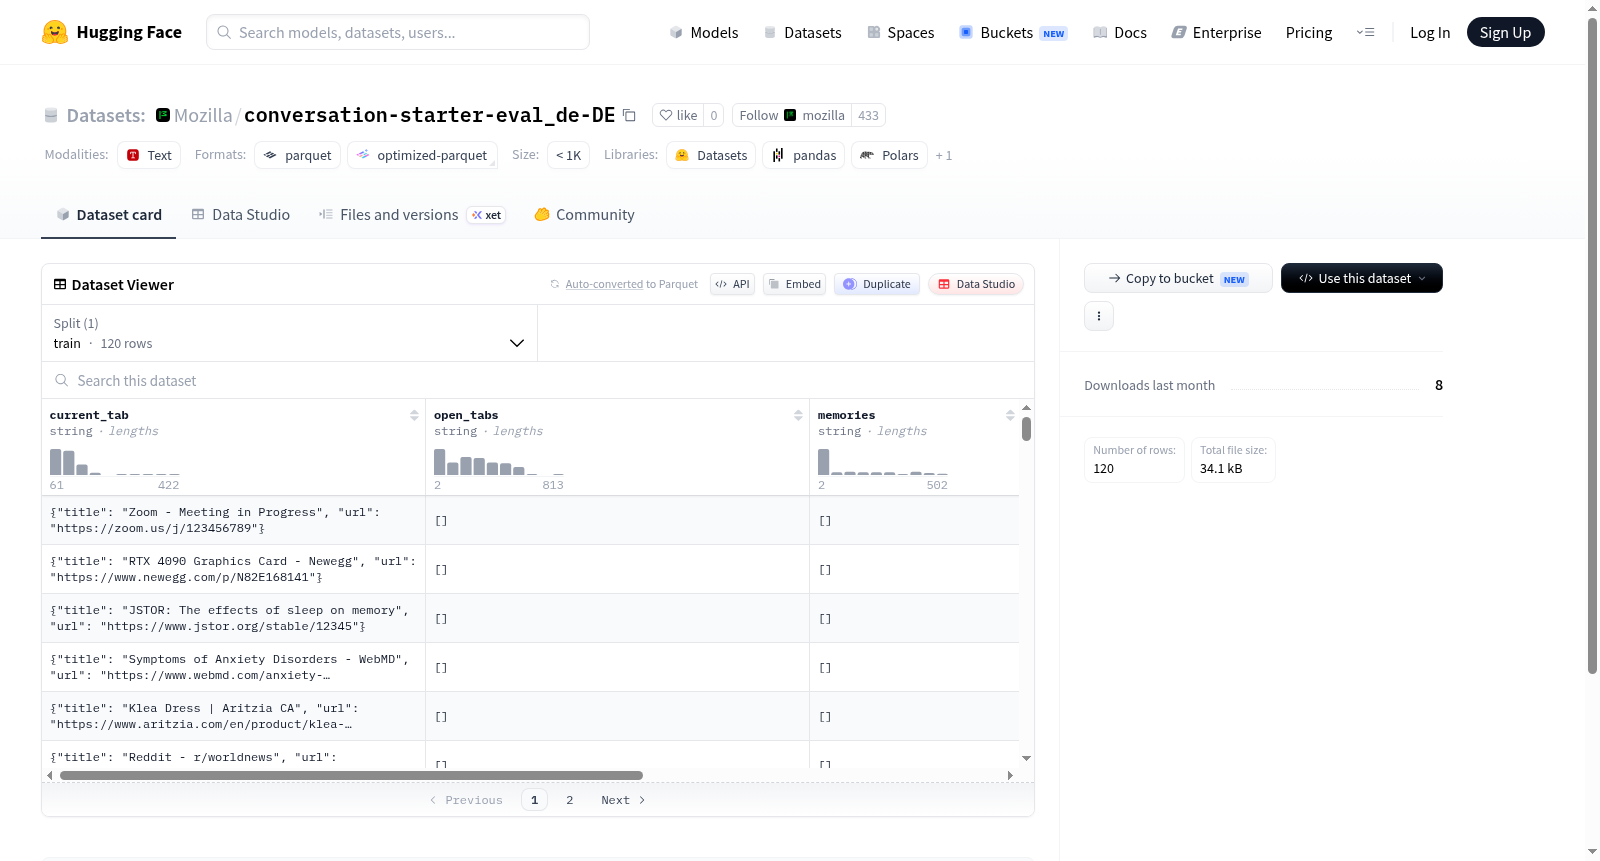
该数据集包含120个训练样本,主要用于记录与浏览器标签页管理和用户交互相关的信息。每个样本包含七个字段:current_tab(当前标签页)、open_tabs(已打开的标签页)、memories(记忆/历史记录)、date(日期)、uuid(唯一标识符)、is_for_human_eval(是否用于人工评估)和locale(地区/语言设置)。从字段推断,数据集可能支持网页导航分析、用户行为建模或多语言界面交互等任务。所有字段均为文本类型,仅is_for_human_eval为布尔值。数据集仅包含训练集,总大小约67KB。

This dataset contains 120 training samples, primarily used to record information related to browser tab management and user interactions. Each sample includes seven fields: current_tab (current tab), open_tabs (open tabs), memories (memories/historical records), date (date), uuid (universally unique identifier), is_for_human_eval (for human evaluation), and locale (locale/language settings). Based on these fields, the dataset can potentially support tasks such as web navigation analysis, user behavior modeling, and multilingual interface interaction. All fields are of text type, except for is_for_human_eval which is a boolean value. The dataset only includes a training set, with a total size of approximately 67 KB.

创建时间:
2026-07-09
原始信息汇总
  • 数据集名称:Mozilla/conversation-starter-eval_de-DE
  • 数据集语言:德语(de-DE)
  • 数据集大小:下载大小约31.07 KB,数据集总大小约67.02 KB
  • 数据划分:仅包含训练集(train),共120条样本
  • 特征字段
    • current_tab:字符串类型,可能表示当前标签页内容
    • open_tabs:字符串类型,可能表示已打开的标签页内容
    • memories:字符串类型,可能表示记忆或上下文信息
    • date:字符串类型,表示日期
    • uuid:字符串类型,唯一标识符
    • is_for_human_eval:布尔类型,表示是否用于人工评估
    • locale:字符串类型,表示语言区域
  • 数据用途:该数据集主要用于评估对话启动器(conversation starter)的效果,包含人工评估标记。
搜集汇总
数据集介绍
conversation-starter-eval_de-DE 数据集图片
构建方式
该数据集名为conversation-starter-eval_de-DE,专为德语对话起始评估而设计。构建方式源自对多模态人机交互场景的模拟,通过采集用户在浏览器环境中的行为痕迹(如当前标签页、已打开标签页列表、记忆片段及时间戳)作为上下文,由人工标注生成对话起始问题。数据共包含120个训练样本,每个样本均带有唯一标识符(uuid)及是否为人类评估标志(is_for_human_eval),并统一限定德语区域(locale为de-DE),确保了数据在文化适应性上的纯净性。
使用方法
数据集默认仅包含train拆分,可通过HuggingFace Datasets库直接加载,使用load_dataset('conversation-starter-eval_de-DE')命令即可获取。应用时,研究者可将每行样本中的current_tab、open_tabs与memories作为参考上下文,利用date字段过滤时间敏感性实验,搭配is_for_human_eval标志区分人工评估或自动评估场景。由于无预设拆分,实践者通常采用随机划分或交叉验证策略,在德语对话起始生成模型上测试其上下文感知能力。
背景与挑战
背景概述
在自然语言处理领域,对话系统的研究日益受到关注,尤其是在多语言环境下的交互能力评估方面。该数据集conversation-starter-eval_de-DE创建于近期,由相关研究机构开发,专注于德语环境的对话起始评估。其核心研究问题在于如何通过结构化的对话样本,系统性地测试对话模型在不同上下文(如当前标签页、打开标签页、记忆信息)下的响应能力。该数据集包含120个训练样本,涵盖了丰富的对话特征,为德语对话系统的性能评估提供了标准化基准,对推动多语言对话技术的进步具有重要意义。
当前挑战
该数据集面临的挑战主要体现在两个层面。在领域问题层面,它致力于解决对话系统在德语环境中生成自然、上下文相关的起始语句的难题,这对于提升用户交互体验至关重要,因为不自然的起始语句会破坏对话的连贯性。在构建过程中,挑战在于如何从有限的120个样本中获取足够多样化的对话场景,并确保每个样本的标签(如是否用于人工评估)和结构化特征(如记忆信息)能够准确反映真实对话复杂性,同时保持数据的高质量和低偏差,这对后续模型训练的有效性提出了较高要求。
常用场景
经典使用场景
在对话系统与自然语言处理研究领域,conversation-starter-eval_de-DE数据集为评估德语对话起始句质量提供了标准化的测试基准。该数据集包含120条精心标注的德语训练样本,每条样本记录了当前对话标签、已打开标签页、对话记忆、日期及唯一标识符等信息,特别设计了是否用于人工评估的布尔标记。研究者可利用该数据集系统性地测试和比较不同对话生成模型在德语环境下产生自然、连贯且语境相关的对话起始句的能力,尤其适用于评估基于检索和基于生成的两种主流对话系统架构。数据集的简洁结构和明确的任务定义使其成为德语对话起始句生成与评估任务中的标杆性测试集。
解决学术问题
该数据集精准解决了德语对话系统研究中缺乏标准化评估语料的关键困境。在学术研究层面,它填补了德语会话起始句自动评估领域的空白,为量化对话系统的语境理解能力、记忆利用能力和上下文连贯性提供了可靠的评估基础。通过提供人工评估标记,研究者能够区分自动评估与人工评估之间的差异,从而更深入地分析模型在真实交互场景中的表现。这一数据集的建立推动了跨语言对话评估研究的发展,使德语对话系统研究得以借鉴和对接英语领域的评估方法,促进了多语言自然语言处理理论的完善与验证。
实际应用
在实际应用层面,conversation-starter-eval_de-DE数据集能够为德语智能客服系统、虚拟助手和社交机器人提供对话起始句的定制化评估工具。企业开发团队可以利用该数据集筛选和优化能够有效启动用户对话的问候语或开场白,提升用户参与度与满意度。在德语教学场景中,该数据集可用于训练能够根据学生历史对话内容生成适当学习互动的语言教育机器人。此外,数据集中包含的时间戳和记忆字段使其在构建个性化对话系统的落地部署中具有独特价值,帮助系统更好地理解用户长期行为模式,实现有记忆、有上下文的智能交互。
数据集最近研究
最新研究方向
在对话系统与个性化交互研究的前沿,conversation-starter-eval_de-DE数据集为德语言语生成与情境感知对话启动提供了关键评估基准。当前热点聚焦于大语言模型在多轮对话中的记忆保持与上下文利用能力,该数据集通过记录当前标签页、开放标签页及记忆特征,模拟真实浏览器场景下的对话起始任务,尤其适合探索时间感知与用户行为建模的深度融合。其评估设计兼顾自动指标与人工评判,推动了低资源语言对话系统的鲁棒性研究,并为跨模态、跨场景的对话策略优化奠定了实验基础,对提升AI在复杂多任务环境中的自然交互质量具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


