
遇见数据集

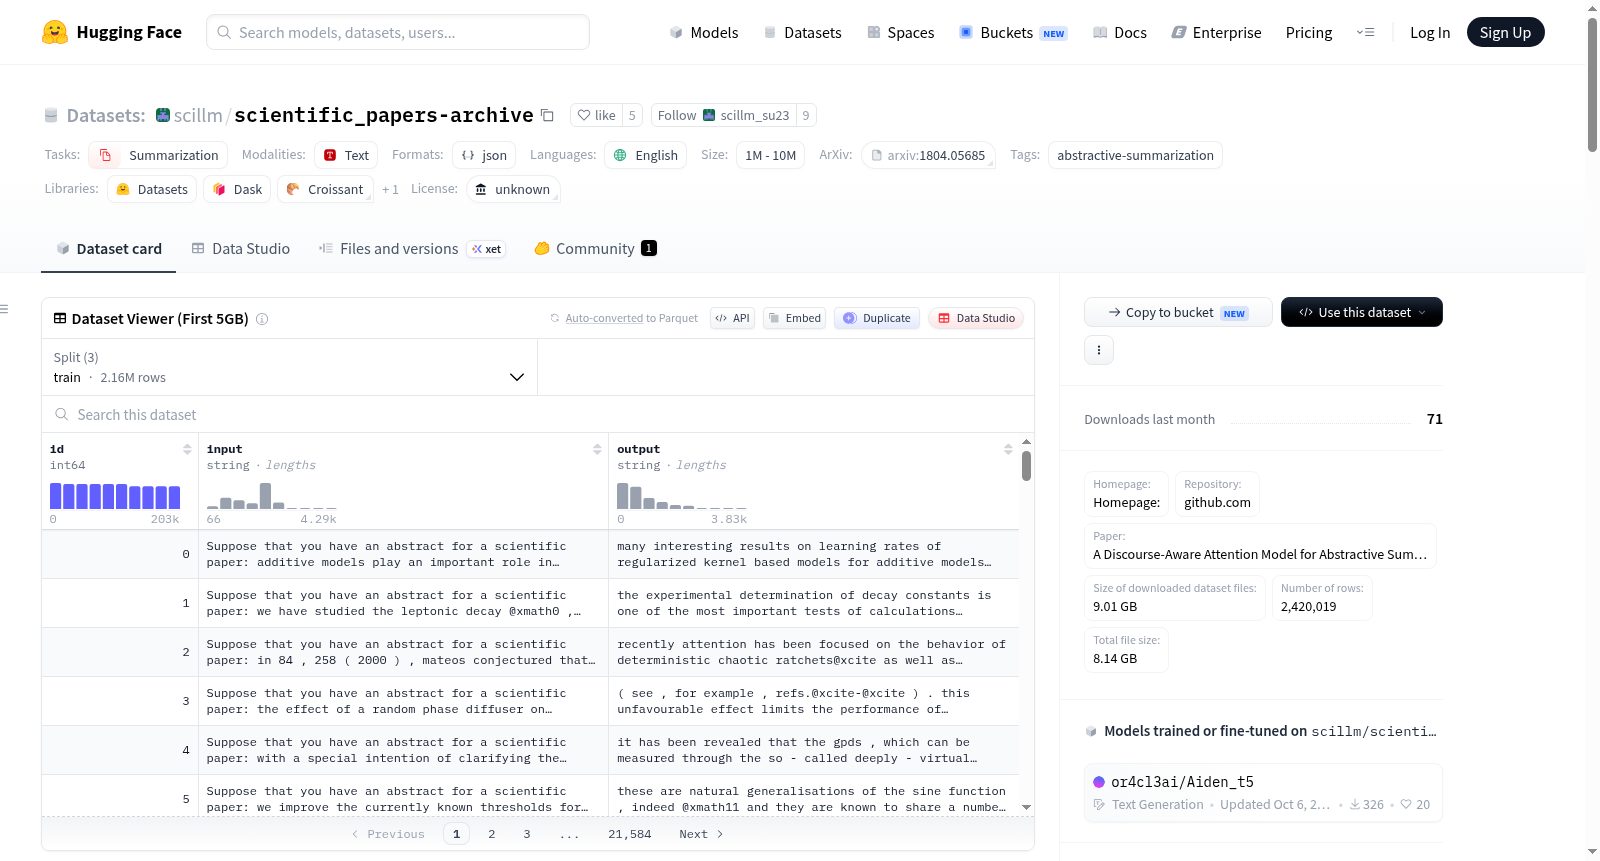
scillm/scientific_papers-archive

收藏
Hugging Face2023-09-07 更新2024-03-04 收录
官方服务:

资源简介:

ScientificPapers数据集包含来自ArXiv和PubMed OpenAccess仓库的两组长文档数据。每个文档包含三个特征:文章正文、摘要和章节标题,段落之间用/n分隔。数据集主要用于摘要生成任务,且为单语种(英语)。数据集的规模较大,包含超过10万条数据记录。

The ScientificPapers dataset includes two sets of long-form document data sourced from the ArXiv and PubMed OpenAccess repositories. Each document contains three features: the full article body, abstract, and section titles, with paragraphs separated by newline characters. This dataset is primarily intended for abstract generation tasks, and it is a monolingual (English-only) corpus with a large scale, containing over 100,000 data records.

提供机构:
scillm
原始信息汇总

数据集概述

  • 数据集名称: ScientificPapers
  • 语言: 英语(English)
  • 多语言性: 单语(Monolingual)
  • 许可证: 未知(Unknown)
  • 大小: 100K<n<1M
  • 源数据集: 原始数据(Original)
  • 任务类别: 摘要生成(Summarization)
  • 标签: 抽象摘要(Abstractive-Summarization)

数据集结构

配置名称

  • arxiv
  • pubmed

数据特征

  • article: 字符串类型,文档主体,段落以"/n"分隔。
  • abstract: 字符串类型,文档摘要,段落以"/n"分隔。
  • section_names: 字符串类型,章节标题,以"/n"分隔。

数据分割

名称 train validation test
arxiv 203037 6436 6440
pubmed 119924 6633 6658

数据集大小

  • arxiv:
    • 下载大小: 4.50 GB
    • 数据集大小: 7.58 GB
  • pubmed:
    • 下载大小: 4.50 GB
    • 数据集大小: 2.51 GB

数据集创建

  • 源数据: 来自ArXiv和PubMed OpenAccess仓库。

  • 许可证信息: 未知,需要更多信息。

  • 引用信息:

    @article{Cohan_2018, title={A Discourse-Aware Attention Model for Abstractive Summarization of Long Documents}, url={http://dx.doi.org/10.18653/v1/n18-2097}, DOI={10.18653/v1/n18-2097}, journal={Proceedings of the 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 2 (Short Papers)}, publisher={Association for Computational Linguistics}, author={Cohan, Arman and Dernoncourt, Franck and Kim, Doo Soon and Bui, Trung and Kim, Seokhwan and Chang, Walter and Goharian, Nazli}, year={2018} }

贡献者
搜集汇总
数据集介绍
scillm/scientific_papers-archive 数据集图片
构建方式
ScientificPapers数据集源自ArXiv和PubMed两大开放获取学术论文库,旨在为长文本摘要生成任务提供高质量语料。构建过程中,研究者从这两个平台收集了海量学术论文,并精心提取了论文的正文(article)、摘要(abstract)以及章节标题(section_names)三个核心字段。其中,正文和摘要均以换行符分隔段落,而章节标题则记录了论文的结构化信息。数据集被划分为训练、验证和测试三部分,其中ArXiv子集包含约20.3万训练样本、6436个验证样本和6440个测试样本,PubMed子集则包含约12万训练样本、6633个验证样本和6658个测试样本,确保了模型训练与评估的充分性。
特点
该数据集最显著的特点在于其专注于长文档的抽象式摘要生成任务,填补了现有数据集在长篇科学文献领域的空白。ArXiv和PubMed两个子集分别涵盖了物理学、数学、计算机科学以及生物医学等多个学科领域,内容具有高度的专业性和多样性。每个样本均包含完整的论文正文、对应的摘要以及结构化的章节标题,这种多字段设计不仅支持传统的摘要生成任务,还能用于探索文档结构与摘要内容之间的关联。此外,数据集规模庞大,总磁盘占用超过10GB,为训练大规模神经网络模型提供了充足的数据基础。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库轻松加载,指定配置名称为'arxiv'或'pubmed'即可获取对应子集。每个样本包含'article'、'abstract'和'section_names'三个字段,可直接用于序列到序列模型的训练与评估。在预处理阶段,建议对长文本进行适当的分段或截断处理,以适应模型的最大输入长度限制。该数据集特别适用于开发面向科学文献的自动摘要系统,也可用于研究文档结构理解、关键信息抽取等自然语言处理任务。研究者可参考Cohan等人(2018)的论文,了解基于该数据集的基线模型与评估方法。
背景与挑战
背景概述
ScientificPapers数据集由Arman Cohan等研究者在2018年构建,源自ArXiv和PubMed的开放获取仓库,旨在推动长文本抽象摘要任务的发展。该数据集收录了逾32万篇科学论文,每篇包含完整的文章正文、摘要及章节标题,为处理高度结构化、篇幅冗长的学术文献提供了基准资源。其发布标志着自然语言处理领域从短文本摘要向长文档、多层级结构摘要的范式转变,显著影响了后续基于注意力机制与篇章建模的模型设计,成为评估长文本理解与生成能力的重要标杆。
当前挑战
该数据集面临的核心挑战在于长文本摘要任务中篇章结构的有效建模与信息压缩。科学论文的章节间存在复杂的逻辑依赖关系,传统序列模型难以捕捉跨段落的语义连贯性。构建过程中,从海量PDF中提取纯净文本面临格式噪声与数学符号干扰,需设计鲁棒的解析管道。此外,数据集的规模与多样性虽为模型训练提供基础,但摘要质量评估指标(如ROUGE)难以全面反映学术摘要的精确性与完整性,且不同学科术语的分布差异可能引入领域偏倚,制约模型的泛化能力。
常用场景
经典使用场景
Scientific Papers Archive 数据集由 ArXiv 和 PubMed 两大开放获取知识库中的长篇学术文献构成,每篇样本均包含完整的正文、结构化摘要以及章节标题信息。该数据集最经典的使用场景是面向长文档的抽象式摘要生成任务,研究人员可借助其丰富且规整的篇章结构,训练模型捕捉长文本中的层级化语义与递进式逻辑,从而生成高度凝练且忠于原文的学术摘要。此外,该数据集亦被广泛用于篇章级文本理解与结构化内容挖掘的研究中。
实际应用
在实际应用中,该数据集训练出的摘要模型可部署于学术搜索引擎、文献管理平台以及科研知识图谱构建系统,自动为海量的研究论文生成精炼的概要,大幅降低科研人员的信息筛选负担。例如,在 PubMed 数据库中,该模型能够辅助医生或生物学家快速获取医学论文的核心发现;在 ArXiv 预印本平台上,模型可帮助研究者迅速追踪跨学科前沿动态,从而加速科学发现与知识传播的进程。
衍生相关工作
围绕该数据集,学术界衍生出一系列具有标志性的研究工作。Cohan 等人首先提出了面向长文档的篇章感知注意力模型,开创性地将章节结构信息融入抽象式摘要生成过程。后续研究进一步拓展了其应用边界,包括引入分层 Transformer 架构以处理超长序列、利用强化学习优化摘要的覆盖率和冗余度,以及结合对比学习增强摘要的多样性与忠实度。这些工作不仅深化了人们对长文本生成机制的理解,也为构建更智能的学术信息处理工具奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

