
child-dpo-preferences-synthetic
收藏官方服务:
资源简介:
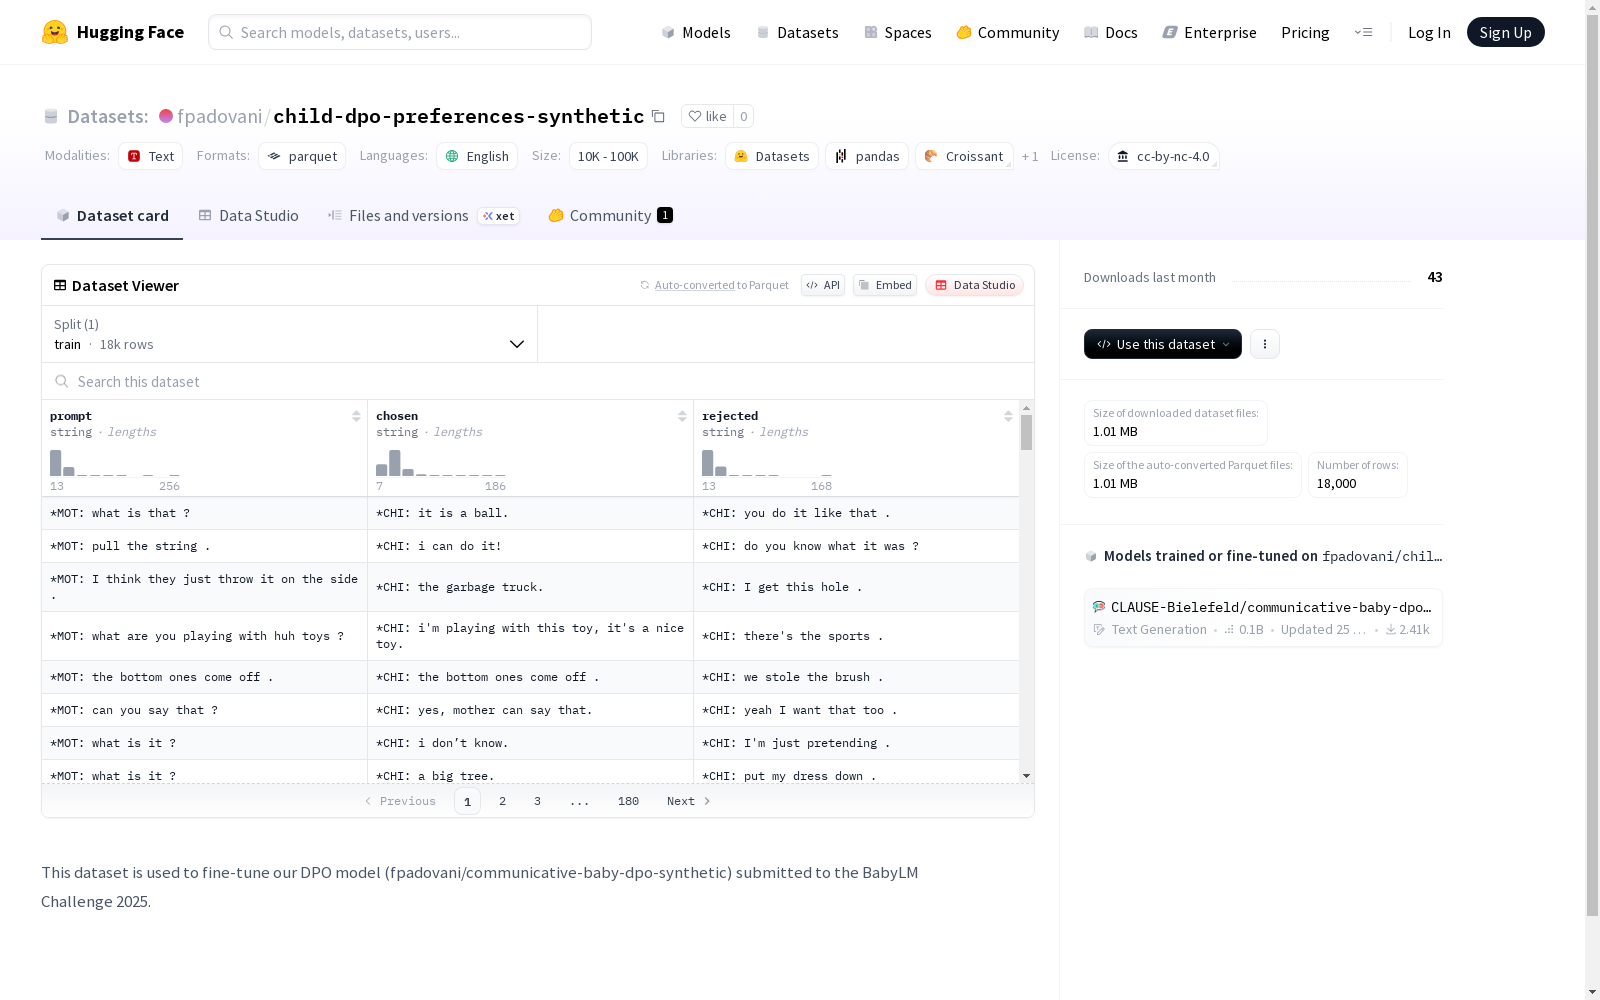
该数据集包含三个字段:prompt、chosen和rejected,均为文本类型。数据集分为训练集,共有18000个示例。数据集的总大小为1916370字节,下载大小为1009103字节。由于README没有提供详细描述,具体内容、用途和来源不详。
This dataset comprises three fields: prompt, chosen, and rejected, all of which are text-type data. The dataset is partitioned into a training set with a total of 18,000 examples. The total size of the dataset is 1,916,370 bytes, and the download size is 1,009,103 bytes. Since no detailed description is provided in the README file, the specific content, intended use, and source of the dataset remain unknown.
创建时间:
2025-07-16
原始信息汇总
数据集概述
基本信息
- 数据集名称: child-dpo-preferences-synthetic
- 下载大小: 1009103字节
- 数据集大小: 1916370字节
数据结构
- 特征:
prompt: 字符串类型chosen: 字符串类型rejected: 字符串类型
数据划分
- 训练集:
- 样本数量: 18000
- 字节大小: 1916370
配置信息
- 默认配置:
- 数据文件路径:
data/train-*
- 数据文件路径:
搜集汇总
数据集介绍
构建方式
在儿童语言习得研究领域,child-dpo-preferences-synthetic数据集通过合成方法构建,专为直接偏好优化(DPO)模型训练设计。该数据集包含18,000个训练样本,每个样本由提示文本、优选回复和劣选回复三元组构成,数据以字符串格式存储,总规模约1.92MB,采用CC-BY-NC-4.0许可协议确保学术使用的合规性。
特点
该数据集的核心特征体现在其针对儿童语言交互场景的针对性设计,所有文本均为英文语境。三元组结构直接支持偏好学习任务,优选与劣选回复的对比为模型提供了明确的学习信号。数据集结构简洁而高效,每个样本包含prompt、chosen和rejected三个关键字段,为DPO算法提供了标准化的输入格式。
使用方法
研究人员可将该数据集应用于直接偏好优化模型的微调训练,特别适用于儿童导向的语言模型开发。使用时应加载train分割的全部样本,将prompt作为输入,chosen和rejected分别作为正负样本进行对比学习。该数据集专为BabyLM Challenge 2025竞赛设计,可作为基础训练资源用于提升模型在儿童语言理解任务中的表现。
背景与挑战
背景概述
儿童语言模型偏好数据集child-dpo-preferences-synthetic诞生于2025年BabyLM挑战赛的学术背景之下,由研究人员fpadovani主导构建。该数据集聚焦于低资源环境下儿童语言习得的建模问题,旨在通过直接偏好优化(DPO)方法提升模型对人类偏好的对齐能力。其核心研究在于探索合成数据在语言模型训练中的有效性,为发展心理学与计算语言学的交叉研究提供了关键数据支撑,推动了适应性语言模型在教育领域的应用进展。
当前挑战
该数据集致力于解决儿童导向语言模型中偏好对齐的复杂性问题,其核心挑战在于如何通过有限样本准确捕捉人类偏好信号。构建过程中面临合成数据质量控制的难题,需确保生成响应的自然性与教育适宜性;同时需克服偏好标注的一致性约束,避免主观偏差对模型训练的干扰。此外,在低资源条件下平衡数据的多样性与准确性,亦是该数据集构建过程中的重要技术瓶颈。
常用场景
经典使用场景
在儿童语言习得研究领域,child-dpo-preferences-synthetic数据集被广泛用于直接偏好优化(DPO)模型的训练与评估。该数据集通过合成方式生成大量提示-回应对,其中包含被选中的优质回应与被拒绝的次优回应,为模型学习人类偏好提供了结构化数据基础。研究者利用该数据集训练模型区分语言表达的质量,进而模拟儿童语言发展过程中的选择机制。
衍生相关工作
该数据集衍生了BabyLM Challenge 2025参赛模型fpadovani/communicative-baby-dpo-synthetic等一系列重要工作。这些研究聚焦于通过DPO框架优化儿童导向的语言模型,推动了发展性自然语言处理领域的进展。相关成果为构建更符合儿童认知特点的AI系统提供了方法论支持,并激发了关于合成数据在语言习得研究中应用效度的深入探讨。
数据集最近研究
最新研究方向
在儿童语言习得与人工智能交叉领域,child-dpo-preferences-synthetic数据集正推动直接偏好优化(DPO)方法的前沿探索。该数据集通过合成生成的偏好对比数据,为BabyLM Challenge 2025提供关键训练资源,旨在模拟儿童语言认知过程中的选择机制。当前研究聚焦于如何利用此类合成数据提升模型对自然语言偏好的理解能力,特别是在低资源情境下的泛化性能。这一方向与认知科学中的人类学习理论紧密结合,为构建更符合人类价值观的对话系统提供了实验基础,同时也引发了关于合成数据真实性验证与伦理对齐的热议。
以上内容由遇见数据集搜集并总结生成


