ipfs_slovenia_laws
收藏资源简介:
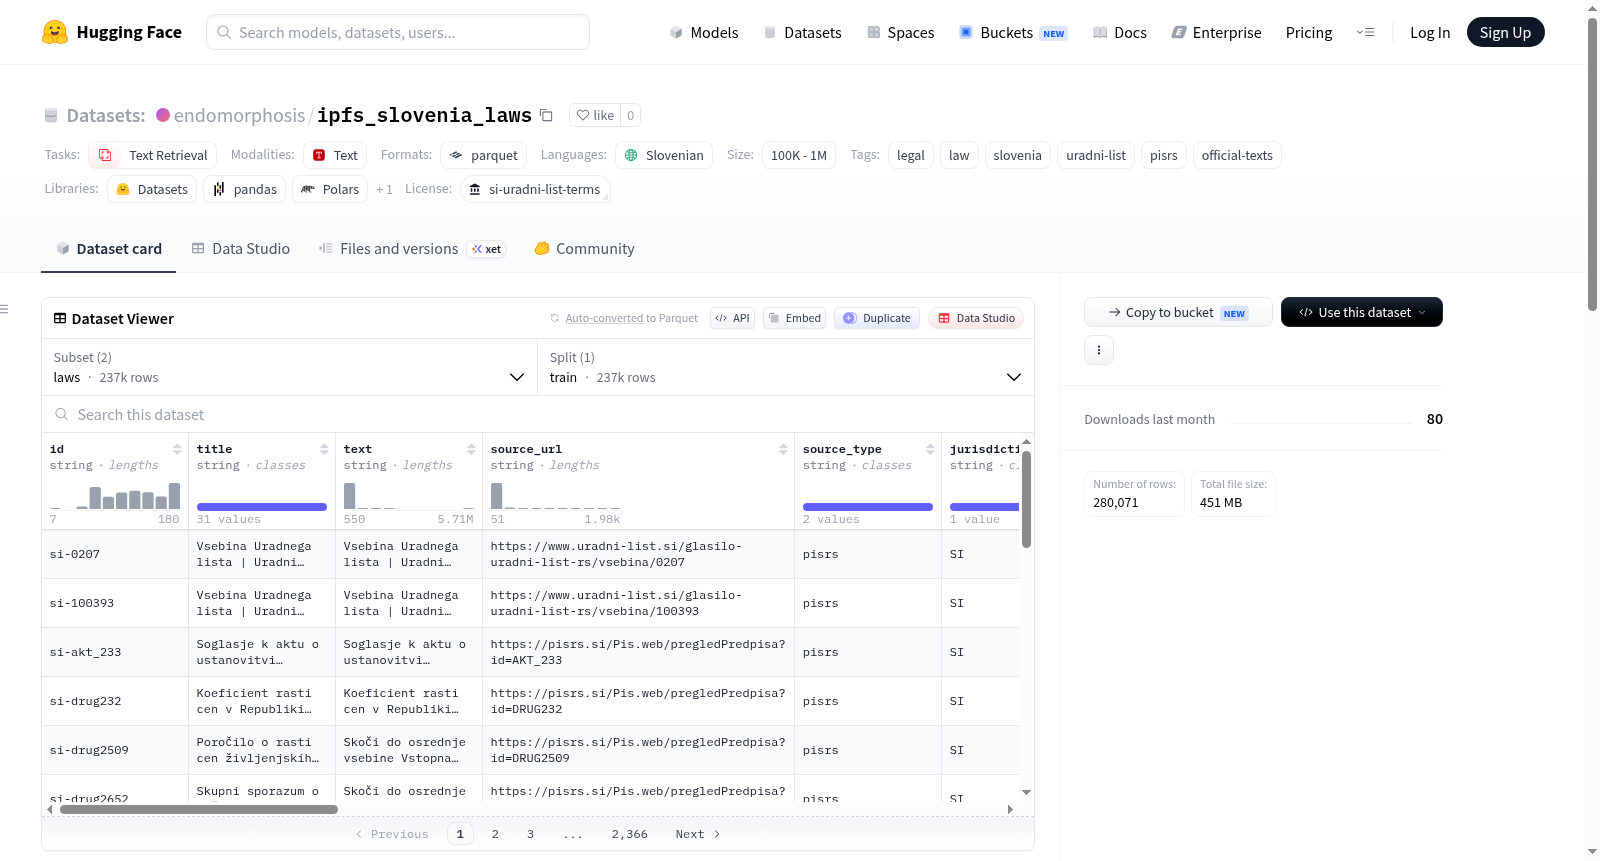
该数据集是斯洛文尼亚共和国官方公报(Uradni list Republike Slovenije,网址 uradni-list.si)上发布的官方立法的研究快照。数据集包含两个配置:laws(法律/文书)和 articles(条款/节)。laws 配置包含每个法律/文书一行,字段包括 ID、标题、全文、ELI(欧洲法律标识符)、日期、状态、标识符、条款数量和来源 URL。articles 配置包含每个条款/节一行,字段包括法律 ID、条款编号、标题、文本和来源 URL。数据规模:17406 条法律/文书,4526 条条款。语言为斯洛文尼亚语,司法管辖区为斯洛文尼亚。许可证为 slovenia-ul-official(官方政府/公报文本,可按照来源门户的公共部门条款重用)。该数据集仅供研究使用,并非官方整合,不构成法律建议,官方来源优先。适用任务包括法律文本检索、信息抽取、法律分析等。
This dataset is a research snapshot of official legislation published in the Official Gazette of the Republic of Slovenia (Uradni list Republike Slovenije, website uradni-list.si). The dataset contains two configurations: laws (legal acts/documents) and articles (clauses/sections). The laws configuration contains one row per legal act/document, with fields including ID, title, full text, ELI (European Legislation Identifier), date, status, identifier, number of articles, and source URL. The articles configuration contains one row per clause/section, with fields including law ID, article number, title, text, and source URL. Data size: 17,406 laws/documents, 4,526 articles. The language is Slovenian, and the jurisdiction is Slovenia. The license is slovenia-ul-official (official government/gazette text, reusable under the public sector provisions of the source portal). This dataset is intended for research use only, is not an official compilation, does not constitute legal advice, and official sources take precedence. Applicable tasks include legal text retrieval, information extraction, legal analysis, etc.
斯洛文尼亚法律数据集(Uradni list RS)
数据集概览
该数据集为斯洛文尼亚官方立法研究快照,内容采集自斯洛文尼亚共和国官方公报(Uradni list Republike Slovenije, uradni-list.si)。数据集明确声明不构成法律建议,官方公报或政府门户网站内容优先于本语料库。
基本信息
| 项目 | 详情 |
|---|---|
| 快照日期 | 2026-09-03 |
| 覆盖范围 | 基于目录的完整发现UL期号-TOC采集 |
| 数据来源 | Uradni list Republike Slovenije (uradni-list.si) |
| 采集工具 | scrapers/collect_si.py |
| 法律/文书数量 | 17,406 |
| 条款数量 | 4,526 |
| 语言 | 斯洛文尼亚语(sl) |
| 司法辖区 | 斯洛文尼亚 |
| 许可证 | slovenia-ul-official(其他) |
数据内容
数据集包含两个配置,均为Parquet格式文件:
- laws(法律):
data/laws.parquet—— 每行对应一份法律文书,包含ID、标题、全文、ELI标识、日期、状态、标识符、条款数量及来源URL。 - articles(条款):
data/articles.parquet—— 每行对应一个条款/章节,包含法律ID(law_id)、条款编号、标题、正文及来源URL。
另附采集脚本 scrapers/collect_si.py(用于构建快照的研究采集器)及共享辅助脚本 scrapers/common.py。
许可与重用说明
- 官方政府/公报文本,可按来源门户网站的公共部门条款重用。
- 本数据集的打包、元数据及采集脚本仅供研究使用。
- 数据集不是官方整合版本,不构成法律建议,以官方来源为准。
备注
数据基于官方Uradni list RS的HTML内容,已完整获取发现的目录集。