wovenbytoyota-vai/CaST-Bench
收藏资源简介:
CaST-Bench是一个用于视频问答的基准测试数据集,专注于评估视觉语言模型在基于细粒度时空证据的因果链推理能力。该数据集提供人类验证的问答对,要求模型在给定视频和因果问题的情况下,不仅选择正确答案,还需识别并时空定位支撑答案的证据链,包括因果触发器和其下游效应。数据集包含MP4视频片段和JSONL格式的测试文件,每个条目包括视频文件名、问题、问题类型、场景类别、六个答案选项、正确答案以及时空证据链。问题类型涵盖因果解释、反事实推理、预测性预期和推断描述四大类,数据构建通过多阶段人机协作流程完成,并遵循严格的质量控制。数据集发布版本为v1,未来计划发布v2和在线排行榜。
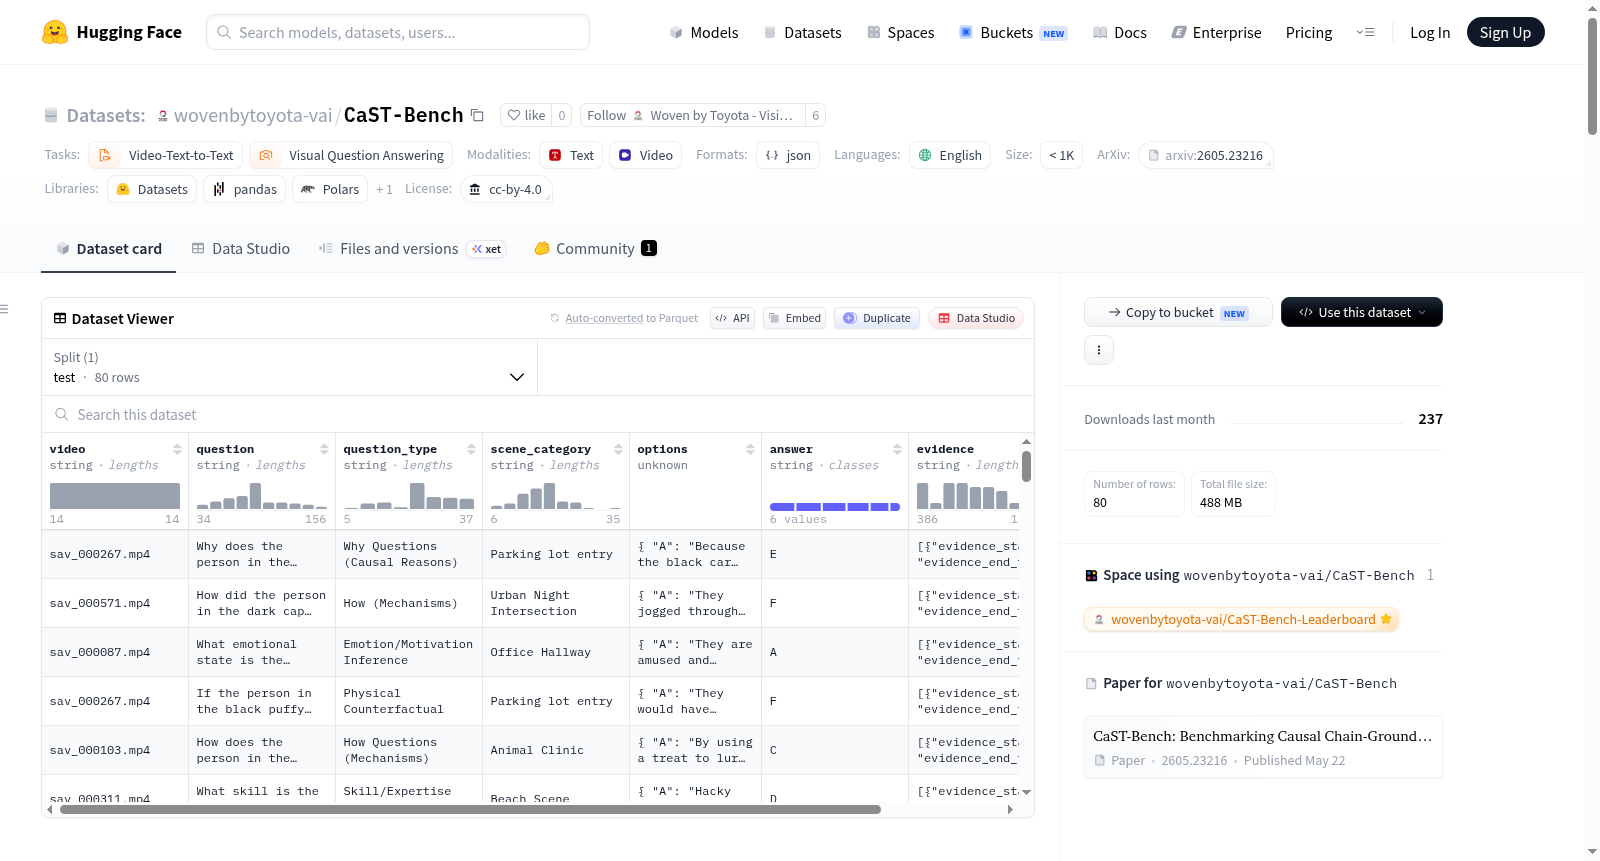
--- 展示名称: "CaST-Bench:面向视频问答的因果链锚定时空推理基准测试" 语言: - 英语 许可协议: cc-by-4.0 任务类别: - 视频-文本到文本 - 视觉问答 样本规模: - 样本数少于1000 标注生成者: - 专家标注 配置项: - 配置名称: 默认 数据文件: - 拆分集: 测试集 文件路径: castbench_hf.jsonl --- # CaST-Bench:面向视频问答的因果链锚定时空推理基准测试 这是**CaST-Bench**数据集的官方仓库,对应论文*"[CaST-Bench: Benchmarking Causal Chain-Grounded Spatio-Temporal Reasoning for Video Question Answering](https://arxiv.org/abs/2605.23216v1)"*。 CaST-Bench是首个在**锚定细粒度时空证据的因果链推理**任务上评估视觉语言模型(Vision-Language Models, VLMs)的基准测试。给定一段视频与一个因果问题,模型不仅需要选出正确答案,还需识别并时空定位支撑该答案的视觉证据链——涵盖因果触发事件及其下游效应。 本次发布提供了经过人工核验的精选问答对集合,用于快速且可靠地评估视觉语言模型的因果视频理解能力。 --- ## 最新动态 - **[2026-05-28] 版本1发布** — 我们正式公开发布**CaST-Bench v1**,即完整基准测试的精选子集。本次部分发布旨在作为参考版本,用于快速可靠地评估视觉语言模型。 - **[即将上线] 版本2发布** — 我们计划发布包含更多问答对的**CaST-Bench v2**。 - **[即将上线] 在线排行榜** — 我们将推出在线排行榜,用于追踪并对比模型在v1和v2版本上的性能表现。 --- ## 数据集结构 . ├── castbench_hf.jsonl # 测试集(人工核验的问答对) └── videos/ # 源自SAV的MP4视频片段 ### 数据字段 `castbench_hf.jsonl`中的每一行都是一个JSON对象,包含以下顶级字段: | 字段名 | 数据类型 | 描述 | |---|---|---| | `video` | 字符串 | MP4文件名(例如 `"sav_000267.mp4"`) | | `question` | 字符串 | 关于该视频的自然语言因果问题 | | `question_type` | 字符串 | 问题子类别名称(详见下文分类体系) | | `scene_category` | 字符串 | 描述场景的简短自由文本标签 | | `options` | 对象 | 六个答案选项,键为 `"A"` 至 `"F"` | | `answer` | 字符串 | 正确答案的键(取值为 `"A"`–`"F"` 之一) | | `evidence` | 字符串 | JSON编码的时空证据对象数组 | #### 证据对象字段 `evidence`字段为JSON编码的列表,每个元素包含以下字段: | 字段名 | 数据类型 | 描述 | |---|---|---| | `evidence_start_time` | 字符串 | 片段开始时间,格式为 `"mm:ss"` | | `evidence_end_time` | 字符串 | 片段结束时间,格式为 `"mm:ss"` | | `evidence_instance_id` | 字符串 | 追踪的实例标识符(例如 `"person_FnH"`、`"car_lEu"`) | | `evidence_rationale` | 字符串 | 描述该证据因果贡献的自然语言文本 | | `SAV_instance_id` | 字符串 | 指向源SAV追踪文件的引用 | | `bboxes_in_range` | 对象 | 每秒对应的边界框;键为以字符串形式表示的整数秒,值为 `"[x_min, y_min, x_max, y_max]"` 格式的字符串 | #### 答案选项结构 每个问答项均包含六个答案选项,用于探测不同的失效模式: | 选项序号 | 类型 | |---|---| | 第1/6项 | 正确答案 | | 第2/6项 | 近似失误答案(结构一致,仅修改一个关键属性) | | 第3/6项 | 文本型干扰项(不观看视频也可能选对的似是而非选项) | | 第4/6项 | 近似失误文本型干扰项 | | 第5/6项 | 视频型干扰项(基于视频中存在的因果无关实例生成) | | 第6/6项 | 近似失误视频型干扰项 | 答案选项的键 `"A"`–`"F"` 会针对每个问答项随机打乱,因此正确答案并非始终对应固定字母。 --- ## 问题类型分类体系 CaST-Bench将问题分为四大顶级类别,覆盖因果推理的全场景: | 顶级类别 | 子类别 | |---|---| | **1. 因果解释** | 为何类问题(因果原因) | | | 如何类问题(作用机制) | | **2. 反事实推理** | 物理反事实 | | | 社会反事实 | | **3. 预测性预判** | 物理预测 | | | 行为预测 | | **4. 推理性描述** | 身份/角色推理 | | | 人际关系推理 | | | 目标/意图推理(非即时性) | | | 情绪/动机推理 | | | 技能/专业能力推理 | | | 所有权/归属推理 | | | 风险/安全评估 | | | 成功/失败推理 | | | 环境条件推理 | | | 其他上下文推理 | --- ## 数据拆分集 | 拆分集 | 文件 | 描述 | |---|---|---| | 测试集 | `castbench_hf.jsonl` | 用于快速评估的人工核验问答对 | 本次发布包含完整CaST-Bench基准测试中经过严格质量管控的子集。每个问答对均由专业标注人员人工审核,并通过了多阶段自动化过滤流程(详见下文数据集构建部分)。 --- ## 数据集构建 CaST-Bench通过**多阶段人机协作流水线**构建: 1. **视频筛选** — 视频源自[Segment Anything Video (SAV)](https://ai.meta.com/datasets/segment-anything-video/)数据集,该数据集提供密集标注的实例分割追踪结果。由视觉语言模型自动筛选出包含多名参与不同活动的人物、画面稳定且画质优异的视频。 2. **时空实例描述** — 针对每个追踪实例,通过三步流水线生成带时间戳的动作日志:(i) 将实例裁剪为独立片段,(ii) 使用高亮帧生成静态描述,(iii) 针对裁剪片段生成动态描述。随后由7名母语为英语的专业标注人员使用定制化网页标注工具,审阅并重写所有AI生成的描述,最终得到超过10000条高质量实例描述。 3. **问答与因果链生成** — 视觉语言模型“因果思考代理”以实例描述、视频和问题分类体系为输入,按照规定的JSON schema生成包含因果证据链的结构化问答对。 4. **多项选择干扰项生成** — 生成文本型和视频型干扰项,以及所有三类基础选项的近似失误变体,并验证其语义排他性。 5. **多阶段过滤** — (i) 纯文本大语言模型(Large Language Model, LLM)过滤器:移除无需观看视频即可回答的问题。(ii) 视频掩码过滤器:将所有因果链边界框涂黑;丢弃在掩码视频上仍可回答的条目。(iii) 专业标注人员进行最终质量审核并修订问答对与证据。 --- ## 引用 bibtex @inproceedings{zhang2026castbench, title = {CaST-Bench: Benchmarking Causal Chain-Grounded Spatio-Temporal Reasoning for Video Question Answering}, author = {Zhang, Mingfang and Pan, Jingjing and Kumar, Ashutosh and Saini, Rajat and Erdogan, Mustafa and Yang, Hsuan-Kung and Kang, Caixin and Huang, Yifei and Sato, Yoichi and Kong, Quan}, booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)}, year = {2026} } --- ## 许可协议 本基准测试的标注内容采用[CC BY 4.0](https://creativecommons.org/licenses/by/4.0/)协议发布。附带的视频片段源自SAV数据集,需遵守[SAV的原始许可条款](https://ai.meta.com/datasets/segment-anything-video/)。