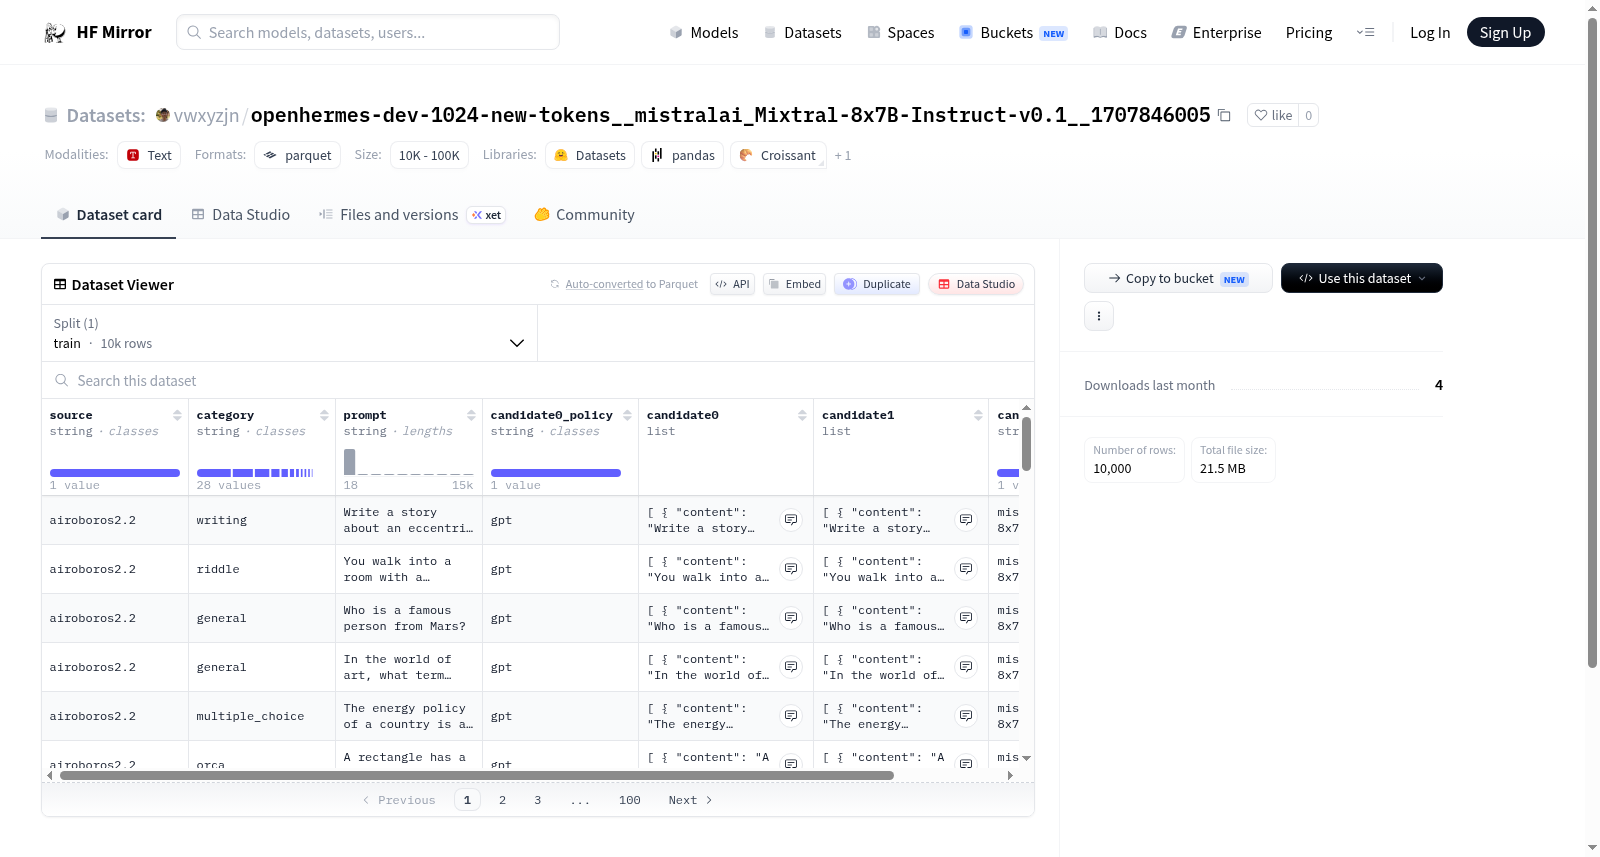
vwxyzjn/openhermes-dev-1024-new-tokens__mistralai_Mixtral-8x7B-Instruct-v0.1__1707846005
收藏资源简介:
--- dataset_info: features: - name: source dtype: string - name: category dtype: string - name: prompt dtype: string - name: candidate0_policy dtype: string - name: candidate0 list: - name: content dtype: string - name: role dtype: string - name: candidate1 list: - name: content dtype: string - name: role dtype: string - name: candidate1_policy dtype: string splits: - name: train num_bytes: 38053815.0 num_examples: 10000 download_size: 21506389 dataset_size: 38053815.0 configs: - config_name: default data_files: - split: train path: data/train-* ---
The dataset includes multiple features such as source, category, prompt, candidate0_policy, candidate0, candidate1_policy, candidate1, etc. Each feature has its specific data type. The dataset is divided into a training set with 10000 samples. The size and download size of the dataset are also clearly stated.
数据集概述
数据集特征
- source: 数据类型为字符串。
- category: 数据类型为字符串。
- prompt: 数据类型为字符串。
- candidate0_policy: 数据类型为字符串。
- candidate0: 包含以下子特征:
- content: 数据类型为字符串。
- role: 数据类型为字符串。
- candidate1: 包含以下子特征:
- content: 数据类型为字符串。
- role: 数据类型为字符串。
- candidate1_policy: 数据类型为字符串。
数据集分割
- train: 包含10000个样本,总字节数为38053815.0。
数据集大小
- 下载大小: 21506389字节。
- 数据集大小: 38053815.0字节。
配置
- default:
- 数据文件:
- split: train
- path: data/train-*
- 数据文件: