
nus-yam/human-eval
收藏官方服务:
资源简介:
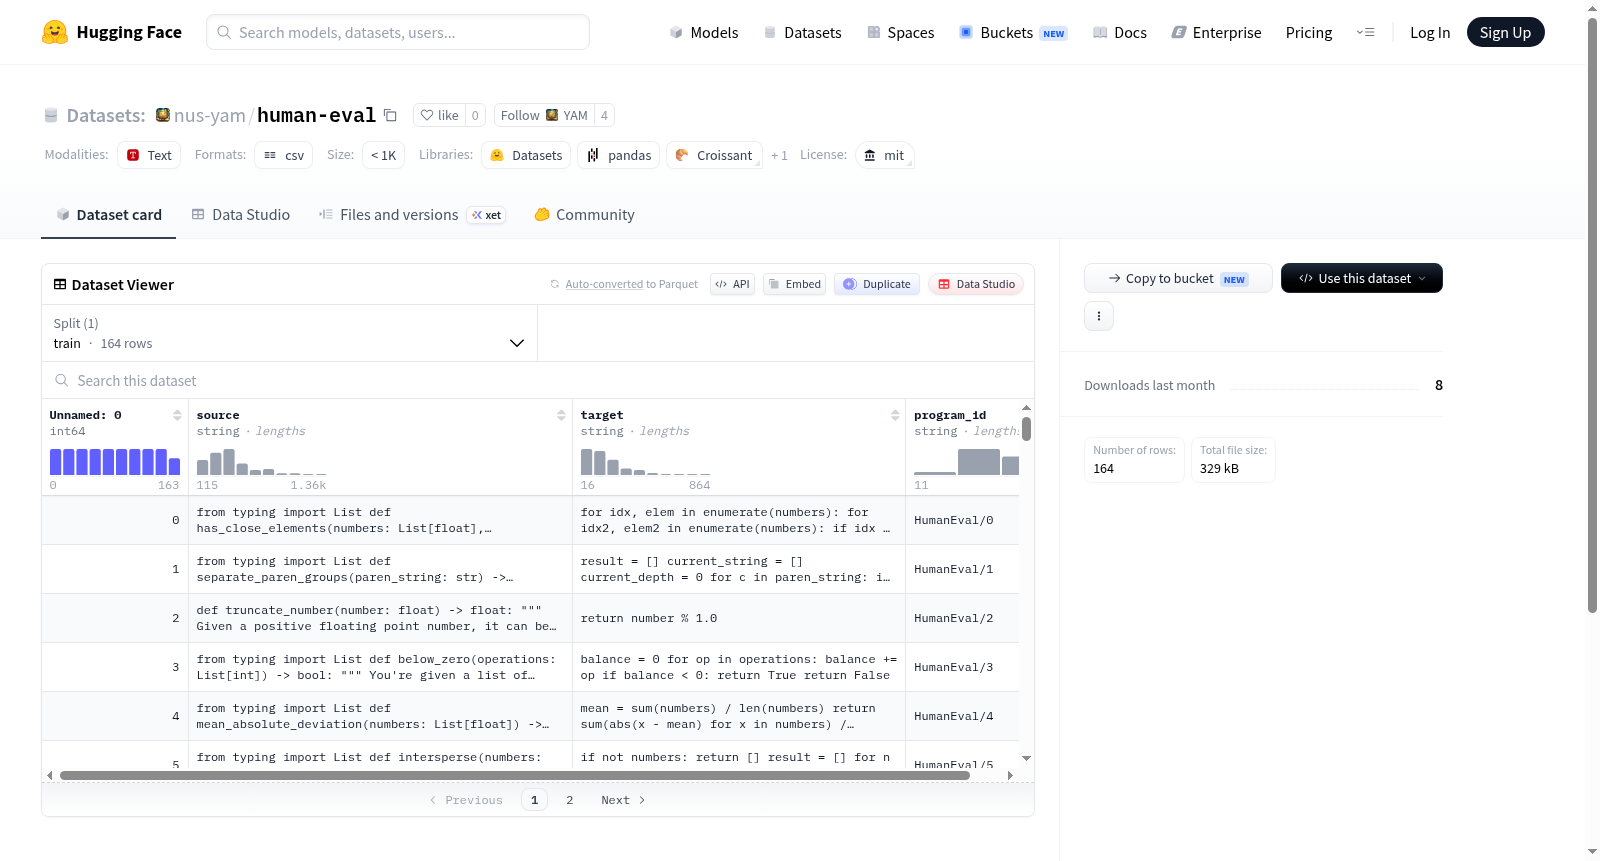
--- --- pretty_name: HumanEval license: mit description: A formatted version of HumanEval. configs: - config_name: default data_files: - split: train path: HumanEval.csv --- --- # Information This is a reformatted version of the [HumanEval dataset](https://github.com/openai/human-eval)
数据集名称:HumanEval 许可证:MIT许可证 数据集描述:本数据集为HumanEval的格式化版本。 配置项: - 配置名称:默认(default) 数据文件: - 拆分集:训练集(train),数据路径:HumanEval.csv # 数据集说明 本数据集为[HumanEval数据集 (HumanEval)](https://github.com/openai/human-eval)的重新格式化版本。
提供机构:
nus-yam原始信息汇总
数据集概述
数据集名称
- 名称: HumanEval
许可证
- 许可证: MIT
描述
- 描述: 一个格式化的HumanEval版本。
配置
- 配置名称: default
- 数据文件:
- 分割: train
- 路径: HumanEval.csv
搜集汇总
数据集介绍
构建方式
HumanEval数据集源自OpenAI发布的原始HumanEval基准测试集,旨在评估代码生成模型的功能正确性。本版本对原始数据进行了格式重构,以CSV文件形式存储,并统一划分为训练集。构建过程中保留了原始数据中所有编程问题、函数签名、测试用例及规范描述,确保数据完整性与可复现性。通过标准化格式转换,该数据集便于直接集成到现代机器学习工作流程中,例如通过HuggingFace Datasets库进行加载与处理。
特点
该数据集的核心特点在于其简洁性与兼容性。所有样本均以统一的结构化表格形式呈现,涵盖多样化的Python编程挑战,每个问题包含明确的函数定义、输入输出示例及隐藏测试用例。数据集的MIT开源许可使其可自由用于学术研究与商业应用。此外,其轻量化设计(单文件CSV)降低了存储与加载开销,而预设的'train'拆分则简化了模型训练与评估的流水线配置。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,指定配置名为'default'即可获取训练数据。加载后的数据以字典形式提供,包含'prompt'(问题描述与函数签名)、'test'(测试代码)等字段。典型用法包括:将'prompt'输入至代码生成模型,利用'test'字段执行单元测试以验证生成代码的正确性。数据集兼容PyTorch、TensorFlow等主流框架,支持批量处理与自定义评估逻辑。
背景与挑战
背景概述
HumanEval数据集由OpenAI于2021年发布,旨在评估代码生成模型在函数级代码合成任务上的能力。该数据集包含164个手写编程问题,每个问题附带单元测试,专门用于衡量模型从自然语言描述生成正确Python函数的表现。作为代码智能领域的标杆性基准,HumanEval推动了诸如Codex、GPT-4等大语言模型在程序合成方向的研究进展,其创建背景源于对传统代码评估方法(如BLEU)无法捕捉功能正确性的反思。该数据集通过严格的测试用例验证,显著提升了代码生成任务的评估可靠性,并成为后续研究(如CodeBERT、StarCoder)的必测基准,对自动编程、低代码开发等应用产生了深远影响。
当前挑战
HumanEval所解决的领域核心挑战在于代码生成模型的功能正确性验证,即模型输出的代码需通过预定义单元测试,而非仅匹配语法模板。这一任务面临双重困难:其一,编程问题描述存在歧义性,同一自然语言表述可能对应多种正确实现,模型需理解隐含逻辑约束;其二,构建过程中需确保测试用例的完备性与无偏性,避免因测试不足导致虚假正确结果。此外,数据集规模较小(仅164例),难以覆盖复杂编程场景,模型在HumanEval上的高分表现可能无法泛化至真实软件开发中的长尾需求。这些挑战促使后续工作探索更大规模、更细粒度的评估基准。
常用场景
经典使用场景
在代码智能与程序合成领域,HumanEval数据集作为一项基准测试,被广泛用于评估大型语言模型在函数级代码生成任务上的能力。该数据集包含164道手写编程问题,每道题均配有函数签名、文档字符串及多个单元测试用例,旨在检验模型能否根据自然语言描述生成正确且可执行的Python代码。研究者通常利用该数据集对GPT、Codex等模型进行零样本或少样本评估,通过计算生成代码通过测试用例的比例(即pass@k指标)来量化模型的功能正确性,从而推动代码生成技术的标准化评测。
衍生相关工作
HumanEval的发布催生了一系列衍生研究,如MBPP(Mostly Basic Programming Problems)和APPS(Automated Programming Progress Standard)等数据集,它们从不同难度和领域拓展了代码生成评估的维度。此外,研究者基于HumanEval提出了多项改进工作,包括引入鲁棒性测试(如HumanEval-X)以评估多语言代码生成能力,以及结合执行反馈的自我修正机制来提升模型性能。这些衍生工作不仅深化了对代码合成模型的理解,还推动了从单一函数生成到复杂程序综合的研究范式演进,使HumanEval成为代码智能领域最具影响力的基准之一。
数据集最近研究
最新研究方向
HumanEval数据集作为代码生成领域的基准测试,近年来在大型语言模型(LLM)的编程能力评估中扮演着核心角色。前沿研究方向聚焦于利用该数据集衡量模型在函数级代码合成、多语言适配及复杂逻辑推理上的表现,特别是与OpenAI的Codex、DeepSeek-Coder等模型的迭代优化紧密关联。随着ChatGPT等事件推动代码智能体热潮,HumanEval被广泛用于验证零样本学习与少样本提示策略的有效性,其标准化格式促进了跨模型对比,对理解LLM的语义理解和结构化输出能力具有深远影响。
以上内容由遇见数据集搜集并总结生成


