
遇见数据集

lightonai/llamaindex-vdr-images

收藏
Hugging Face2026-07-12 更新2026-07-22 收录
官方服务:

资源简介:

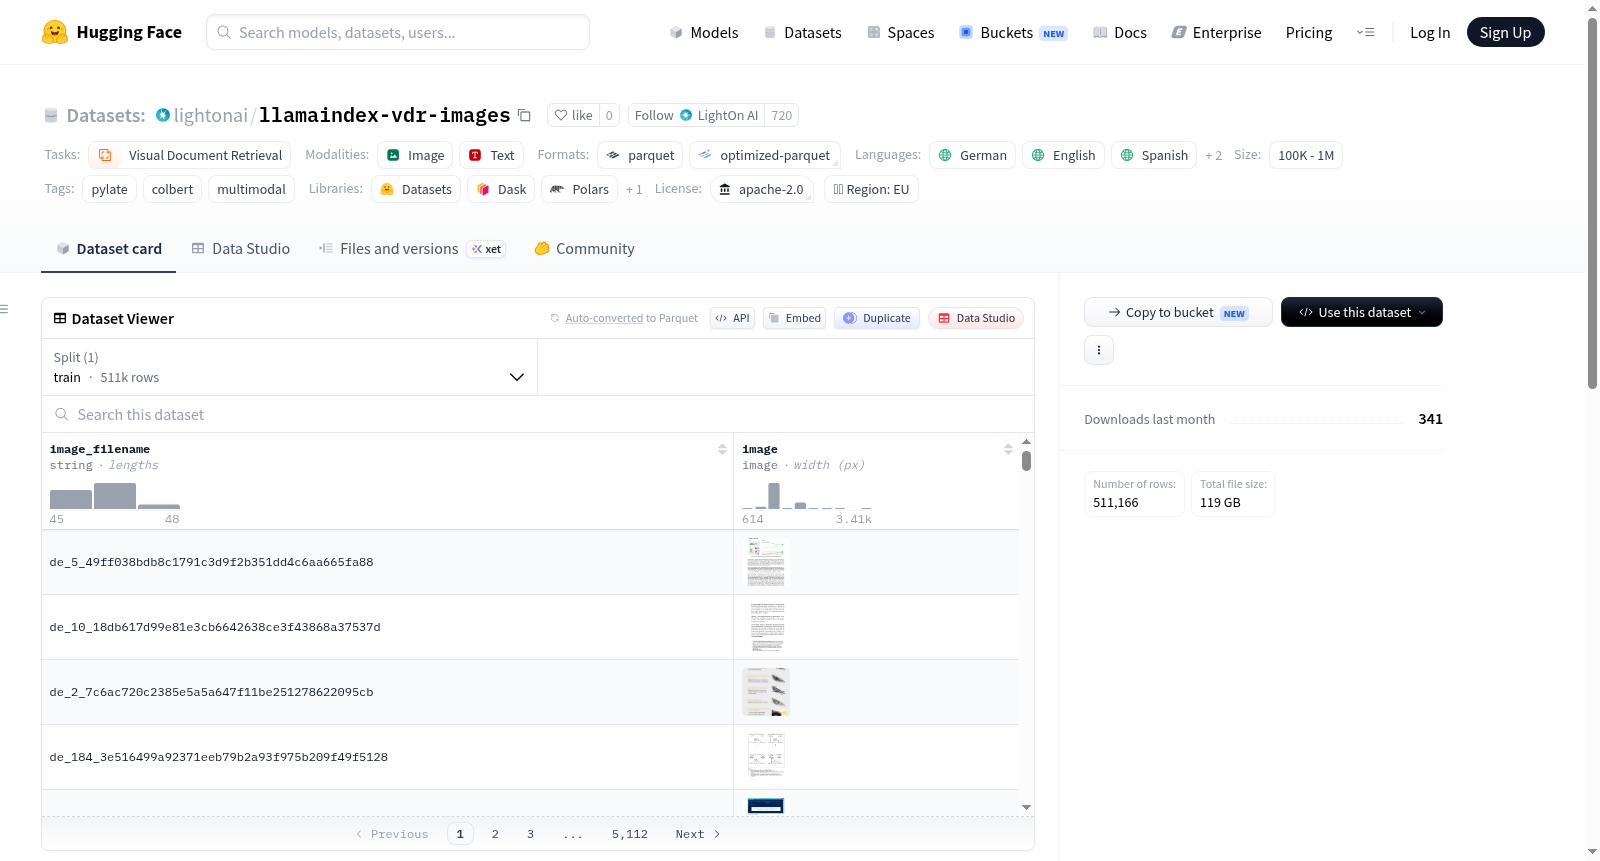
该数据集包含用于[lightonai/llamaindex-vdr-fine-tuning]的文档页面图像,是[llamaindex/vdr-multilingual-train]的重新格式化衍生版本,专为多语言检索微调设计。数据集支持多语言(德语、英语、西班牙语、法语、意大利语),包含train分割,共有511,166个示例,总大小约118.68 GB。特征包括image_filename(稳定键)和image(文档页面图像),适用于视觉文档检索任务。

This dataset contains document page images intended for [lightonai/llamaindex-vdr-fine-tuning], and it is a reformatted derivative version of [llamaindex/vdr-multilingual-train], specifically designed for multilingual retrieval fine-tuning. The dataset supports multiple languages including German, English, Spanish, French and Italian, includes the train split, and has a total of 511,166 examples with an approximate total size of 118.68 GB. Its features include image_filename (a stable key) and image (document page images), which are suitable for visual document retrieval tasks.
提供机构:
lightonai
搜集汇总
数据集介绍
lightonai/llamaindex-vdr-images 数据集图片
构建方式
在视觉文档检索领域,多模态数据集的构建是推动模型性能提升的关键环节。LlamaIndex VDR Images 数据集作为 lightonai/llamaindex-vdr-fine-tuning 的配套图像资源,通过对 llamaindex/vdr-multilingual-train 原始数据集进行重新格式化与衍生处理而诞生。该数据集专门服务于多语言检索微调任务,其构建过程保留了原始数据中图像与文本的对应关系,以 image_filename 作为稳定键值,确保与配套微调数据集中的文档配置实现无缝关联。训练集共包含 511,166 个样本,每个样本由图像文件名和文档页面图像构成,图像数据以未解码的原始格式存储,便于高效加载与处理。
特点
该数据集的核心特色在于其多语言与多模态的深度融合特性。数据覆盖德语、英语、西班牙语、法语和意大利语五种语言,为跨语言视觉文档检索研究提供了扎实的数据基础。每个样本以图像为中心,拒绝解码的存储策略赋予用户极大的预处理灵活性,可依据具体模型需求自定义图像加载与变换流程。此外,数据规模宏大,下载大小约 118.7 GB,丰富的样本量有助于训练鲁棒的检索模型。Apache 2.0 许可协议的开源属性进一步降低了学术研究与工业应用的门槛。
使用方法
使用该数据集时,推荐与配套的微调数据集 lightonai/llamaindex-vdr-fine-tuning 协同操作。通过 Hugging Face Datasets 库的 load_dataset 函数即可加载训练拆分,获取图像文件名与图像对象。随后,利用 image_filename 字段作为关联键,将图像数据与微调数据集中的文档信息进行匹配,从而构建完整的图文对用于训练。用户可根据自身任务需要,对图像进行自定义解码与预处理,例如调整尺寸、归一化或增强,以适应不同的视觉编码器架构,最终实现多语言视觉文档检索模型的高效微调。
背景与挑战
背景概述
多模态文档检索技术作为连接视觉信息与文本理解的桥梁,在信息检索领域日益受到重视。LlamaIndex VDR Images数据集由LightOn AI团队于近期创建,旨在为视觉文档检索任务提供高质量的多语言文档页面图像资源。该数据集源于llamaindex/vdr-multilingual-train的改良版本,包含约51万张涵盖德语、英语、西班牙语、法语和意大利语五种语言的文档页面图像,与配套的微调数据集lightonai/llamaindex-vdr-fine-tuning形成互补关系。其核心研究问题在于如何提升跨语言、多模态场景下文档检索的精度与效率。该数据集通过Apache-2.0许可证开放,为多语言视觉检索模型的研究提供了标准化训练基础,有力推动了文档级多模态理解技术的发展。
当前挑战
数据集所解决的领域问题在于视觉文档检索中图像与文本模态对齐的挑战,传统文本检索方法难以处理包含图表、排版等视觉信息的PDF文档,而该数据集通过提供成对的页面图像与结构化检索标签,为模型学习视觉-语义关联提供了训练支撑。构建过程中的挑战主要体现在三个方面:其一,多语言文档图像的收集与清洗需确保不同语言版本的图像质量均衡;其二,原始数据集的格式转换需保留图像文件名与检索样本的稳定映射关系,避免数据关联断裂;其三,近50万张图像的数据规模对存储与加载效率提出高要求,需采用高效的索引方案以支持大规模训练场景下的并行访问与批次加载。
常用场景
经典使用场景
在视觉文档检索领域,llamaindex-vdr-images数据集以其多语言文档页面图像与文本的紧密耦合特性,成为训练多模态检索系统的基石。该数据集包含超过51万张来自多语种文档的页面图像,涵盖德语、英语、西班牙语、法语和意大利语等语言,通过与配套的微调数据集配对,支持模型学习如何从图像中高效提取并匹配文本语义信息,从而在跨语言、跨模态的检索任务中实现卓越表现。
实际应用
在实际应用中,该数据集支撑的检索模型可被部署于企业知识管理系统、数字图书馆和跨语言法律文书检索平台。例如,用户可通过拍摄或扫描的文档图像,快速定位到数据库中对应的多语种版本或相关章节,极大提升了跨国企业、科研机构对异构文档的管理效率。此外,在电商、教育等场景中,模型可根据产品说明书或教材页面图像,实时匹配最相关的说明文本或习题解答。
衍生相关工作
基于llamaindex-vdr-images数据集,研究者已衍生出多项经典工作,包括面向多模态检索的PlatE框架、ColBERT风格的后期交互蒸馏模型以及轻量级视觉文档索引技术。这些工作不仅验证了图像与文本联合建模的有效性,还推动了pylate、colbert等工具库的优化,为多模态检索系统在工业级部署中的高效推理提供了重要参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

