ChineseIsEasy
收藏资源简介:
ChineseIsEasy多模态词汇数据集是一个大规模的中法双语语言资源,专为机器学习、自然语言处理研究和高级Anki卡片生成设计。数据集包含28,354个独特的中文词条(单词和短语),按频率排序。核心数据包括简体/繁体汉字、拼音(带声调)和法语释义(经过LLM优化)。统计数据来自SUBTLEX-CH语料库,包括Zipf频率、词频计数和对数转换指标。每个词条都配有例句及对应的法语翻译和拼音。多模态部分包括高质量的自然语音(单词和句子)和语义插图(用于触发主动回忆)。数据集结构清晰,包含元数据、训练数据、音频文件和图像文件,每种媒体类型都有特定的格式和用途。音频采用分层策略,优先使用高质量人类录音,并辅以AI生成的多样化声音。图像设计为“语义锚点”,原始图像保存为PNG格式以保留细节,优化后的图像为JPG格式,适合闪卡应用。数据集采用CC BY 4.0许可,词汇基础来自CC-CEDICT,频率统计基于SUBTLEX-CH。
The ChineseIsEasy Multimodal Vocabulary Dataset is a large-scale Chinese-French bilingual language resource designed for machine learning, natural language processing research, and advanced Anki flashcard generation. The dataset contains 28,354 unique Chinese lexical entries (words and phrases), sorted by frequency. Core data includes simplified/traditional Chinese characters, pinyin (with tone marks), and French definitions optimized by LLM. Statistical data is sourced from the SUBTLEX-CH corpus, including Zipf frequency, word frequency counts, and log-transformed metrics. Each lexical entry is accompanied by example sentences along with their corresponding French translations and pinyin. The multimodal components include high-quality natural speech (for words and sentences) and semantic illustrations (designed to trigger active recall). The dataset has a clear structure, including metadata, training data, audio files, and image files, with each media type having specific formats and use cases. The audio adopts a hierarchical strategy, prioritizing high-quality human recordings and supplementing with AI-generated diverse voices. Images are designed as "semantic anchors": original images are saved in PNG format to preserve details, while optimized images are in JPG format suitable for flashcard applications. The dataset is licensed under CC BY 4.0, with its vocabulary base sourced from CC-CEDICT and frequency statistics based on SUBTLEX-CH.
ChineseIsEasy 多模态词汇数据集概述
数据集基本信息
- 名称: ChineseIsEasy Multimodal Lexical Dataset
- 语言: 中文 (zh)、法语 (fr)
- 许可证: CC BY 4.0
- 数据规模: 10n<100n
- 任务类别: 文本到语音、文本到图像、翻译
- 数据集大小: 23,307,116,600 字节
- 下载大小: 8,009,316,175 字节
- 条目数量: 28,354 个唯一中文词条
- 数据格式: Parquet
- 数据分割: 训练集 (train)
核心内容与特征
- 核心数据: 包含简体/繁体汉字、拼音(带声调)及法语释义。
- 频率统计: 提供基于 SUBTLEX-CH 语料库的 Zipf 频率、词频计数及对数转换指标。
- 上下文信息: 每个词条均配有例句及对应的法语翻译和拼音。
- 多模态数据:
- 自然音频: 为单词和句子提供高保真语音。
- 视觉图像: 生成用于触发主动回忆的语义插图。
数据结构字段
数据集包含以下主要字段:
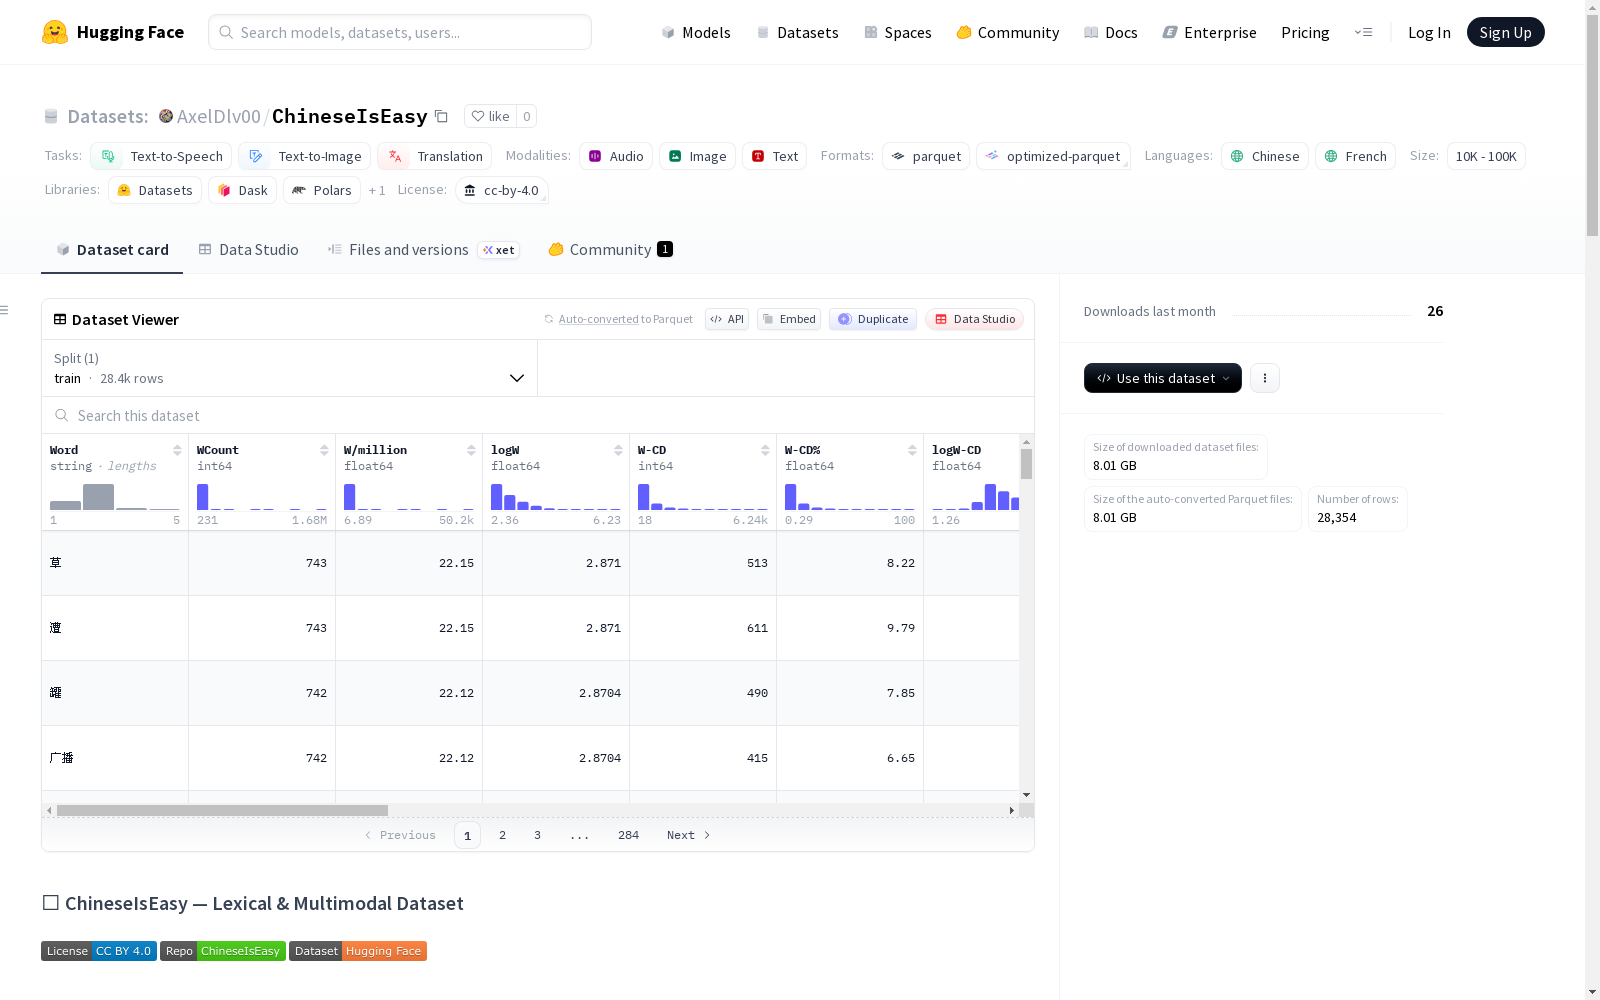
Word: 单词 (字符串)WCount: 词频计数 (整数)W/million: 每百万词频 (浮点数)logW: 词频对数 (浮点数)W-CD: 词频-字幕分布 (整数)W-CD%: 词频-字幕分布百分比 (浮点数)logW-CD: 词频-字幕分布对数 (浮点数)infos: 结构体,包含拼音列表、词义列表、简体、繁体字段。Traditionnel: 繁体字 (字符串)Pinyin: 拼音 (字符串)Signification: 释义 (字符串)Catégorie: 词类 (字符串)Exemples: 例句 (字符串)Explication: 解释 (字符串)hf_img_orig: 原始图像hf_img_optim: 优化图像hf_audio_word: 单词音频,采样率 16000 Hzhf_examples_json: 示例 JSON (字符串)
文件与目录结构
数据集遵循清晰、解耦的架构。主要文件及目录如下:
metadata.parquet train.parquet audio/ words/ examples/ original_wav/ optimized_mp3/ images/ original_png/ optimized_jpg/
每个媒体文件夹包含一个 mapping.csv 文件,用于将短 SHA-1 哈希值映射回原始文本。
生成流程
数据通过混合流程生成:
- 语言丰富化: 通过 GPT-4o-mini 进行批处理,生成教学类别、自然例句和深度语法解释。
- 视觉语义生成:
- GPT-4o-mini 作为“提示工程师”描述单词含义。
- Juggernaut XL v9 (SDXL) 在本地生成图像。
- 释义精炼: 使用专门的 LLM 提示,将原始英语词典 (CC-CEDICT) 内容翻译并重新格式化为清晰的法语教学内容。
音频策略
采用分层音频方法以确保学习效率:
- 单词: 优先使用高质量男性人声录音 (CC-CEDICT-TTS),按拼音命名以处理同形异义词。备用方案为通过压缩的 gTTS (Google Cloud) 生成,比特率为 24kbps。
- 句子: 使用 VoxCPM-0.5B (OpenBMB) 生成。为避免机器人般的单调,使用来自
ST-CMDS语料库的 16 种不同的高质量参考声音进行多样化克隆。 - 格式: 同时提供
WAV(用于存档/机器学习) 和MP3(用于 Anki/移动设备) 格式。
图像架构
每张图像均设计为“语义锚点”。
- 原始图像: 存储为
PNG(768x768),以保留 Juggernaut XL 模型的生成细节。 - 优化图像: 存储为
JPG(256x256),使用 Lanczos 重采样。这些图像已为抽认卡应用做好准备,在视觉清晰度和同步速度之间取得平衡。
使用方式
通过 Hugging Face Datasets 加载
python from datasets import load_dataset ds = load_dataset("AxelDlv00/ChineseIsEasy") entry = ds[train][0] print(f"Hanzi: {entry[Word]} | Freq: {entry[WCount]}") print(f"Audio Path: {entry[hf_audio_word]}")
直接下载
可通过克隆仓库访问原始文件: bash git lfs install git clone https://huggingface.co/datasets/AxelDlv00/ChineseIsEasy
许可证与来源
- 数据集内容: 基于 CC BY 4.0 许可发布。
- 词汇基础: 衍生自 CC-CEDICT (知识共享 署名-相同方式共享 3.0 许可)。
- 频率统计: 基于 SUBTLEX-CH。
作者
Axel Delaval (陈安思)