
ardauzunoglu/dpo_smollm2_17b_instruct_0528_ckpt60_c4_lowq_200m2b_subsample20m_grpo_prompt
收藏数据链接:
官方服务:
资源简介:
该数据集是一个包含训练分割的文本数据集,总大小约408.67MB,包含100,018个示例。特征包括行索引、样本索引、文本内容、完成原因、停止原因、文档标识和提示令牌计数,适用于自然语言处理任务,如文本生成或分析。
This text dataset includes a training split, has a total size of approximately 408.67 MB, and comprises 100,018 examples. Its features include row index, sample index, text content, completion reason, stop reason, document identifier, and prompt token count. It is suitable for natural language processing tasks such as text generation and analysis.
提供机构:
ardauzunoglu搜集汇总
数据集介绍
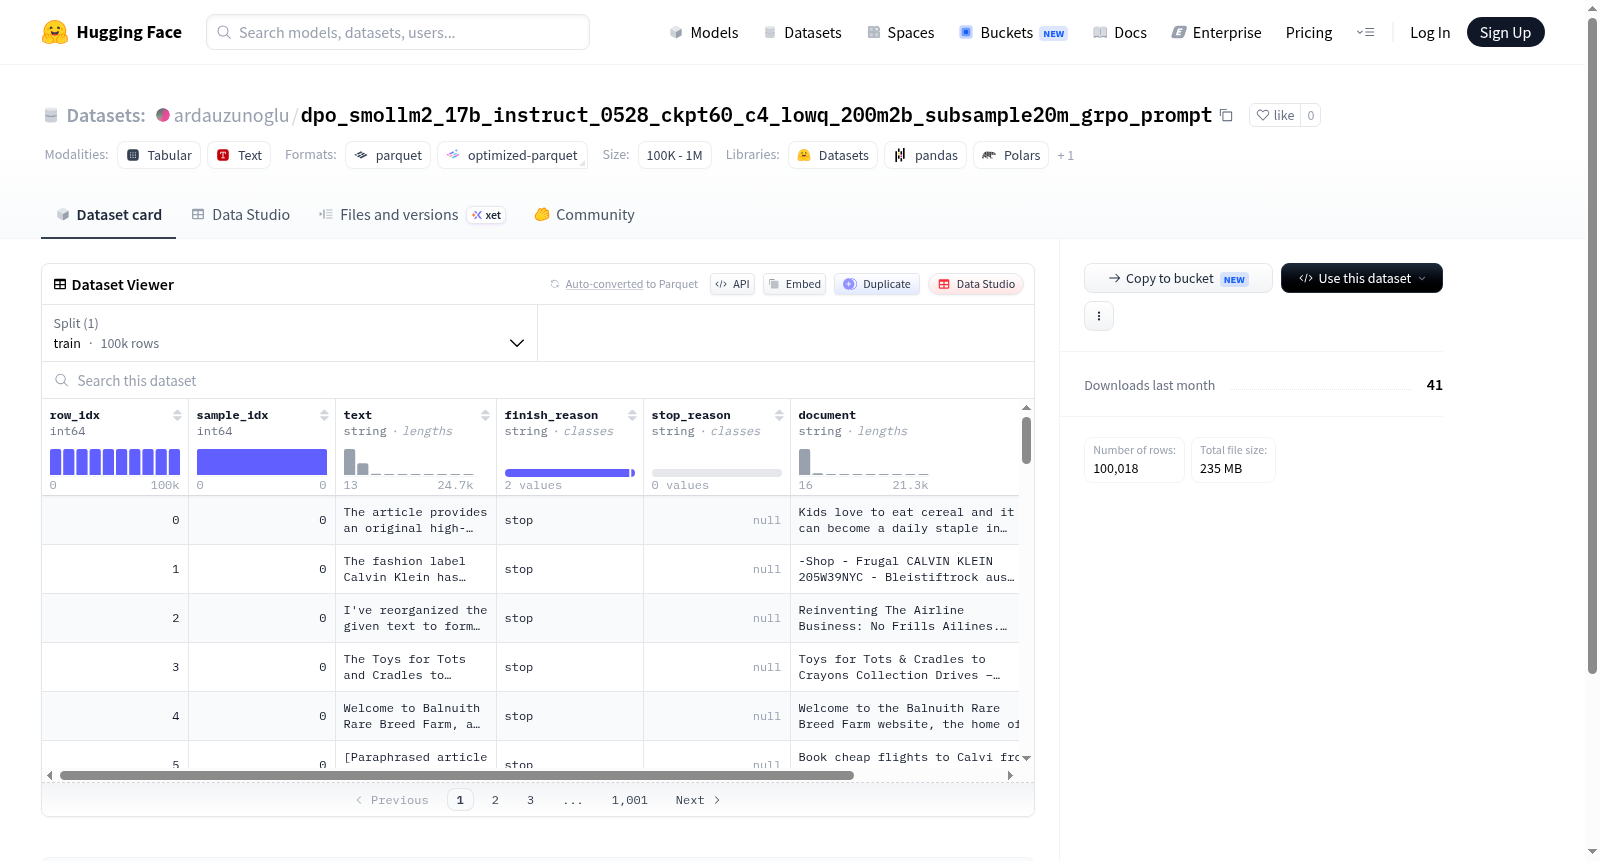
构建方式
该数据集源于对SmolLM2-1.7B-Instruct模型在特定训练阶段(checkpoint 60)的生成结果进行深度优化与筛选。基于C4数据集的高质量子集,采用低量化技术(LowQ)对200M至2B规模的样本进行初步过滤,随后通过子采样策略提取约20M条数据,并运用GRPO(Group Relative Policy Optimization)方法生成偏好对,最终构建出包含约10万条训练样本的dpo数据集。每条数据记录了原始文本、生成结果、终止原因及提示词长度等信息,为模型的对齐训练提供了丰富的对比信号。
特点
本数据集的核心特色在于其多层次的精细化处理流程:首先通过低量化技术从大规模语料中提取高价值文本片段,再结合GRPO算法生成的偏好对,有效融合了质量筛选与偏好学习两种先进策略。数据集包含完整字段,如文本内容、终止原因及文档来源,使得训练数据兼具多样性与可控性。此外,约10万条样本规模在保证计算效率的同时,能够显著提升小型语言模型在指令跟随与生成质量方面的表现。
使用方法
该数据集专为DPO(Direct Preference Optimization)训练范式设计,可直接用于偏好学习场景。用户可通过HuggingFace的datasets库加载此数据集,并利用其中的'text'字段作为输入、'finish_reason'和'stop_reason'作为生成质量指标。训练时建议将数据划分为训练集与验证集,并结合C4等语料进行联合微调。由于数据集已包含预处理的偏好信号,开发者无需额外标注,即可快速启动模型的对齐优化实验。
背景与挑战
背景概述
该数据集创建于2024年,由HuggingFace团队及其合作者研发,旨在通过直接偏好优化(DPO)技术提升小规模语言模型(如SmolLM2-1.7B-Instruct)的指令遵循能力。核心研究问题聚焦于如何利用高质量、低资源的合成数据(源自C4语料库的200M tokens子集)进行偏好学习,以在计算约束下实现模型对齐。该数据集包含约10万条训练样本,通过GRPO(群体相对策略优化)生成的提示与响应对,为探索小模型在低成本场景下的对齐策略提供了重要基准,对资源受限环境下的语言模型微调研究具有显著推动力。
当前挑战
数据集所解决的领域挑战在于:传统的偏好对齐方法(如RLHF)对计算资源和人类反馈依赖度高,难以适用于小规模模型和低资源场景。构建过程中面临的核心挑战包括:如何在仅采样200M tokens的C4子集中生成多样化且语义合理的偏好提示,避免数据偏差;以及如何确保DPO训练中的响应质量与奖励信号的一致性,防止模型陷入局部最优或产生衰减。此外,从100K样本中高效筛选高价值对以提升训练效率,也是数据流水线设计中的关键难点。
常用场景
经典使用场景
在语言模型对齐研究领域,dpo_smollm2_17b_instruct_0528_ckpt60_c4_lowq_200m2b_subsample20m_grpo_prompt数据集专为强化学习与人类偏好对齐场景而设计。该数据集蕴含了从大规模预训练语料中精心抽取的约10万条训练样本,每条记录均包含原始文本、模型生成响应及终止原因等关键信息,为直接偏好优化(DPO)及组相对策略优化(GRPO)等算法提供了天然的微调燃料。研究者可借此探索如何通过少量高质量偏好数据引导17B参数尺度模型的行为,在保持生成多样性同时提升指令遵循能力,尤其适用于追求计算效率与对齐效果平衡的低资源场景。
解决学术问题
该数据集核心致力于解决大型语言模型在对齐人类意图时面临的数据稀缺与效率瓶颈问题。传统RLHF方法依赖大规模人工标注,成本高昂且难以复现,而此数据集通过对SmoLLM2-17B模型中间检查点(ckpt60)的输出进行结构化采集,并结合C4语料库的低困惑度子采样策略,构建出兼具多样性及偏好信号的数据集合。它使得学术界能够在有限预算下复现基于DPO的对齐实验,探索模型在指令跟随、安全约束和事实一致性等维度的优化边界,为理解偏好学习中的样本效率与泛化机制提供了标准化测试平台。
衍生相关工作
此数据集的诞生直接关联并促进了偏好对齐领域的多项经典工作。其命名中明确的DPO与GRPO指向了如《Direct Preference Optimization》及《Group Relative Policy Optimization》等开创性方法,这些方法利用静态偏好数据集替代传统强化学习的在线采样环节。此外,数据集对C4语料的低困惑度子采样策略借鉴了《Scaling Data-Constrained Language Models》中的思想,而针对模型中间检查点的数据构建方式则与《From Reinforcement Learning to Fine-Tuning》等关于训练动态分析的研究一脉相承。这些衍生的基准工作共同推动了语言模型从性能驱动走向安全与价值对齐的范式转型。
以上内容由遇见数据集搜集并总结生成


