autophagycode_D_metrics_he_Qwen3-14B_lr0.0001_scm_g5
收藏资源简介:
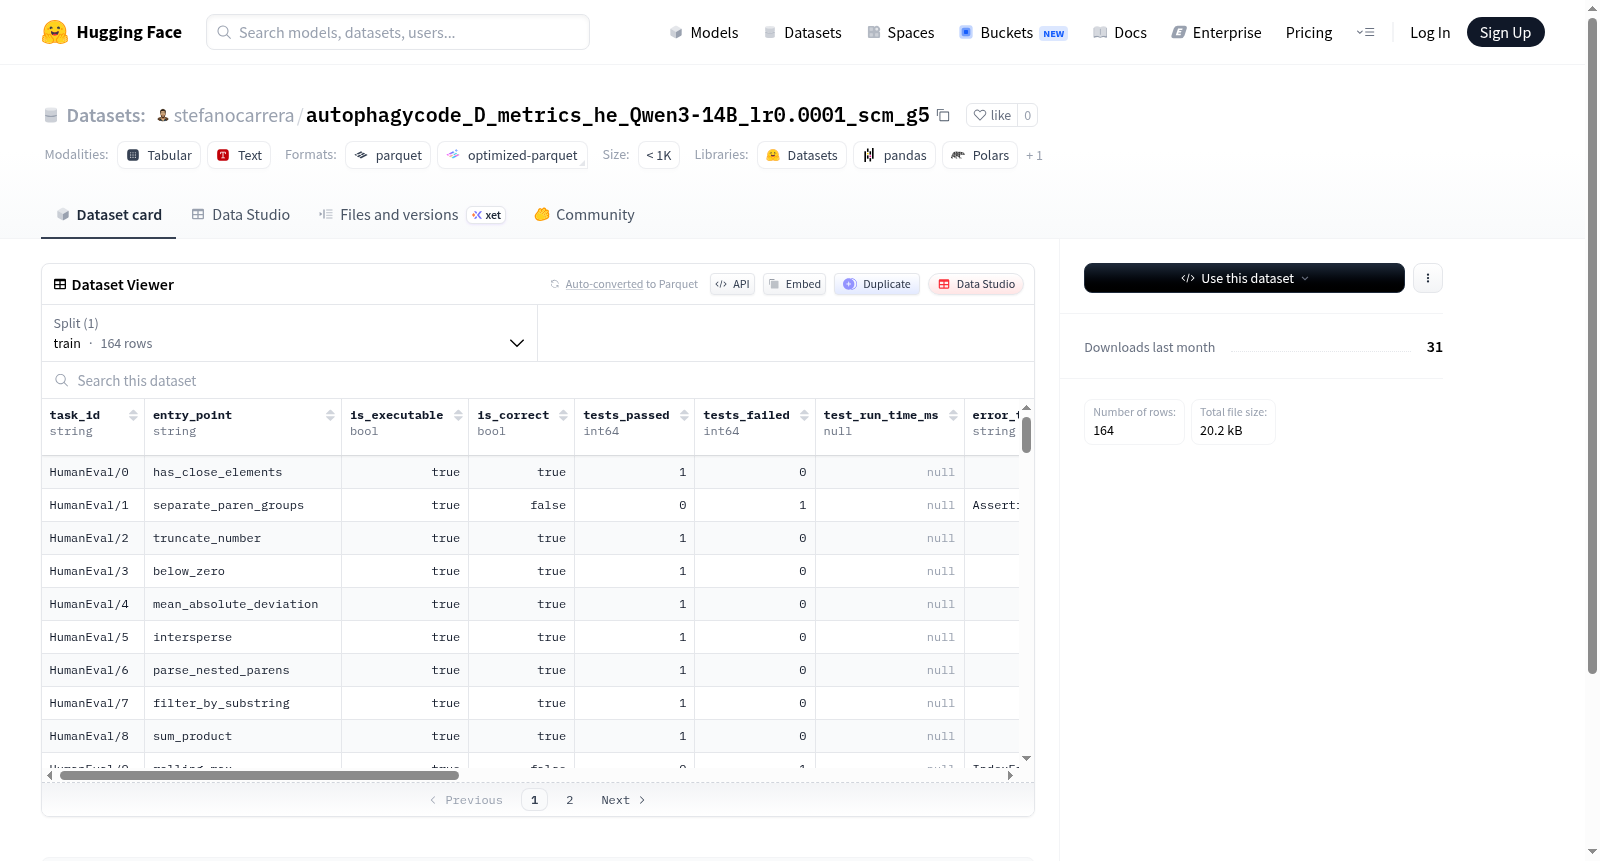
该数据集包含代码执行结果与软件工程指标数据,共164个训练样本。主要字段包括:任务ID(task_id)、入口函数(entry_point)、可执行状态(is_executable)、正确性(is_correct)、通过/失败的测试案例数(tests_passed/tests_failed)、错误类型(error_type)。同时包含Halstead复杂度指标(词汇量、长度、体积、难度、工作量)、可维护性指数(maintainability_index)、定义函数数量(n_func_defined)等软件度量数据。数据以布尔值、字符串、整型和浮点型数值形式存储,适用于代码质量分析、缺陷预测或程序修复等软件工程研究任务。
This dataset contains code execution results and software engineering metric data, with a total of 164 training samples. Its core fields include: task ID (task_id), entry function (entry_point), executability status (is_executable), correctness (is_correct), number of passed/failed test cases (tests_passed/tests_failed), and error type (error_type). It also encompasses software measurement metrics such as Halstead complexity metrics (vocabulary, length, volume, difficulty, effort), maintainability index (maintainability_index), and number of defined functions (n_func_defined). The data is stored in formats including boolean values, strings, integers, and floating-point numerical values, and is applicable to software engineering research tasks such as code quality analysis, defect prediction, and program repair.
数据集概述
基本信息
- 数据集名称: autophagycode_D_metrics_he_Qwen3-14B_lr0.0001_scm_g5
- 存储地址: https://huggingface.co/datasets/stefanocarrera/autophagycode_D_metrics_he_Qwen3-14B_lr0.0001_scm_g5
- 数据量: 16,874 字节(下载大小),18,611 字节(数据集大小)
- 样本数量: 164 个示例
- 数据分割: 仅包含一个“train”分割
数据结构
数据集包含以下字段:
- task_id: 字符串类型,任务标识符。
- entry_point: 字符串类型,入口点。
- is_executable: 布尔类型,是否可执行。
- is_correct: 布尔类型,是否正确。
- tests_passed: 整型64位,通过的测试数量。
- tests_failed: 整型64位,失败的测试数量。
- test_run_time_ms: 空值类型,测试运行时间(毫秒)。
- error_type: 字符串类型,错误类型。
- halstead_vocabulary: 整型64位,Halstead词汇量。
- halstead_length: 整型64位,Halstead长度。
- halstead_volume: 浮点64位,Halstead体积。
- halstead_difficulty: 浮点64位,Halstead难度。
- halstead_effort: 浮点64位,Halstead工作量。
- maintainability_index: 浮点64位,可维护性指数。
- n_func_defined: 整型64位,定义的函数数量。
- entry_point_repeated: 布尔类型,入口点是否重复。
配置与访问
- 默认配置名称: default
- 数据文件路径:
data/train-*(对应“train”分割)