uk_UA-ASMR
收藏资源简介:
乌克兰ASMR TTS数据集是一个专为训练单说话人ASMR风格语音模型设计的文本转语音数据集,适用于乌克兰语。数据集包含7,318个音频片段,格式为16位WAV,采样率为22050 Hz,单声道。数据集结构包括元数据文件(metadata.csv)、音频文件目录(audio/)以及用于训练的检查点文件(checkpoints/)。该数据集使用CC0许可证,允许自由使用。数据集适用于基于Piper框架的乌克兰语文本转语音模型训练,支持字符级音素映射,无需依赖espeak-ng音素化。数据集还提供了详细的训练和导出指南,包括安装依赖、训练命令和模型导出步骤。
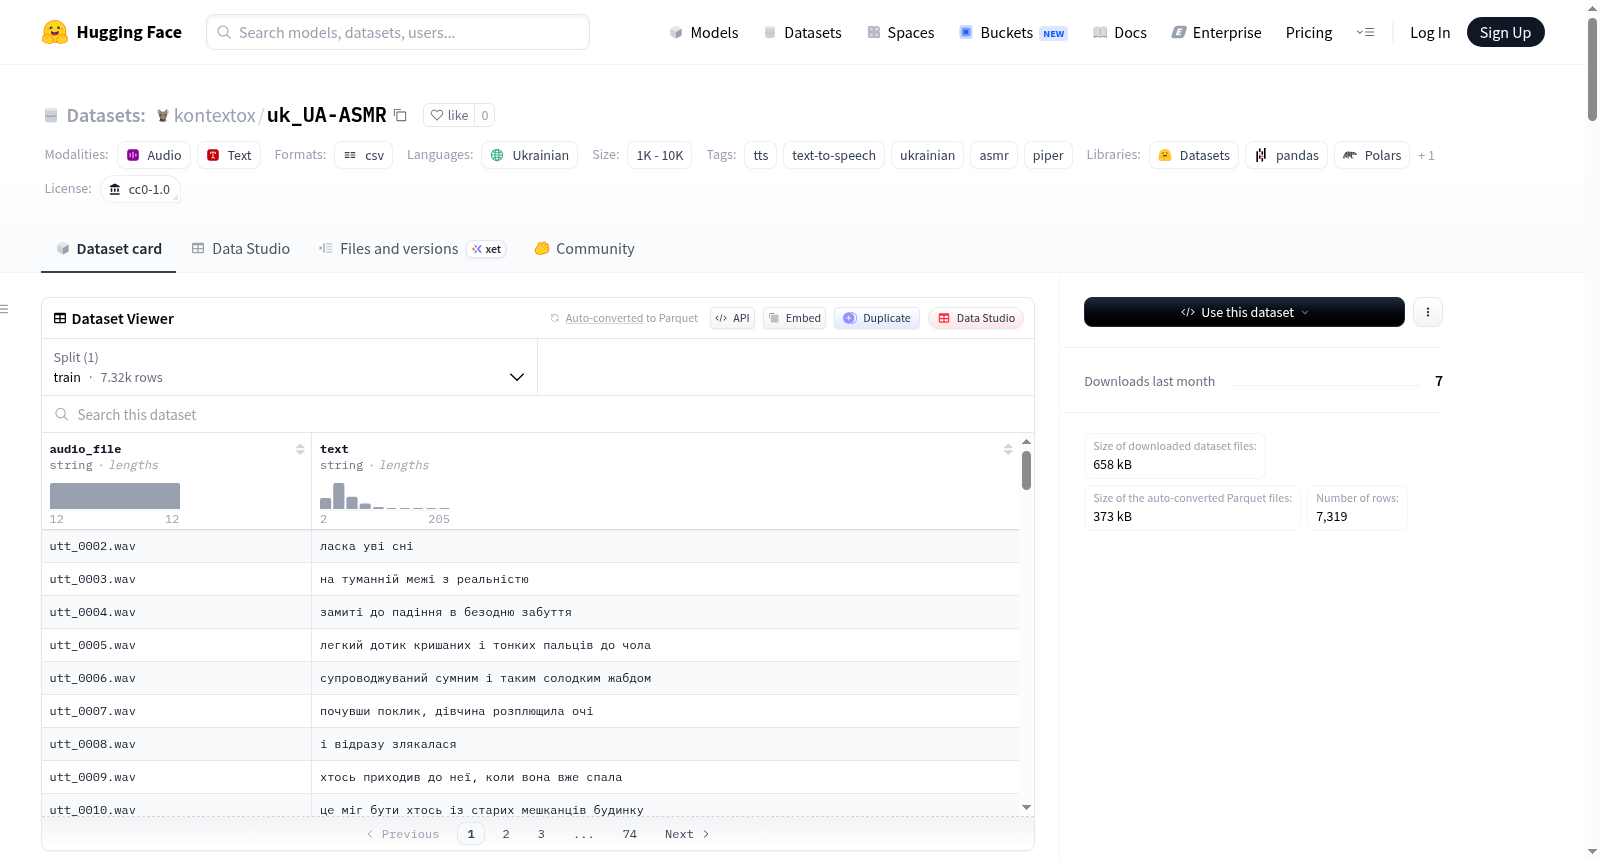
The Ukrainian ASMR TTS Dataset is a text-to-speech (TTS) dataset purpose-built for training single-speaker ASMR-style speech models for the Ukrainian language. It contains 7,318 audio clips in 16-bit WAV format, with a sample rate of 22050 Hz and mono audio. The dataset’s structure comprises a metadata file (metadata.csv), an audio directory (audio/), and a checkpoints directory (checkpoints/) intended for model training. Released under the CC0 license, the dataset allows for unrestricted free usage. This dataset is compatible with training Ukrainian TTS models using the Piper framework, supporting character-level phoneme mapping without requiring espeak-ng for phonemization. Additionally, the dataset offers detailed training and export guidelines covering dependency installation, training commands, and model export steps.
Ukrainian ASMR TTS 数据集概述
基本信息
- 数据集名称: Ukrainian ASMR TTS Dataset
- 语言: 乌克兰语 (uk_UA)
- 许可协议: CC0-1.0
- 标签: tts, text-to-speech, ukrainian, asmr, piper
- 配置名称: default
数据集详情
| 属性 | 值 |
|---|---|
| 语言 | 乌克兰语 (uk_UA) |
| 说话人数量 | 1 |
| 数据段数量 | 7,318 |
| 音频格式 | 16-bit WAV, 22050 Hz, Mono |
| 许可证 | CC0 |
数据集结构
数据集包含以下文件与目录:
uk_UA-ASMR/ ├── README.md ├── metadata.csv # 元数据文件 ├── phonemes.json # 自动提取的乌克兰语音素映射文件 ├── audio/ # 音频文件目录 (22050 Hz, mono, 16-bit) │ ├── utt_0001.wav │ ├── utt_0002.wav │ └── ... └── checkpoints/ # 检查点目录 ├── config.json └── epoch=2090-step=1166778.ckpt
元数据文件 (metadata.csv) 格式为:音频文件|文本。
音频规格
- 采样率: 22050 Hz
- 声道: 单声道 (Mono)
- 位深度: 16-bit
- 格式: WAV
音素类型
该数据集使用 phoneme_type: "text",即直接使用原始乌克兰语字符,而不通过 espeak-ng 进行音素化。模型使用基于乌克兰语西里尔字母的字符音素映射。
有效字符包括:
а б в г ґ д е є ж з и і ї й к л м н о п р с т у ф х ц ч ш щ ь ю я
以及标点符号:space ! , - . : ; ? _ ^ $ — 和变音符号。
用途
该数据集用于训练使用 Piper 框架的单说话人 ASMR 风格语音文本转语音模型。
引用
若使用本数据集,请引用: bibtex @misc{uk_ua_asmr, title={Ukrainian ASMR TTS Dataset}, author={Kontextox}, year={2026}, url={https://huggingface.co/datasets/kontextox/uk_UA-ASMR} }
致谢
- 基础乌克兰语模型:OHF-Voice/voice-datasets
- 训练框架:Piper