
遇见数据集

QCRI/Fanar-Sadiq-Bench

收藏
Hugging Face2026-05-17 更新2026-06-14 收录
官方服务:

资源简介:

Fanar-Sadiq分类器数据集是一个双语阿拉伯语/英语的查询分类数据集,随论文Fanar-Sadiq: A Multi-Agent Architecture for Grounded Islamic QA发布。该数据集支持Fanar-Sadiq多代理伊斯兰问答系统的路由组件,该系统将用户查询路由到专门模块,如基于检索的伊斯兰问答、古兰经检索、祈祷词查找、祈祷时间计算、伊斯兰日历工具、天课计算器和继承计算器。数据集包含两个分类器子集:提示分类器(用于决定用户查询是否与伊斯兰相关)和意图分类器(用于将伊斯兰查询路由到适当的专门组件)。数据包括阿拉伯语和英语查询,涵盖自然表达、代码切换、简短、冗长、事实性、法学性、对话式和工具导向的用户请求。

The Fanar-Sadiq Classifier Dataset is a bilingual Arabic/English query classification dataset accompanying the paper titled Fanar-Sadiq: A Multi-Agent Architecture for Grounded Islamic QA. This dataset supports the routing component of the Fanar-Sadiq multi-agent Islamic question answering (QA) system, which directs user queries to specialized modules including retrieval-based Islamic QA, Quran retrieval, supplication lookup, prayer time calculation, Islamic calendar tool, Zakat calculator, and inheritance calculator. The dataset comprises two classifier subsets: the prompt classifier (for determining whether a user query is Islamic-related) and the intent classifier (for routing Islamic queries to appropriate specialized components). The dataset includes Arabic and English queries covering natural expressions, code-switching, short, lengthy, factual, jurisprudential, conversational, and tool-oriented user requests.
提供机构:
QCRI
搜集汇总
数据集介绍
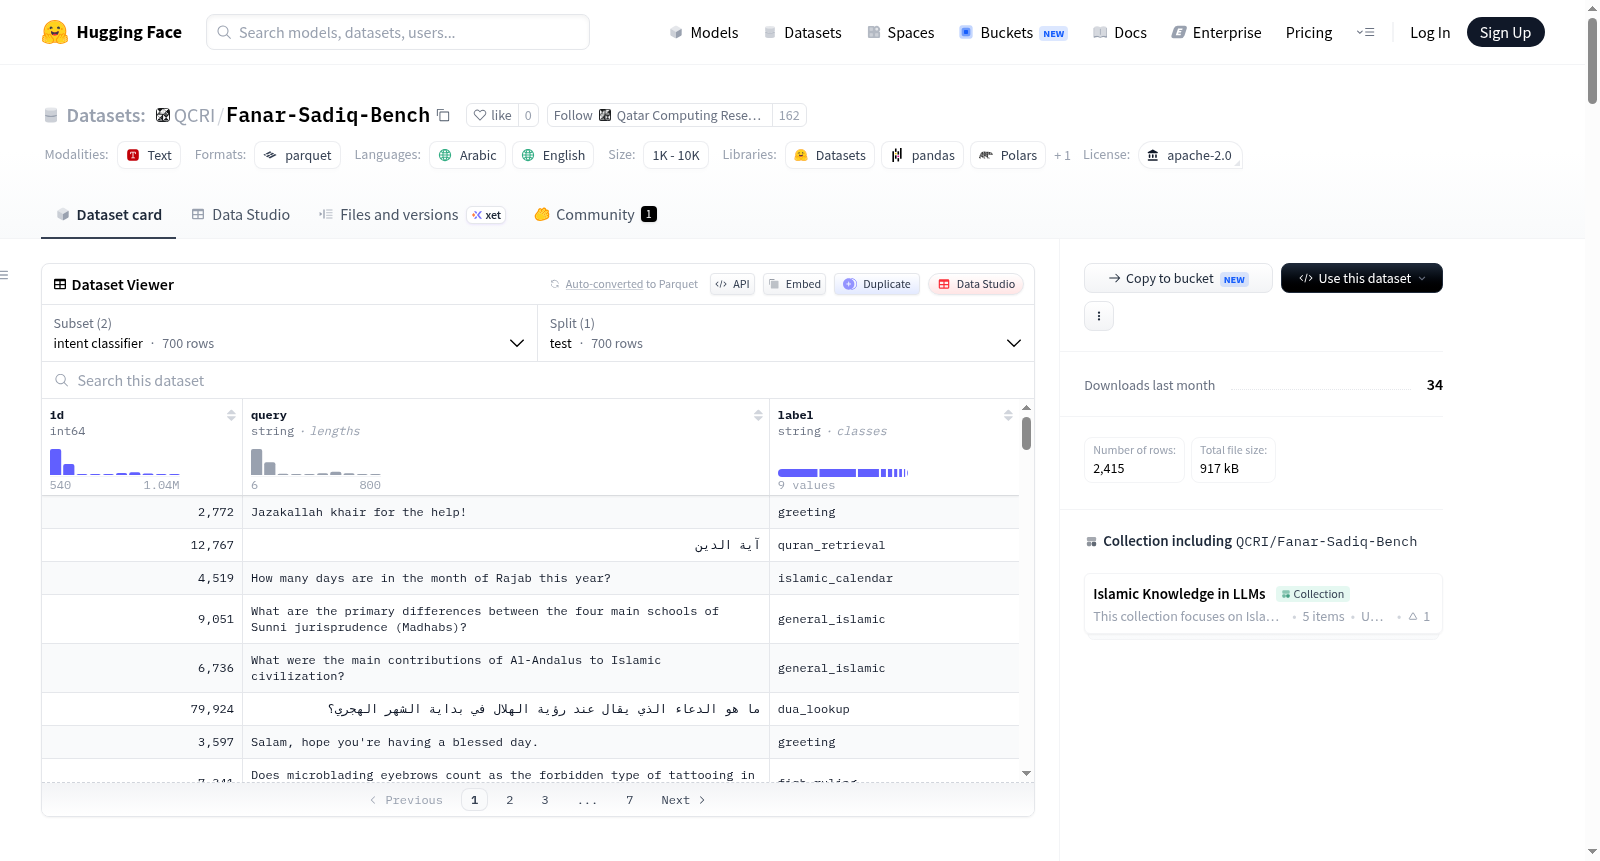
QCRI/Fanar-Sadiq-Bench 数据集图片
构建方式
Fanar-Sadiq-Bench数据集源于面向伊斯兰教义的多智能体问答系统Fanar-Sadiq的路由层需求,旨在实现用户查询的精准分类与定向分发。该数据集包含两个子集:提示分类器(Prompt Classifier)与意图分类器(Intent Classifier)。前者为二分类任务,标注查询是否与伊斯兰内容相关;后者则细分为九类伊斯兰特定意图。数据集以阿拉伯语和英语双语构建,涵盖自然措辞、语码混合、短句、长句、教法推理及工具导向等多种查询类型。意图分类器数据来源于真实用户查询,经匿名化处理后由三位独立标注者标注,最终通过多数投票确定标签,确保标注的一致性与可靠性。
特点
该数据集的核心特色在于其双语(阿拉伯语/英语)与多粒度分类体系,兼顾了通用伊斯兰查询检测与细粒度意图路由。提示分类器提供简洁的二元判别,适用于初筛查询是否进入伊斯兰问答系统;意图分类器则涵盖教法裁决、古兰经检索、天课计算、继承法、祈祷时间等丰富的伊斯兰领域任务,共700条精心标注的样本。数据集不仅涵盖常见宗教问询,还融入了工具性查询(如日历转换)与社交性表达(如问候语),使其在真实场景下具有高度实用性与泛化能力。
使用方法
研究者可通过Hugging Face datasets库便捷加载该数据集,支持直接获取'prompt classifier'与'intent classifier'两个配置下的测试集。典型应用包括训练或评估伊斯兰查询的二分类模型、细粒度意图分类器,以及多智能体系统中的查询路由模块。数据可直接用于文本分类任务的基准测试,输入为用户查询文本,输出则为预设标签之一。该数据集特别适合开发面向宗教领域的鲁棒性问答系统,并可辅助在检索增强生成(RAG)与确定性工具调用之间实现智能切换。
背景与挑战
背景概述
Fanar-Sadiq-Bench数据集诞生于2026年,由卡塔尔计算研究所(QCRI)的研究团队开发,旨在解决多智能体伊斯兰问答系统中的查询路由问题。核心研究问题聚焦于如何准确区分伊斯兰与非伊斯兰查询,并对伊斯兰查询进行细粒度意图分类,以引导至特定模块如古兰经检索、天课计算或清真寺祈祷时间计算。该数据集依托ACL 2026发表的论文,为伊斯兰知识领域的多智能体架构提供了标准化评估基准,对推动宗教领域自然语言处理系统从通用化向专业化、模块化演进具有重要影响。其双语特性(阿拉伯语和英语)及涵盖丰富用户查询风格的设计,使其成为该领域不可多得的资源。
当前挑战
该数据集所解决的领域挑战在于,伊斯兰问答系统需处理高度专业化、多教法学派分歧及上下文敏感的查询,通用分类模型难以胜任。构建过程中面临的挑战尤为显著:其一,用户查询常混杂阿拉伯语与英语,并包含代码转换现象,增加了语言歧义性;其二,意图分类任务涉及9个细粒度标签,如“fiqh_ruling”与“general_islamic”边界模糊,需通过三名标注者独立标注与多数投票筛选;其三,非伊斯兰查询与伊斯兰查询的二元分类需排除文化习俗相关提问的干扰,确保路由准确性。这些挑战使得数据集的标注一致性与类别平衡性成为关键难点。
常用场景
经典使用场景
在自然语言处理与宗教领域知识工程的交叉前沿,Fanar-Sadiq-Bench数据集被广泛用于构建和评估伊斯兰查询分类系统。其经典使用场景聚焦于双任务架构:一是利用Prompt Classifier子集实现伊斯兰内容与非伊斯兰内容的二元判别,二是借助Intent Classifier子集进行细粒度意图分类,涵盖教法裁决、古兰经检索、天课计算、遗产分配、祈祷时间查询等九类伊斯兰领域专有意图。该数据集以阿英双语形式收录了自然口语化、代码混合、工具导向及会话式查询,为多智能体问答系统的路由层提供了首个标准化的评测基准,尤其适用于研究如何将用户查询精准导向检索增强生成、确定性计算或结构化工具调用等不同模块。
解决学术问题
该数据集直面当前大语言模型在宗教领域应用中面临的核心学术挑战:如何在缺乏领域结构化数据的情况下,实现用户意图的鲁棒判别与高效路由。传统通用意图分类系统无法覆盖伊斯兰教特有的计算型查询(如天课与遗产分配)和检索型查询(如古兰经章节定位),而Fanar-Sadiq-Bench通过将问题分解为二元筛选与九类细粒度分类两大任务,为多智能体架构的协调层提供了可复现的评估框架。它填补了阿拉伯语与英语双语宗教领域意图分类数据集的空白,使研究者能够系统评估模型区分教法争议性话题、识别隐性宗教意图、以及处理跨语言代码混合查询的能力,进而推动领域特化型问答系统从端到端范式向模块化、可解释的智能体协同方向演进。
衍生相关工作
围绕Fanar-Sadiq-Bench数据集已衍生出多项具有影响力的研究方向与系统创新。该数据集是Fanar-Sadiq多智能体架构的配套基准,后者通过查询分类器实现路由编排,并整合了古兰经检索、杜阿查找、伊斯兰历法转换及祈祷时间计算等专用模块,形成了首个端到端的伊斯兰领域问答生态。在此基础上,研究者进一步探索了跨语言意图迁移学习,利用该数据集的双语特性训练轻量级分类器以适配低资源语言变体。另一些工作则聚焦于分类器的鲁棒性增强,针对数据集中代码切换、拼写变体及多意图交织的查询模式,发展了对抗训练与难例挖掘策略。此外,该数据集的细粒度标签体系也被迁移至其他宗教研究领域,启发了针对犹太教、基督教等信仰体系的意图分类数据集构建,推动了多信仰知识库与对话系统的标准化评估进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

