Code-170k-dombe
收藏资源简介:
Code-170k-dombe是一个包含176,999个编程对话的数据集,这些对话被翻译成Dombe语言,使得编码教育对Dombe语使用者更加普及。它包含关于编程和编码的高质量多轮对话,覆盖了算法、数据结构、调试、最佳实践等多种主题,并且适用于大型语言模型的指令微调。
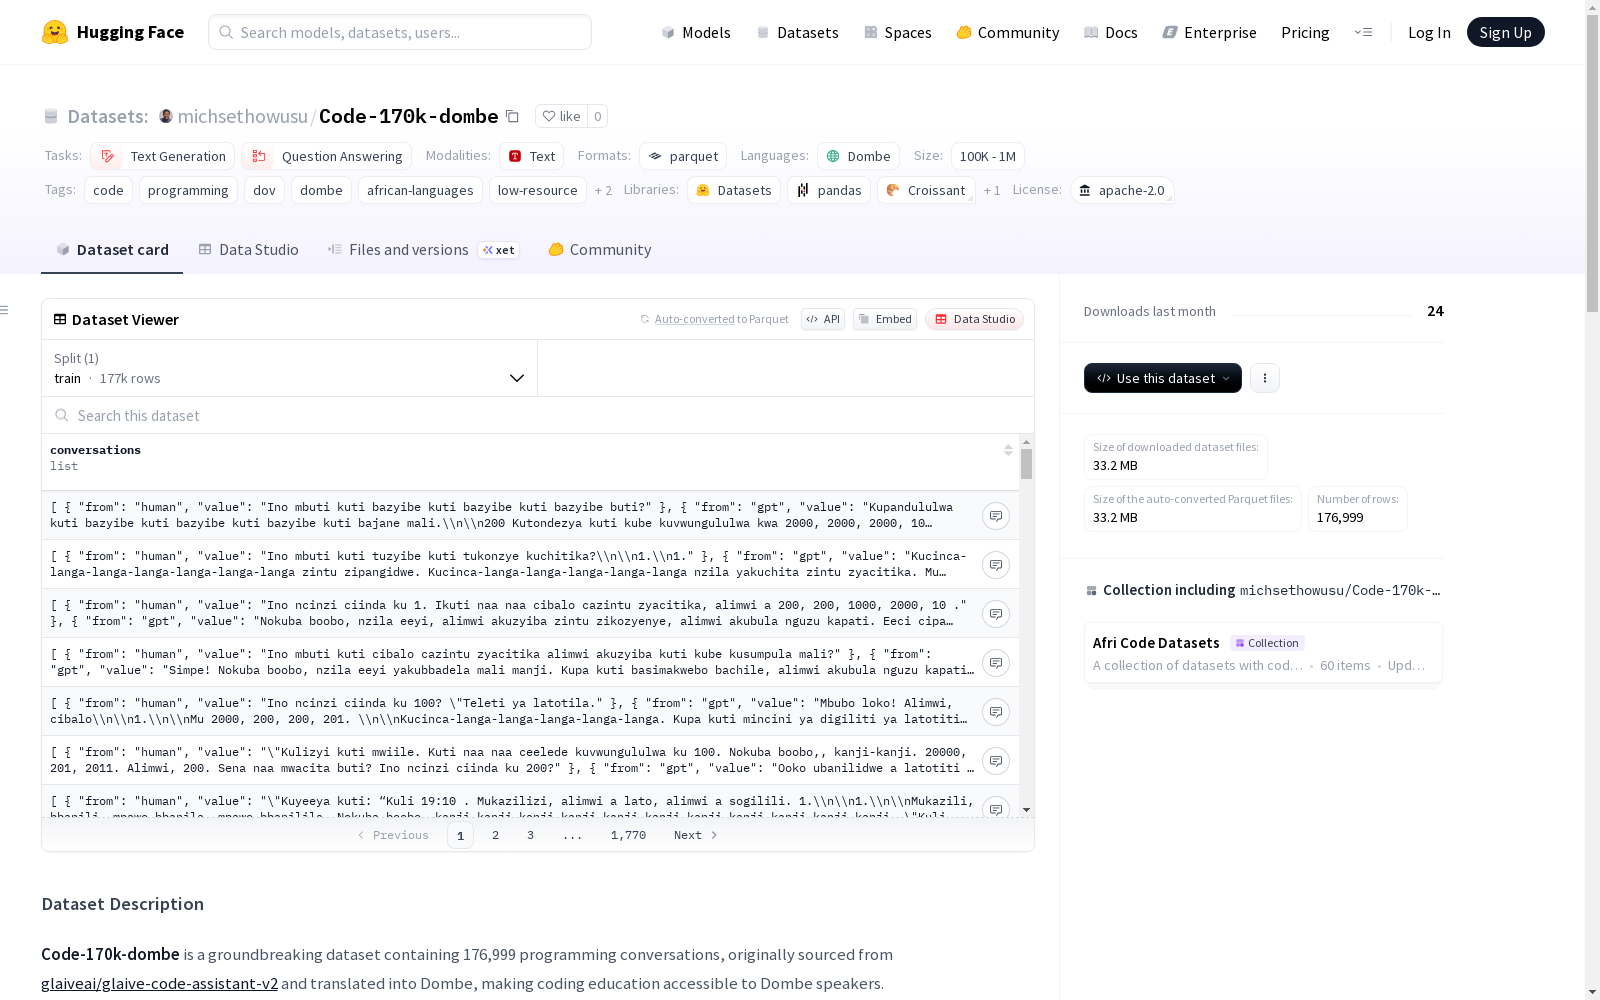
Code-170k-dombe is a dataset containing 176,999 programming conversations. These conversations have been translated into Dombe language to make coding education more accessible to Dombe-speaking users. It includes high-quality multi-turn conversations about programming and coding, covering various topics such as algorithms, data structures, debugging, best practices, etc., and is suitable for instruction tuning of large language models.
Code-170k-dombe 数据集概述
基本信息
- 数据集名称:Code-170k-dombe
- 数据集地址:https://huggingface.co/datasets/michsethowusu/Code-170k-dombe
- 许可证:Apache 2.0
- 语言:多贝语(dov)
数据集规模
- 训练集样本数量:176,999
- 训练集大小:116,431,164字节
- 下载大小:58,215,582字节
- 规模分类:100K<n<1M
数据集描述
Code-170k-dombe是一个包含176,999个编程对话的开创性数据集,原始数据来源于glaiveai/glaive-code-assistant-v2,并翻译成多贝语,使多贝语使用者能够接触编程教育。
主要特征
- 包含176,999个高质量的编程和编码对话
- 纯多贝语内容
- 多轮对话涵盖各种编程概念
- 多样化主题:算法、数据结构、调试、最佳实践等
- 适用于大型语言模型的指令调优
数据结构
数据字段
conversations:对话轮次列表,每个轮次包含:from:发言者("human"或"gpt")value:多贝语的消息内容
数据示例
python { "conversations": [ { "from": "human", "value": "[多贝语问题]" }, { "from": "gpt", "value": "[多贝语回答]" } ] }
任务类别
- 文本生成
- 问答
标签
- 代码
- 编程
- 多贝语
- 非洲语言
- 低资源语言
- 多语言
- 指令调优
使用场景
- 训练多贝语编码助手
- 为多贝语开发者构建教育工具
- 研究多语言代码生成
- 创建多贝语编程教程
- 支持低资源语言人工智能开发