
adamtriwibowo/x-sentimen-analysis-indonesia-program-pemerintah
收藏搜集汇总
数据集介绍
构建方式
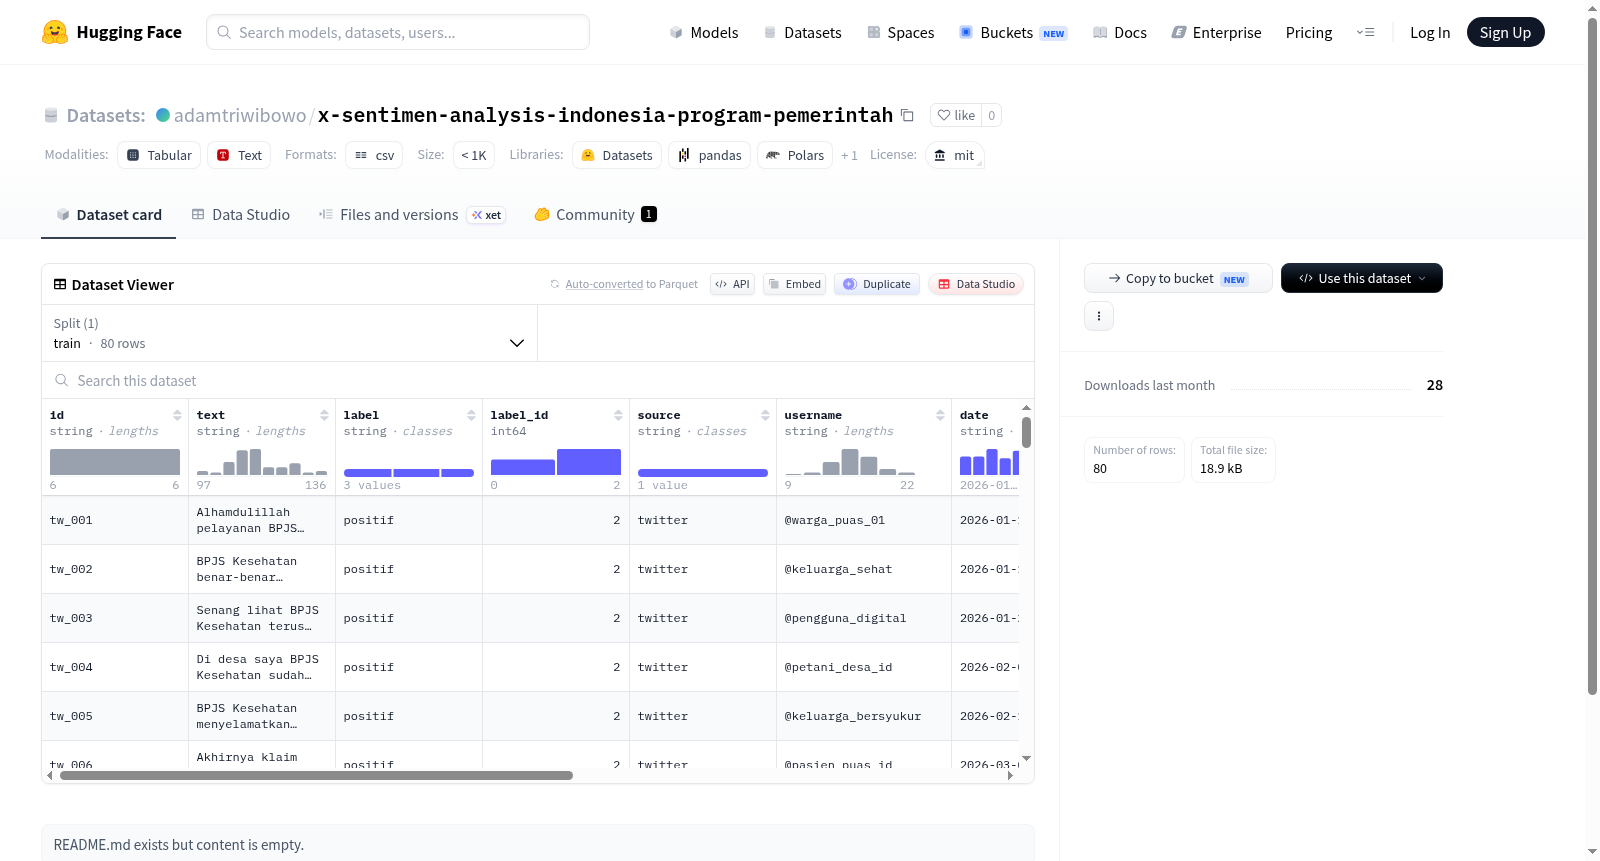
该数据集聚焦于印度尼西亚政府项目的公众情绪分析,其构建过程始于对社交媒体、新闻评论及公开论坛中与政府政策相关文本的广泛采集。为确保数据代表性,采集覆盖了多个省份及不同人群的言论,并通过关键词匹配与语义筛选技术提取涉及教育、基建、卫生等关键领域的句子。随后,由语言专家与本地居民联合标注每条文本的情感倾向(如正面、负面、中立),并依据政府项目类别进行分层归类,形成结构化的多标签数据集。
特点
该数据集的独特之处在于其高度聚焦于印度尼西亚本土语境,不仅覆盖了政府项目的六大核心领域,还通过细粒度的情感维度(如支持、批评、建议、疑惑)深化了分析层次。数据以印尼语为主,保留了地方方言与口语化表达,使得模型能更精准捕捉公众对政策落地的真实反馈。此外,每条样本均附有地理区域与时间戳元数据,支持时空维度下的情绪演变追踪。
使用方法
使用时可加载数据集到transformers库中,通过划分训练与测试子集进行模型微调。推荐采用预训练印尼语语言模型(如IndoBERT)作为基础,利用本数据集的标注信息完成情感分类任务。开发者可将输出结果映射为政策满意度评分或舆情预警信号,也可结合t-SNE等可视化工具分析不同群体对特定项目的情绪分布,从而辅助决策者优化项目实施策略。
背景与挑战
背景概述
在自然语言处理领域,情感分析作为一种关键的技术手段,广泛应用于舆情监测、政策反馈与公共意见挖掘中。然而,针对印尼语的政策相关情感分析数据集长期匮乏,限制了该语言在政府项目评估中的自动化分析能力。x-sentimen-analysis-indonesia-program-pemerintah数据集正是在此背景下诞生,由相关研究机构于近期创建并发布,采用MIT开源许可协议,旨在填补印尼语政策情感分析领域的空白。该数据集聚焦于印尼政府项目相关的社交媒体或文本数据,通过标注情感极性,为研究者提供了训练和评估情感模型的基础资源,对推动低资源语言在公共政策领域的自然语言处理研究具有重要影响。
当前挑战
该数据集所解决的领域问题在于,印尼语情感分析尤其在政府项目语境下,面临语言多样性、非正式表达及文化特异性带来的挑战,传统基于英语的情感模型难以直接迁移适用。同时,在数据集构建过程中,研究人员需应对标注一致性问题,因为政策文本中常含有模棱两可或中性的表述,使得情感极性划分困难。此外,数据采集的覆盖范围与代表性亦构成挑战,确保样本能真实反映不同地区、群体对政府项目的多元意见。这些难题共同影响了数据集的质量与后续模型迁移的泛化能力。
常用场景
经典使用场景
在印尼政府政策评估与舆情监测领域,该数据集被广泛用于针对政府项目(如基础设施建设、社会救助计划等)的公众情感分析研究。研究者能够基于该数据训练模型,自动识别社交媒体、新闻评论或官方反馈渠道中民众对特定政策的态度倾向,从而量化支持、反对或中立情绪的比例分布。这一场景为理解政策落地过程中的民意波动提供了数据驱动的分析框架。
衍生相关工作
基于该数据集,衍生出若干具有影响力的工作,例如针对印尼语情感分析中方言变异与代码混合现象的跨域迁移学习框架,以及融合政策本体知识的情感推理模型。部分研究还探索了将情感标签与地区经济发展指标关联,构建政策满意度预测模型。这些工作不仅深化了印尼语NLP的技术栈,也为东南亚其他国家的政策情感分析提供了可复用的基线标准。
数据集最近研究
最新研究方向
该数据集聚焦于印尼政府项目相关的社交媒体情感分析,为公众对政策反响的量化研究提供了关键资源。在自然语言处理与政治传播交叉领域,研究者借助此数据集探索深度学习模型在低资源语言情感分类中的适配性,尤其针对印尼语特有的文化语境与俚语表达。当前前沿方向包括利用预训练语言模型(如IndoBERT)进行细粒度情绪识别,以捕捉公众对基础设施、公共卫生等政策的多维态度。此外,结合跨语言迁移学习,该数据集被用于评估算法在东南亚语言间的泛化能力,助力揭示政治叙事与社会情绪之间的动态关联,具有重要的社会治理与舆情监测应用潜力。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


