
sarulab-speech/mls_sidon
收藏官方服务:
资源简介:
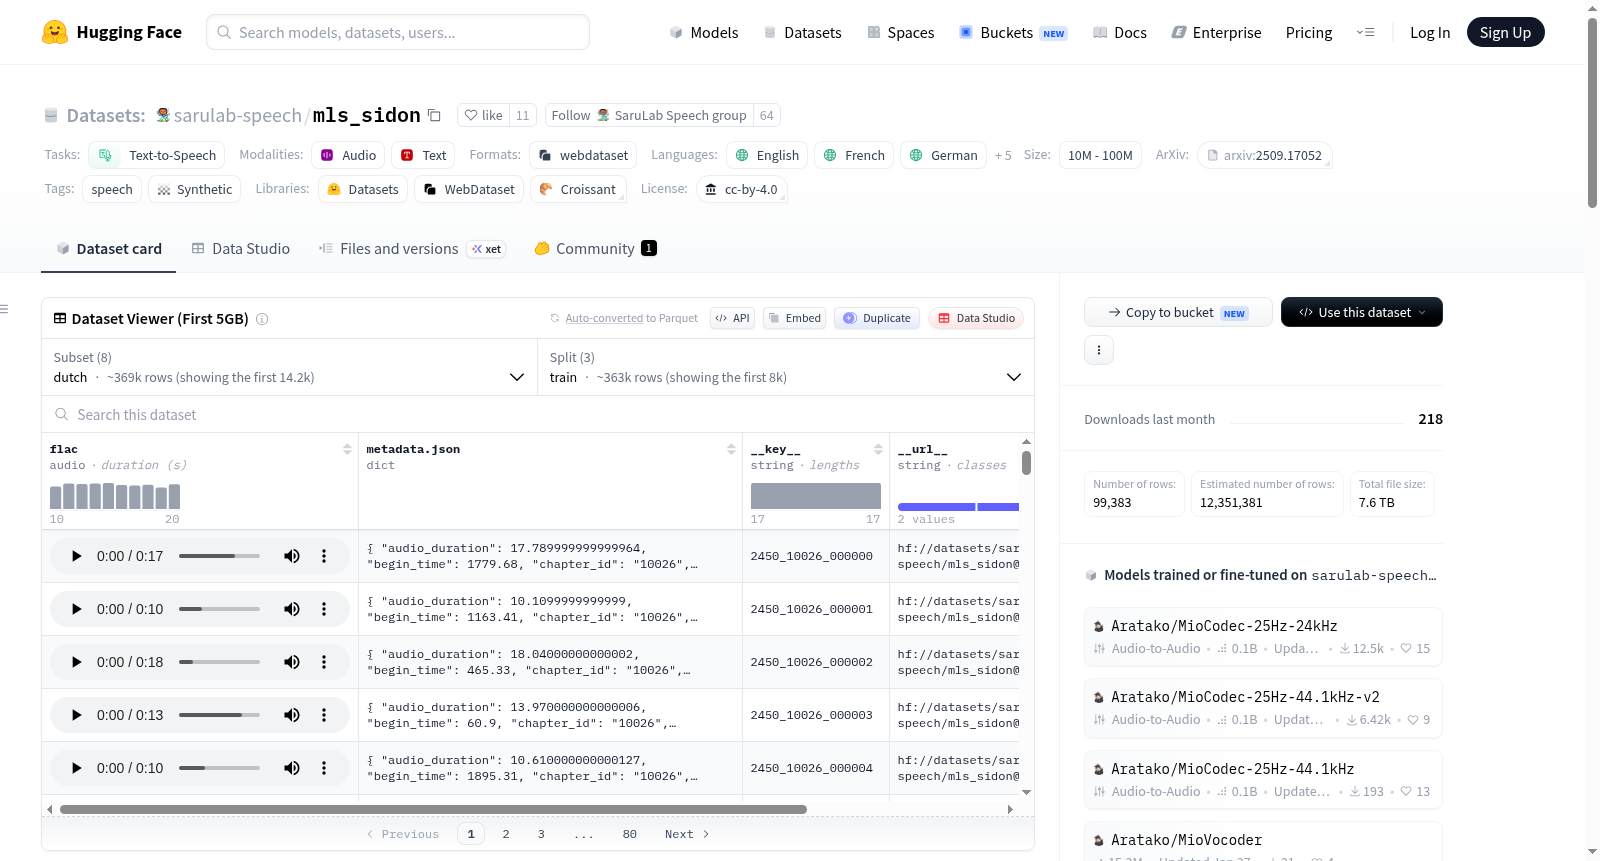
MLS-Sidon数据集是一个针对语音合成和口语语言建模的Multilingual LibriSpeech的清洗版。它包含了多种语言的语音数据,如英语、德语、法语、西班牙语、意大利语、波兰语、荷兰语和葡萄牙语。数据集以WebDataset格式存储,每个样本包括48 kHz单声道FLAC音频文件和可选的包含语言、说话者ID和原始MLS引用的JSON格式元数据文件。
MLS-Sidon dataset is a cleansed version of Multilingual LibriSpeech designed for speech synthesis and spoken language modeling. It contains speech data in multiple languages including English, German, French, Spanish, Italian, Polish, Dutch, and Portuguese. The dataset is stored in WebDataset format, with each sample consisting of a 48 kHz single-channel FLAC audio file and an optional JSON metadata file that includes language, speaker ID, and original MLS reference.
提供机构:
sarulab-speech搜集汇总
数据集介绍
构建方式
MLS-Sidon数据集是基于Multilingual LibriSpeech(MLS)进行深度清洗与语音修复的产物。其构建过程引入了Sidon语音修复模型,旨在提升原始多语种语音数据的质量与一致性。数据以WebDataset格式组织,每个样本包含48kHz单声道FLAC音频文件及可选的元数据JSON文件,涵盖语言、说话人ID与原始MLS参考信息。数据集覆盖英语、德语、法语、西班牙语、意大利语、波兰语、荷兰语和葡萄牙语共八种语言,各语言均划分训练、验证与测试子集,并以压缩tar分片形式存储,便于大规模高效加载。
特点
该数据集的核心优势在于其经Sidon模型修复后的高保真语音质量,显著优于原始MLS,特别适用于文本转语音与口语语言建模任务。采用WebDataset格式使得数据流式处理与分布式训练极为便捷,支持按语言配置灵活加载。数据集规模庞大(1亿至10亿样本量),且遵循CC-BY-4.0许可协议,为多语言语音研究提供了开放、可靠且经过优化的资源。每个样本的元数据保留了语言与说话人信息,有助于细粒度分析与模型泛化能力评估。
使用方法
使用者可通过Hugging Face的datasets库高效加载该数据集。需先下载包含文件路径的YAML配置文件,随后基于语言与数据划分(如英语的测试集)构建WebDataset加载器,并设置streaming=True实现流式读取。示例代码展示了如何迭代获取样本中的FLAC音频与元数据,并利用IPython.display播放音频。用户只需替换language变量为指定语言(如german或french),即可无缝切换至其他语种子集,适用于多语言语音模型的训练与评估流水线。
背景与挑战
背景概述
在语音合成与口语语言建模领域,大规模多语言数据集的可用性对模型性能提升至关重要。Multilingual LibriSpeech(MLS)作为一项里程碑式的开源资源,由Vineel Pratap等人于2020年提出,涵盖了包括英语、德语、法语等八种语言的音频数据,为跨语言语音研究奠定了坚实基础。然而,原始MLS数据集在构建过程中不可避免地引入了噪声和低质量样本,限制了其在下游任务中的表现。为应对这一局限,由Wataru Nakata、Yuki Saito、Yota Ueda及Hiroshi Saruwatari等人组成的团队于2025年推出了MLS-Sidon数据集。该数据集基于Sidon语音恢复技术对原始MLS进行深度清洗与增强,旨在为多语言文本到语音合成及口语语言建模提供高质量、规模化的训练资源。其发布不仅提升了数据纯净度,还通过WebDataset格式优化了大规模训练的效率,对推动多语言语音技术的进步具有重要影响力。
当前挑战
该数据集面临的核心挑战涵盖两个层面:首先,在领域问题层面,多语言语音合成与口语语言建模需应对语音数据中普遍存在的背景噪声、录音设备差异、说话人风格变化及语言间声学特征异质性等难题。原始MLS虽规模庞大,但未经精细处理的数据会引入伪影,导致合成语音的自然度和清晰度下降,尤其在高资源与低资源语言间表现不均衡。其次,在构建过程中,团队需克服从海量多语种音频中高效识别并消除噪声、修复失真片段的技术瓶颈。Sidon方法的鲁棒性与计算效率需在八种语言上得到验证,同时确保清洗后的数据不丢失关键语音特征。此外,将数据组织为WebDataset格式以支持流式加载,对数据分片策略、存储架构及兼容性提出了额外要求,需平衡压缩效率与随机访问的灵活性。
常用场景
经典使用场景
MLS-Sidon数据集作为多语言语音合成与口语语言建模的基石,其经典使用场景聚焦于构建高质量、多语种的文本到语音系统。研究者可借助该数据集涵盖的英语、德语、法语等八种语言,训练出音质纯净、韵律自然的合成模型。其经Sidon语音修复技术处理后的音频,有效消除了原始MLS数据集中的背景噪声与录音瑕疵,为跨语言语音合成提供了可靠的数据支撑,从而推动多语言语音助手与有声内容生成技术的发展。
实际应用
在实际应用中,MLS-Sidon可赋能多语言智能客服系统,使其以地道口音和自然语速完成跨语言交互。例如,金融与旅游行业的语音机器人可借助该数据集训练出支持英语、法语、西班牙语等多语种的对话模块,提升用户满意度。此外,该数据集还可用于教育领域的语言学习软件,通过生成标准发音的例句辅助学习者纠正发音,以及为视听障碍人士的辅助阅读工具提供流畅的语音输出服务。
衍生相关工作
MLS-Sidon的出现催生了一系列相关研究工作,其中最具代表性的是Sidon语音修复模型本身的优化与扩展。研究者在此基础上探索了更高效的噪声抑制算法,并尝试将其应用于低资源语言的音频增强。同时,该数据集也被用于验证多语言语音识别模型在清洁数据下的性能上限,启发诸如XLS-R、Whisper等预训练模型在微调阶段采用类似的数据清洗策略。此外,基于MLS-Sidon的跨语言语音转换研究也逐步兴起,推动了语音风格迁移技术的边界拓展。
以上内容由遇见数据集搜集并总结生成


