
atlasia/darija-english-combined
收藏官方服务:
资源简介:
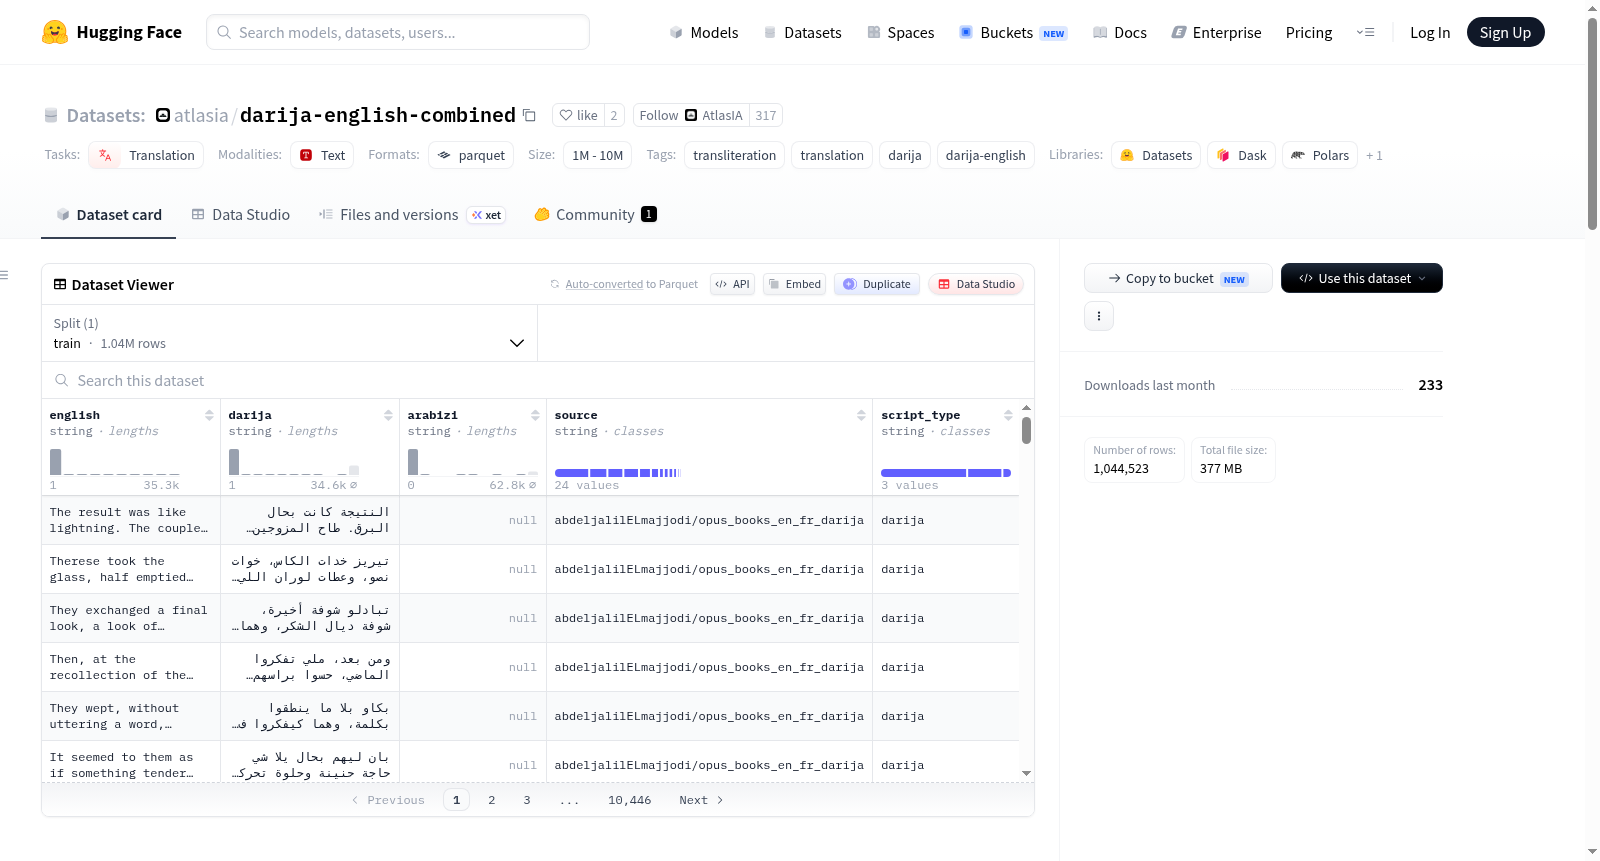
这是一个英语-达里贾语-阿拉伯齐语平行数据集。该数据集合并并规范化了多个公开的英语-摩洛哥达里贾语数据集,形成一个统一的格式,适用于训练翻译或方言模型。数据集包含英语句子、阿拉伯文字符的达里贾语、拉丁字符的阿拉伯齐语(达里贾语的拉丁化表示),以及数据来源和脚本类型信息。数据经过规范化、过滤、脚本类型标注和去重处理,确保质量和一致性。
This is an English-Darija-Arabizi parallel dataset. This dataset consolidates and normalizes multiple publicly available English-Moroccan Darija datasets into a unified format suitable for training translation or dialect models. The dataset contains English sentences, Darija in Arabic script, Arabizi (the Latinized representation of Darija) in Latin script, along with information about data sources and script types. The data has undergone normalization, filtering, script type annotation and deduplication to ensure quality and consistency.
提供机构:
atlasia搜集汇总
数据集介绍
构建方式
该数据集通过整合多个公开的英语-摩洛哥阿拉伯语(Darija)平行语料库,构建了一个统一且规范化的翻译与方言模型训练资源。其构建流程涵盖四阶段:首先,对来自四个不同源数据集(包括仅含Arabizi拉丁转写、双脚本合成、大规模双语及书籍源)的语料进行字段映射与标准化处理,统一至共同的英文、Darija阿拉伯文、Arabizi拉丁文、来源及脚本类型五元组结构。其次,基于非空判别原则进行行级过滤,确保每条样本至少包含英文及Darija或Arabizi中的一种形式。随后,依据可用脚本类型为每行添加分类标签(仅Darija阿拉伯文、仅Arabizi拉丁文或两者兼有)。最终,将各标准化数据集拼接,并根据预定义的源数据集优先级对重复句对进行去重,保留优先级最高版本,形成此逾百万条的高质量平行语料集合。
使用方法
该数据集的使用极为便捷,完全兼容HuggingFace Datasets库的标准加载方式。用户仅需通过一行Python代码,即`from datasets import load_dataset; ds = load_dataset('atlasia/darija-english-combined', split='train')`,即可将完整的训练集加载至内存或流式读取。加载后的数据集可直接通过字典或类属性方式访问各字段(`english`、`darija`、`arabizi`、`source`、`script_type`),用于多种自然语言处理下游任务。例如,基于`english`与`darija`列可训练英-阿翻译模型;利用`arabizi`列可构建英语至Darija拉丁转写的翻译系统;而`script_type`列则支持研究者按脚本进行数据筛选,从而训练专用于特定书写形式的模型或开展多脚本对比研究。
背景与挑战
背景概述
摩洛哥阿拉伯语(Darija)作为马格里布地区广泛使用的口语变体,在自然语言处理领域长期面临资源稀缺的困境。为弥合这一鸿沟,研究者构建了darija-english-combined数据集,该数据集于近年由多机构合作完成,整合了ilias-brh、Haitam03、BounharAbdelaziz及abdeljalilELmajjodi等公开语料库,形成包含超过百万条英文–Darija–Arabizi平行句对的统一资源。核心研究目标在于为方言翻译、转写及跨脚本建模提供标准化基准,其统一的Schema设计与脚本类型标注(darija/arabizi/both)显著降低了多源异构数据的整合壁垒,推动了低资源阿拉伯方言处理领域的研究进展。
当前挑战
该数据集面临的核心挑战在于双重维度:其一,Darija本身作为无标准正字法的口语方言,同一语义在阿拉伯字母(darija)与拉丁字母(arabizi)间存在严重的拼写歧义,且混合代码切换现象频繁,这给神经机器翻译模型的鲁棒性训练带来根本性困难。其二,构建过程中需处理多源数据间的格式异构性与语义冲突,例如不同来源对缺失脚本的表示方式各异(空值、空字符串或占位符),必须设计复杂的归一化与优先级去重策略(如基于来源权威性的冲突消解),同时保证数据清洗不破坏低资源方言样本的稀缺性,这些流程的平衡构成了工程实现上的主要挑战。
常用场景
经典使用场景
在自然语言处理与低资源语言机器翻译的前沿探索中,摩洛哥阿拉伯语(Darija)作为一种与标准阿拉伯语差异显著的口语变体,长期受限于平行语料匮乏的困境。darija-english-combined数据集通过整合多个公开的英-达里贾平行语料库,并统一规范为包含英语、阿拉伯语脚本达里贾、拉丁化阿拉伯语(Arabizi)及脚本类型的结构化格式,为双语翻译模型的训练提供了高质量、多脚本的基准资源。该数据集最经典的应用场景是构建达里贾与英语之间的神经机器翻译系统,尤其适用于处理阿拉伯语脚本与拉丁脚本混用的多模态翻译任务,同时支持对脚本类型进行细粒度标注,为方言语言学的跨脚本研究开辟了新的可能性。
解决学术问题
该数据集的核心学术贡献在于解决了摩洛哥阿拉伯语作为低资源方言在机器翻译领域中数据碎片化、格式不统一的根本性问题。它通过整合来自书籍、合成数据及大规模人工标注等多元来源的104万句对,并引入基于源优先级的去重机制与脚本类型标注,显著提升了训练数据的覆盖度与一致性。这一举措不仅为达里贾的神经机器翻译模型提供了有力的训练支撑,还促进了方言语言学中阿拉伯脚本与拉丁脚本转写对比研究的深入展开。其影响在于为北非马格里布地区的低资源方言NLP研究奠定了标准化数据基础,推动了跨方言迁移学习与多语言翻译模型的泛化能力提升,对保存和数字化濒危方言具有深远的学术价值。
实际应用
在实际应用层面,darija-english-combined数据集可赋能多类面向摩洛哥及北非用户的商业和社会服务场景。例如,在旅游与文化交流领域,基于该数据集训练的翻译系统能够实时将在线评论、路标或菜单中的达里贾内容转化为英语,弥合语言隔阂;在社交媒体分析中,模型可以处理用户生成的混合脚本内容(如阿拉伯语与拉丁字母混写的帖子),用于情感监测或区域舆情分析;此外,它还能服务于智能客服系统,使摩洛哥本地企业能够用达里贾与英语双语交互,提升用户服务体验。对于移民社群,该数据集支撑的翻译工具可帮助维持母语代际传递,促进跨文化沟通与社区融合。
数据集最近研究
最新研究方向
在摩洛哥方言(Darija)与英语的双语机器翻译与转写研究中,darija-english-combined数据集的出现为低资源阿拉伯方言自然语言处理注入了新活力。该数据集聚合并标准化了来自多个开源语料库的逾百万条平行句对,涵盖阿拉伯字母书写的Darija与拉丁字母转写(Arabizi),并引入脚本类型标注以区分纯A rabizi、纯Darija及双语并存的情形。当前,该数据集被广泛应用于端到端翻译模型的训练与评估,尤其聚焦于混合脚本场景下的跨语言迁移学习。前沿方向包括利用对比学习与多任务框架同时建模翻译与转写任务,以及基于编码器-解码器结构探索方言特有形态和句法的隐式表征。伴随着摩洛哥本地数字媒体与社交平台中Darija文本量激增,该数据集对区域语言资源建设、方言级语音助手研发及跨方言情感分析具有重要的推动意义。
以上内容由遇见数据集搜集并总结生成


