
DarianNLP/mda_step0_cache_NEW_with_labels_better
收藏官方服务:
资源简介:
该数据集用于机械可解释性研究,包含用于分析神经网络内部表示的多个特征,如基础数据、编码器权重、选定特征索引等,以及多个实验配置(附录、有害平衡、有害无害、有害自然等)。数据集包含代码主题和命令类型的标签,旨在研究模型对有害/无害指令的处理机制。
This dataset is designed for mechanistic interpretability research. It contains multiple features for analyzing neural network internal representations, such as base data, encoder weights, selected feature indices, and several experiment configurations (appendix, harmful_balanced, harmful_harmless, harmful_natural). It includes labels for code topics and command types, aiming to study the models processing of harmful/harmless instructions.
提供机构:
DarianNLP搜集汇总
数据集介绍
构建方式
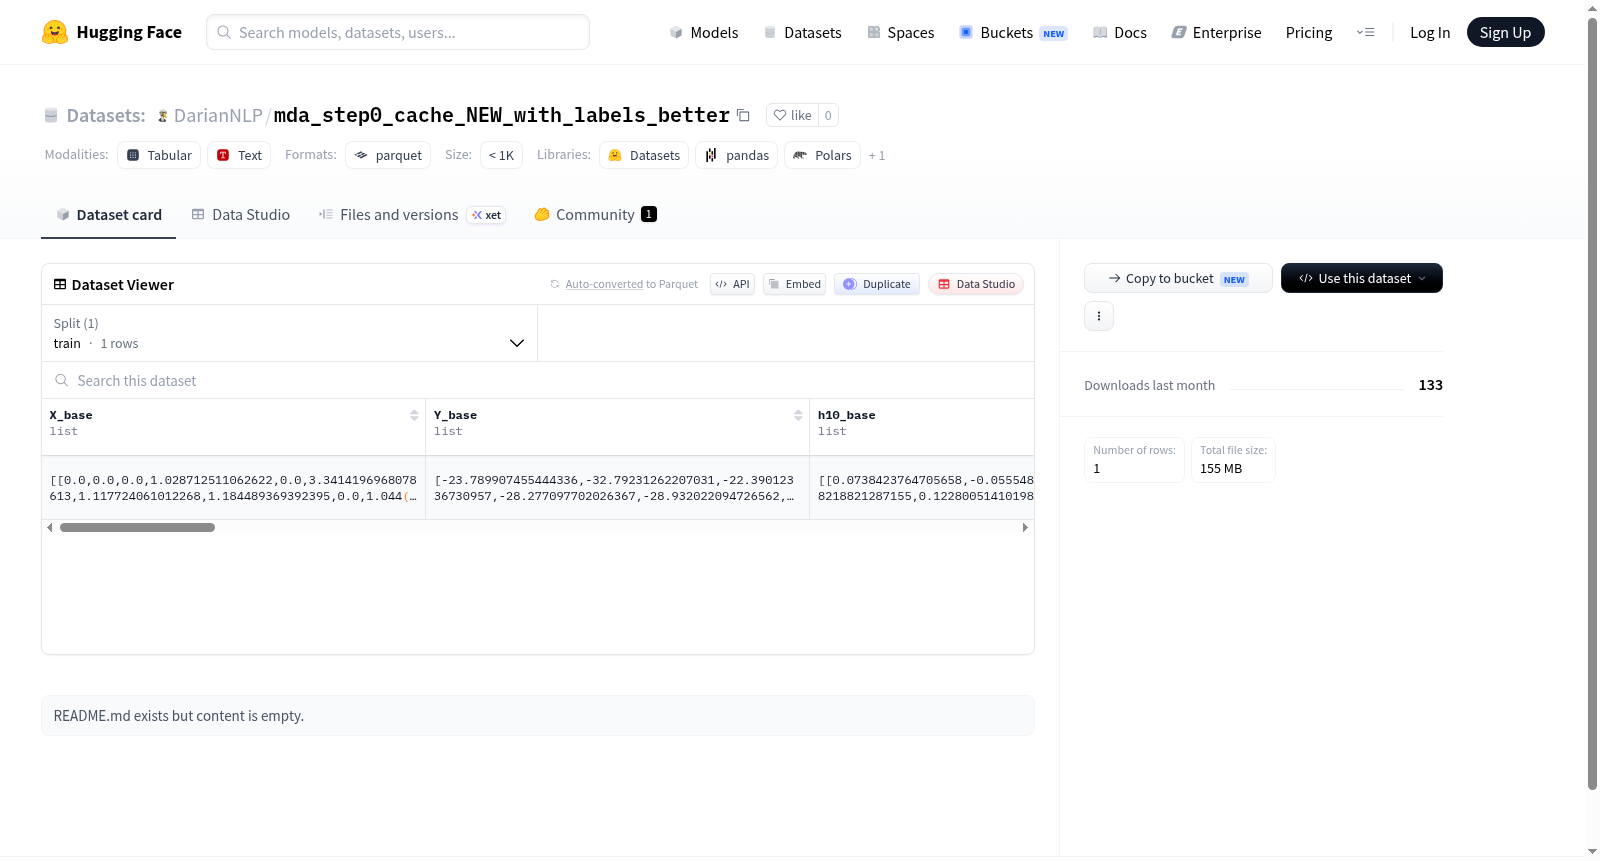
该数据集mda_step0_cache_NEW_with_labels_better的构建融合了多层神经网络中间表征与实验配置信息,旨在为可解释性分析提供结构化数据。其核心包含基础特征(X_base、Y_base、h10_base)及对应的标签数据(prompt_labels、refused_labels),并辅以编码器参数(W_enc_sel、b_enc_sel)与所选特征索引(selected_feature_indices)。通过LAMBDA、LAYER与TARGET_SEQUENCES等参数记录实验设定,将不同干预条件(如appendix、harmful_balanced、harmful_harmless、harmful_natural)下的逆映射矩阵(U_inv)、权重向量(W)及索引(indices)组织为嵌套结构experiments,实现了对多场景实验结果的系统化存储。
特点
数据集呈现鲜明的结构化与多维度标注特色。其单条训练样本即包含海量浮点型数组与嵌套实验记录,反映了对模型中间层操作的高密度抽象。尤为突出的是,系统标记了代码主题(code_topic)、命令类型(code_type_of_command)及对应的推理标签(topic_reasoning、command_reasoning),并额外提供了精简版本(code_topic_collapsed、code_type_of_command_collapsed),这有助于研究者从不同颗粒度探究模型的行为模式。结合refused_labels等安全相关标注,数据集兼顾了模型行为分析与安全对齐评估的双重需求,展现出较强的领域针对性。
使用方法
适用时,可基于HuggingFace Datasets库加载该数据集,指定'default'配置即可获取训练分片。通过访问各特征名称(如X_base、experiments),用户可提取数理表征与实验前设,以复现或拓展神经网络的内在解释性研究。推荐利用experiments字段中的多种干预配置(如harmful_balanced)进行对比分析,并结合code_topic与command_reasoning等分类标签开展细粒度的模型行为归因。由于数据集仅包含一个训练样本,实际运用时需注意其作为缓存或中间结果的定位,通常不直接用于传统训练,而更适用于离线分析、特征可视化或作为下游可解释性流程的输入模块。
背景与挑战
背景概述
该数据集由研究机构于近期创建,专注于探究大型语言模型(LLMs)在安全对齐中的内部表征与行为机制。核心研究问题在于理解模型如何编码和响应有害或无害的提示,通过记录包括基座模型隐藏状态、编码器参数、实验配置(如多种对抗性实验范式)以及标注的提示标签等全面特征,为机械可解释性分析提供结构化数据。其影响力体现在为揭示模型安全机制的底层运作和脆弱性提供了关键实证基础,推动了对对齐可信度的深入理解。
当前挑战
该数据集所解决的领域挑战在于,现有的对齐评估方法多依赖输入-输出行为,难以触及模型内部表征的复杂交互,而该数据旨在破解隐藏状态与安全决策间的映射关系。构建过程中面临的挑战包括:整合多样化实验场景(如平衡采样、有害-无害对比)以确保表征的全局代表性,同时处理高维稀疏特征的选择与编码,以及确保不同实验配置下数据的一致性与可复现性,这对数据规模和质量控制提出了极高要求。
常用场景
经典使用场景
在可解释人工智能(XAI)与大型语言模型(LLM)安全对齐的交叉研究领域,mda_step0_cache_NEW_with_labels_better数据集扮演着至关重要的角色。该数据集的经典使用场景聚焦于解析模型内部表征中隐藏的拒绝行为机制。研究者利用其中存储的线性探针权重(W_enc_sel、b_enc_sel)、选定的特征索引以及精心设计的评估提示(eval_prompts),能够系统性地在模型的特定中间层(如由LAYER和TARGET_SEQUENCES指定的层次与目标序列位置)探测与安全拒绝相关的方向。通过对比不同实验配置(如harmful_balanced与harmful_natural)下的探针表现,学者们得以精准定位模型在面临恶意请求时,其内部计算流中究竟是哪些特征向量在驱动“拒绝回答”这一关键决策,从而为理解模型对齐原理提供了数据驱动的实验基础。
实际应用
在实际应用层面,mda_step0_cache_NEW_with_labels_better数据集的价值主要体现在服务于高级语言模型安全开发与防御的工程实践。安全工程师可以加载该数据集中的探针参数和实验配置,直接复现对特定模型在特定层次的安全状态监测。例如,通过读取harmful_harmless配置下的U_inv和W矩阵,开发人员能够迅速评估现有模型在面对无害请求与有害请求时内部表示的距离差异,从而实时量化模型的安全裕度。这种能力可以被集成到在线监控系统中,在模型对用户输入生成回答之前,通过内部探针的快速推理来预警潜在的拒绝失败风险。此外,该数据集还支撑了基于特征修正的安全增强策略:通过识别出与拒绝正相关的关键特征索引,工程师能够微调模型在该方向上的激活强度,从而在不影响通用能力的前提下强化安全护栏。
衍生相关工作
该数据集作为安全对齐表征研究的催化剂,已衍生出一系列具有深远影响力的相关工作。在方法论上,它启发了后续研究对线性探针结构进行泛化,通过使用多层感知机或基于注意力的探针架构来捕捉更复杂的非线性拒绝逻辑。在应用拓展方面,有研究基于该数据集中的特征索引和权重,开发了被称为“安全方向注入”的技术,即在推理时通过修改特定层的隐藏状态来强制模型实施更严格的内容审查。此外,围绕其中实验配置(如harmful_natural与harmful_balanced)的对比分析,衍生出了关于“越狱提示”如何影响内部拒绝边界偏移的研究分支。这些工作共同构建了一个从探针发现→机制解释→干预编辑→鲁棒防御的完整研究闭环,极大地丰富了可解释安全对齐的理论体系与工具链。
以上内容由遇见数据集搜集并总结生成


