
llm-fossils
收藏数据链接:
官方服务:
资源简介:
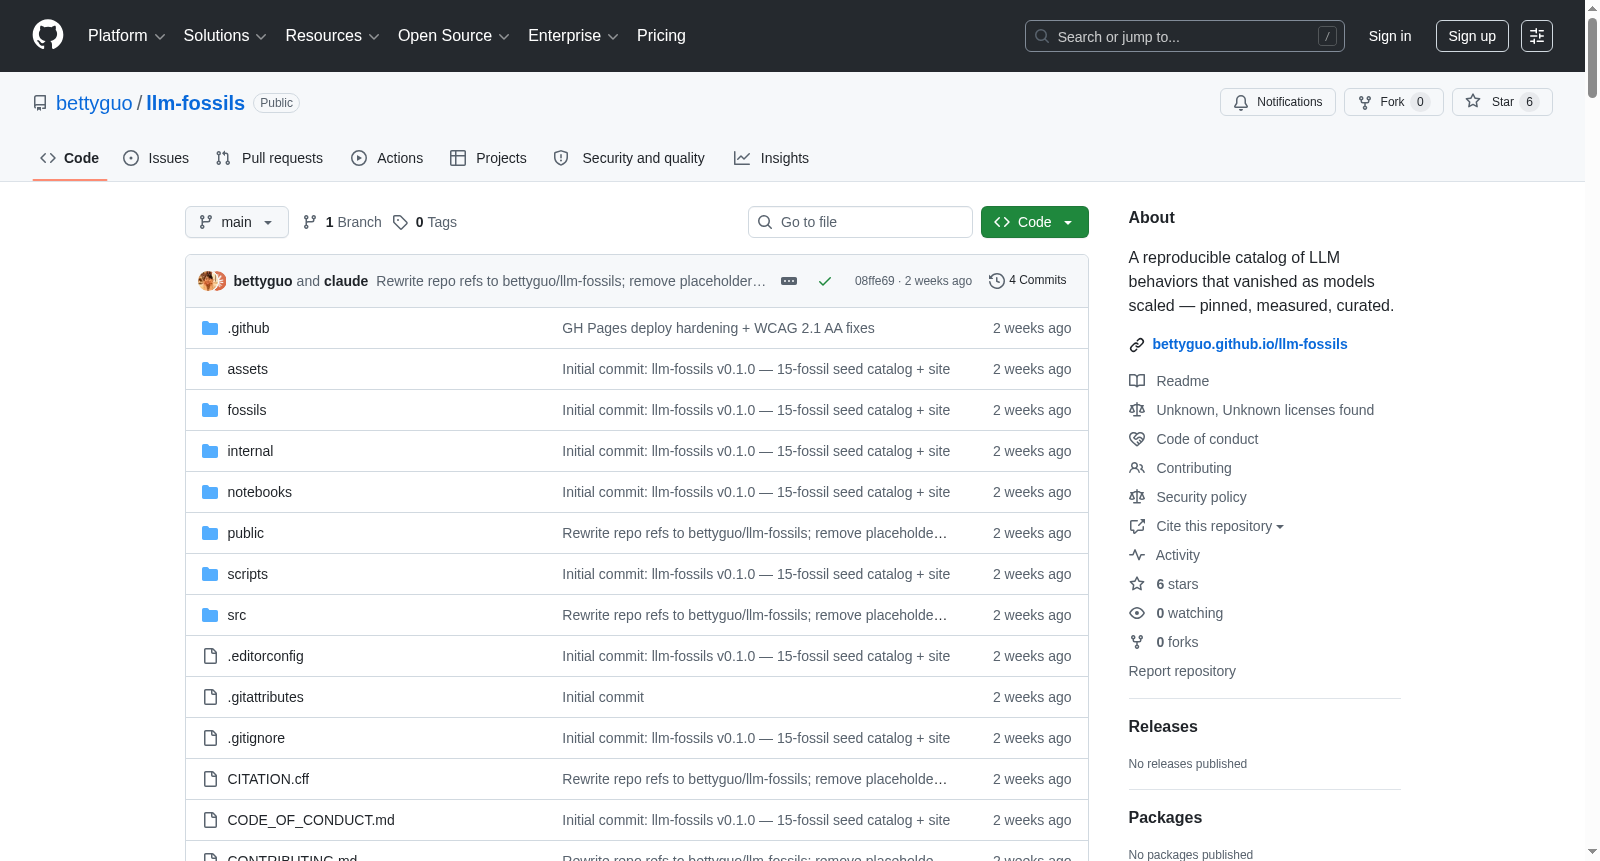
一个关于LLM行为化石的可复现目录,记录了随着模型规模扩大而消失的行为——固定、测量、整理。每个条目都是一个标本卡片:固定的模型快照、精确提示、二十次试验中的测量再现率,以及解决该案例的技术。
A reproducible catalog of LLM behavioral fossils that documents behaviors which disappear with increasing model scale: fixation, measurement, and organization. Each entry is a specimen card containing a fixed model snapshot, precise prompts, the measurement reproduction rate across twenty trials, and techniques for resolving the given case.
创建时间:
2026-05-23
原始信息汇总
数据集概述
基本信息
- 名称: llm-fossils
- 地址: https://github.com/bettyguo/llm-fossils
- 核心概念: 一个“LLM古生物学”目录,收录那些随着模型规模扩大而消失的模型行为(“活化石”)。每个条目为一个“标本卡”,包含固定的模型快照、精确提示词、二十次试验测得的复现率,以及解决该行为的技术。
- 当前规模: 已收录 15个化石 候选标本,覆盖 7个模型家族,观察时间跨度为 2019–2023年,解答文献追溯至 2024年。
状态分类
所有条目目前均为 CANDIDATE(候选)状态,即数据来源于已发表文献,尚未经策展人亲自验证。策展人运行验证后,状态将升级为:
- EXTINCT(已灭绝): 在固定模型上可复现,但在前沿模型上不复现。需经策展人验证。
- ALIVE(存活): 行为仍在当前前沿模型上复现。
- DISPUTED(有争议): 复现结果不一致或存在可靠质疑。
- CANDIDATE(候选): 种子数据来自文献,策展人尚未亲自运行验证。
代表性化石示例
| 编号 | 化石名称 | 表现模型 | 解决技术 | 复现率 | 状态 |
|---|---|---|---|---|---|
| 001 | 贪心解码重复循环 | gpt2 (124M) |
核采样/ top-p 采样 (Holtzman et al. 2020) | 50次试验中92% | CANDIDATE |
| 002 | 异常令牌——SolidGoldMagikarp | text-davinci-003 (175B) |
分词器审计与重训练 (Rumbelow & Watkins 2023) | 50次试验中95% | CANDIDATE |
| 007 | 基础模型指令盲区 | Llama-2-7b 基础版 (7B) |
SFT + RLHF (Touvron et al. 2023) | 50次试验中72% | CANDIDATE |
| 010 | GSM8K上的CoT放大效应 | gpt-3.5-turbo-0301 (175B) |
原生推理 + 规模 (Wei et al. 2022) | 50次试验中83% | CANDIDATE |
| 012 | 中间信息丢失 | gpt-3.5-turbo-0301 (4k上下文) |
长上下文训练 (Liu et al. 2023) | 中间上下文处50% | CANDIDATE |
| 013 | 必需任务前缀 | t5-base (220M) |
指令微调 (Chung et al. 2022) | 50次试验中90% | CANDIDATE |
数据质量与反造假规范
- 每个化石必须具有固定模型版本(HuggingFace提交哈希或闭源API的固定快照ID)、精确提示词、经≥20次试验测得的复现率、前沿模型对比试验(≥5次),以及明确的解决技术与引用。
- 每个化石附带 Colab笔记本,用于复现验证。
- 架构上强制执行反造假检查:禁止使用标签/分支作为版本标识、禁止缺失笔记本、禁止使用“编辑腔”词汇(如dumb, broken, stupid等)、状态与验证一致性检查、化石ID唯一性检查。
- EXTINCT状态升级必须由策展人亲自运行笔记本。
- 复现率为0 仅允许
DISPUTED状态使用。
与其他资源对比
- llm-fossils: 关注的是“某个行为的消失”,附带时间轴、≥20次试验、前沿模型对比试验、明确解决技术、反造假CI、每化石Colab可复现。
- 基准测试套件(HELM, lm-eval): 关注的是评分任务,通常只有最新模型、单次通过、无解决技术标注、无可复现Colab。
- 论文复现目录: 关注的是论文及其代码,无跨时间比较、无固定对比试验、无强制可复现性CI。
提交与贡献
- 提交一个化石预计耗时约30分钟(如已有可靠复现)。需满足:固定模型版本、精确提示词、≥20次试验测得复现率、前沿模型对比试验≥5次、明确解决技术与引用。
- 提交入口:https://github.com/bettyguo/llm-fossils/issues/new?template=fossil-submission.yml
浏览与导航
- 主站: https://llm-fossils.openproblems-labs.org
- 画廊: https://llm-fossils.openproblems-labs.org/gallery(全部15个化石,支持搜索与筛选)
- 时间线: https://llm-fossils.openproblems-labs.org/timeline(按首次记录年份排列)
- 按技术归类: https://llm-fossils.openproblems-labs.org/solved-by(按解决技术分组)
- 按模型家族: https://llm-fossils.openproblems-labs.org/family/openai(如openai, meta-llama, EleutherAI等)
- 方法论: https://llm-fossils.openproblems-labs.org/methodology(状态定义与升级规则)
- RSS订阅: https://llm-fossils.openproblems-labs.org/rss.xml(新化石与状态变更通知)
引用方式
bibtex @misc{llm_fossils_2026, title = {llm-fossils: A Reproducible Catalog of LLM Behaviors That Disappeared at Scale}, author = {openproblems-labs}, year = {2026}, url = {https://github.com/bettyguo/llm-fossils} }
每个化石详情页还提供该化石单独的BibTeX引用。
配套目录
- emergence-museum: https://github.com/openproblems-labs/emergence-museum — 收录在特定LLM规模下涌现的能力。
搜集汇总
数据集介绍
构建方式
在大规模语言模型(LLM)迅猛发展的浪潮中,许多早期模型中常见的行为模式随着模型规模的扩大而逐渐消失,成为语言模型演化史上的‘活化石’。llm-fossils数据集采用科学标本采集的思路,系统性地收录了这些已消失的行为。其构建方式严谨而规范:每条化石记录均需锁定模型的确切版本(如HuggingFace的提交哈希或封闭API的日期快照),提供触发该行为的精确提示词,并在至少20次独立试验中测量行为的复现率。同时,需在同等提示下对当前前沿模型进行至少5次对比试验,确认行为已消失。每条记录还需明确标出解决该行为的技术方案(如核采样、RLHF等)并提供文献引用,经由策展人亲自复现验证后方可晋升为‘已灭绝’状态。
特点
该数据集独具匠心之处在于其‘活化石’概念——不是记录模型的能力缺陷,而是捕捉那些消失在规模扩张中的具体行为模式,将散落在文献中的‘坊间传说’转化为可测量、可复现的标本卡片。目前收录的15条候选化石横跨7个模型家族,观测时间窗口覆盖2019至2023年,每条记录均配有Colab笔记本供即时复现,并附有具体的解决技术及引用。数据集内置了严格的反篡改机制,包括Zod模式验证、CI管道中的词汇与格式检查,以及策展人必须亲自运行笔记本方可晋升的人工程序,确保了记录的科学严谨性与可信度。数据集的编辑风格刻意保持自然主义式的客观描述,拒绝带有情绪色彩的贬损用语,使每条化石都成为可供论文引用与教学使用的可靠标本。
使用方法
研究人员可通过多种灵活的方式使用llm-fossils数据集。最直接的途径是访问项目网站(llm-fossils.openproblems-labs.org),在画廊视图中按模型家族、解决技术、年代或状态进行筛选浏览,亦可从时间线或按技术分类的视角观察行为模式的演化脉络。对于想深入验证的用户,每条化石记录都配备了独立的Colab笔记本,只需一键点击即可在云端运行完整的复现流程,亲自观测行为是否重现。开发者也可通过克隆仓库本地运行(Node ≥ 20),使用‘npm run new-fossil’命令快速创建新化石的骨架文件,填写参数并运行笔记本后,通过内置的验证脚本(npm run validate-fossils)自动检查格式合规性,完成提交前的质量把关。数据按CC-BY-4.0许可发布,代码采用MIT许可,便于学术界广泛使用与引用。
背景与挑战
背景概述
llm-fossils数据集由openproblems-labs团队于2026年创建,核心研究人员包括Betty Guo等,旨在系统化记录大语言模型(LLM)在规模扩展过程中消失的行为。该数据集受古生物学启发,将LLM发展史中因模型规模增大而消失的特定行为(如GPT-2的贪婪重复循环、SolidGoldMagikarp标记异常等)转化为可复现、可测量的标本卡片。每个标本包含固定模型快照、精确提示词、重复实验的触发率以及对应的解决技术。该数据集填补了LLM行为演化研究的空白,将零散研究转变为结构化的、可引用的资源,为模型能力演变的理解提供了严谨的实证基础。
当前挑战
该数据集的构建面临多重挑战。首先,需要为每个化石标本精确固定模型版本,包括HuggingFace提交哈希或封闭API的日期快照,而非模糊的版本标签。其次,针对每个行为需设计精确的提示词并保持空白字符一致,同时要在至少20次试验中记录触发率,这在计算成本上是个挑战。此外,每个化石必须与能复现该行为的前沿模型进行对比,确保行为确已消失,并在不低于5次试验中验证。最后,需要明确命名解决该行为的技术或规模变化,并提供学术引用,这对回溯历史文献和实验复现提出了严格的要求。
常用场景
经典使用场景
在大规模语言模型(LLM)迅猛迭代的背景下,llm-fossils 数据集开创性地将古生物学中的“化石”概念引入自然语言处理领域,用于系统记录那些随着模型规模扩大而消失的行为。其最经典的使用场景是作为一份可复现、可查询的“行为灭绝”目录:研究者可以针对某一具体模型快照(如 GPT-2 small)与精确提示词,通过预设的 Colab notebook 重现该行为,并以至少 20 次试验的测量再现率作为客观证据,从而将模糊的社区传闻转化为可量化、可引用的科学标本。
衍生相关工作
llm-fossils 数据集的设计理念已催生了一系列富有启发性的衍生工作。其直接姊妹项目“emergence-museum”(涌现博物馆)以相同方法论逆向追踪那些随模型规模扩大而“涌现”的新能力,两者共同构建了 LLM 行为演化的完整图景。此外,该目录严格的标本学框架——包括固定的模型快照、≥20 次试验的测量标准、反伪造持续集成机制——为其他领域(如多模态模型、代码生成模型)建立类似的行为退化目录提供了可复制的范本。其通过 RSS 订阅追踪状态变更、季度策展验证的运营模式,也正在被多个社区工具链借鉴,以解决模型评估长期存在的“木乃伊化”问题。
数据集最近研究
最新研究方向
在大规模语言模型迅猛发展的浪潮中,一个引人深思的现象逐渐浮出水面:随着模型规模的急剧膨胀,某些曾经稳定涌现的行为模式竟如古生物般悄然灭绝。llm-fossils项目正是响应这一前沿观察,开创性地以古生物学范式系统编录了15种已从当代前沿模型中消失的语言行为,涵盖GPT-2至GPT-3.5等多个模型世系。该数据集不仅精确锁定了每个行为消失的模型快照与触发条件,更通过严格的复现机制(每项行为经20次以上测试)命名了导致其消亡的关键技术突破,如核采样、指令微调与长上下文训练。这一工作将零散的社区轶事转化为可量化、可引证的学术标本,为理解规模定律下的能力相变提供了独特的实证框架,标志着LLM行为研究从定性叙事迈入可重复测量的科学阶段。
以上内容由遇见数据集搜集并总结生成


