low-quality-multilingual-sentences
收藏资源简介:
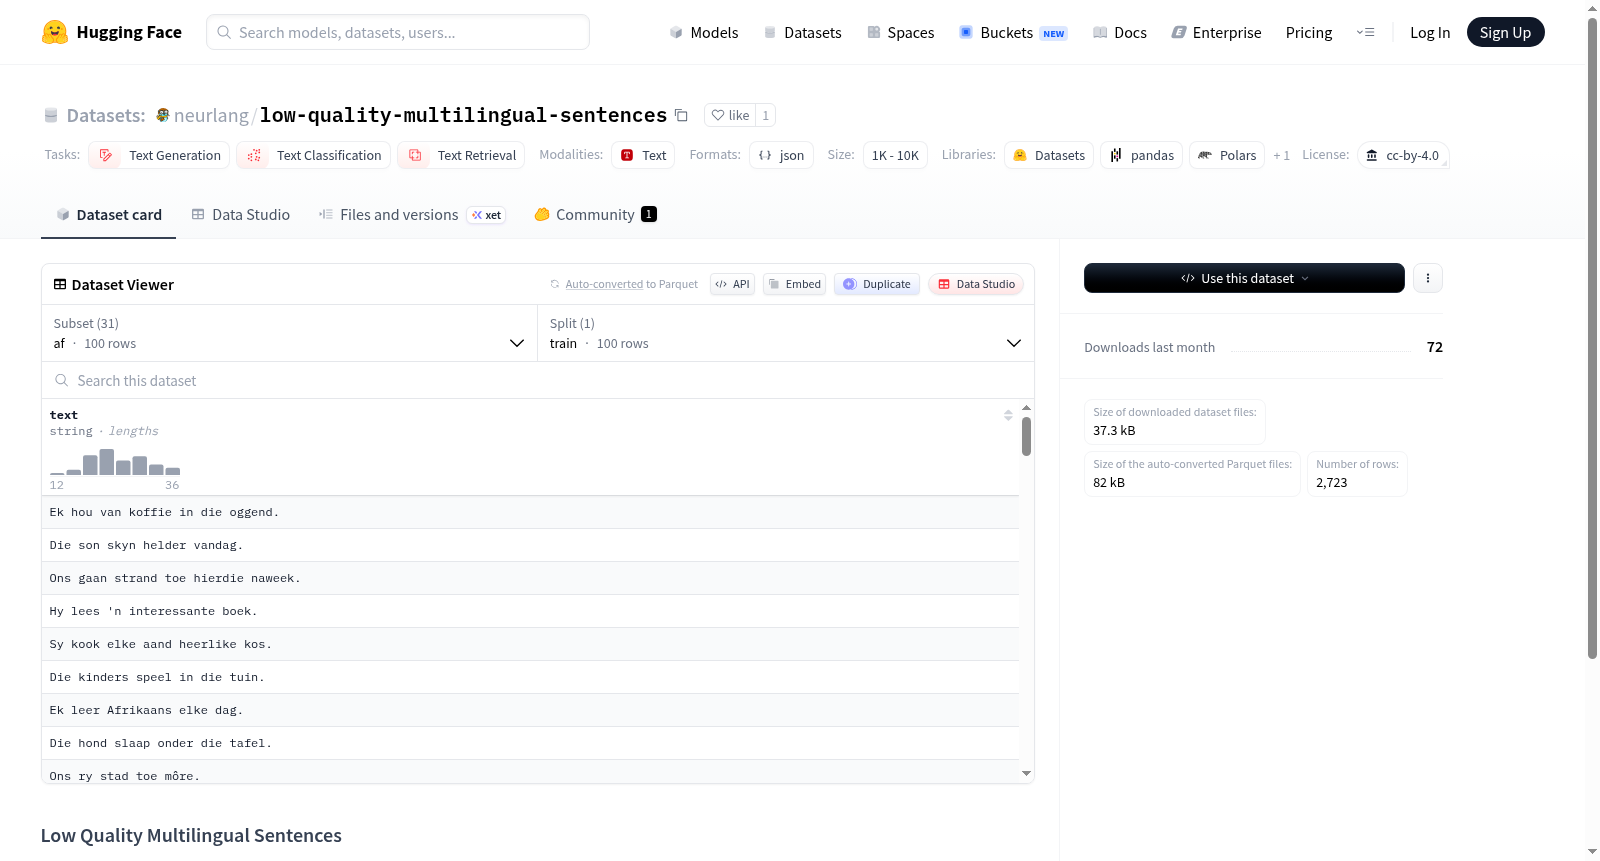
该数据集是'agentlans/high-quality-multilingual-sentences'的补充,扩展了更多语言的支持。数据集中的新句子质量较低,使用时需谨慎。数据集包含多种语言(如南非荷兰语、阿姆哈拉语、阿拉贡语等)的文本数据,以JSONL.zst格式存储,所有数据均属于'train'分割。适用于文本生成、文本分类和文本检索任务,数据规模小于1K,采用CC-BY-4.0许可协议。
This dataset is a supplement to 'agentlans/high-quality-multilingual-sentences', which extends support for more languages. The new sentences in this dataset are of relatively low quality, so caution should be exercised when using them. This dataset contains text data in multiple languages (e.g., Afrikaans, Amharic, Aragonese, etc.), stored in JSONL.zst format, and all data belongs to the 'train' split. It is applicable to tasks such as text generation, text classification and text retrieval. The dataset has fewer than 1K samples and is licensed under CC-BY-4.0.
数据集概述
基本信息
- 数据集名称: Low Quality Multilingual Sentences
- 许可证: cc-by-4.0
- 任务类别: 文本生成、文本分类、文本检索
- 数据规模: n<1K
数据集描述
- 本数据集是 agentlans/high-quality-multilingual-sentences 的补充,旨在扩展到更多语言。
- 本数据集中的新句子质量较低,使用时需谨慎。
数据配置与文件
数据集包含多个语言配置,每个配置对应一个训练集文件。文件格式为JSON Lines压缩文件(.jsonl.zst)。
语言配置列表
- af: 训练集文件
af.jsonl.zst - am: 训练集文件
am.jsonl.zst - an: 训练集文件
an.jsonl.zst - as: 训练集文件
as.jsonl.zst - ba: 训练集文件
ba.jsonl.zst - be: 训练集文件
be.jsonl.zst - bpy: 训练集文件
bpy.jsonl.zst - bs: 训练集文件
bs.jsonl.zst - ce: 训练集文件
ce.jsonl.zst - ceb: 训练集文件
ceb.jsonl.zst - chr: 训练集文件
chr.jsonl.zst - cv: 训练集文件
cv.jsonl.zst - dz: 训练集文件
dz.jsonl.zst - eo: 训练集文件
eo.jsonl.zst - eu: 训练集文件
eu.jsonl.zst - gl: 训练集文件
gl.jsonl.zst - gn: 训练集文件
gn.jsonl.zst - gu: 训练集文件
gu.jsonl.zst - ha: 训练集文件
ha.jsonl.zst - haw: 训练集文件
haw.jsonl.zst - he_nikud: 训练集文件
he_nikud.jsonl.zst - hr: 训练集文件
hr.jsonl.zst - ht: 训练集文件
ht.jsonl.zst - ia: 训练集文件
ia.jsonl.zst - io: 训练集文件
io.jsonl.zst - kl: 训练集文件
kl.jsonl.zst - ms_arab: 训练集文件
ms_arab.jsonl.zst - my: 训练集文件
my.jsonl.zst - ny: 训练集文件
ny.jsonl.zst - tts: 训练集文件
tts.jsonl.zst - yue: 训练集文件
yue.jsonl.zst