
遇见数据集

swiss-german-wiki-pairs

收藏
Hugging Face2026-09-02 更新2026-09-03 收录
官方服务:

资源简介:

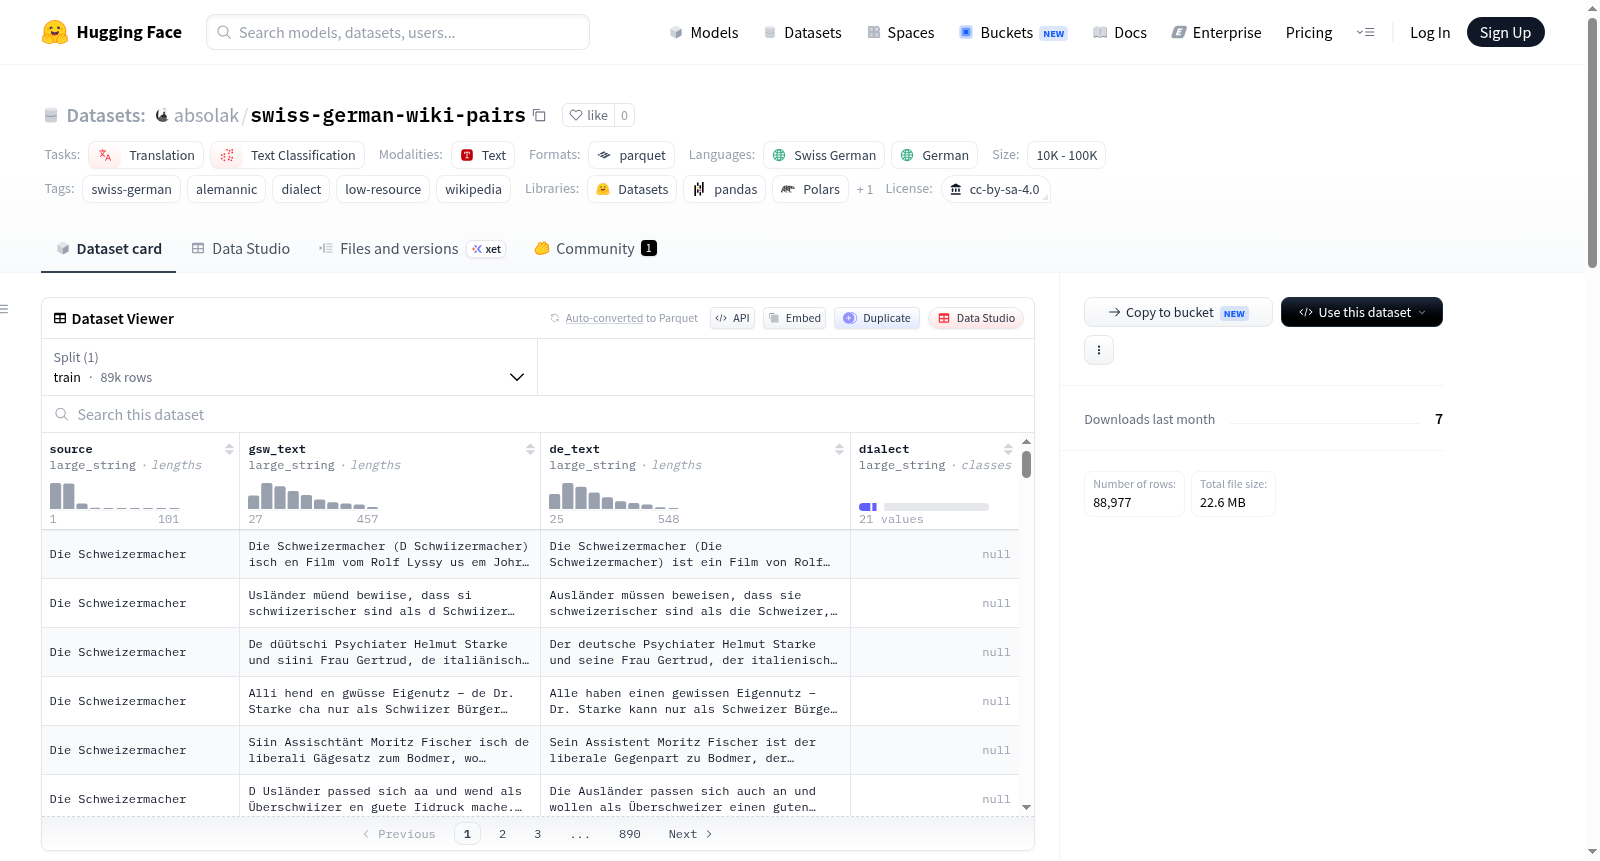
该数据集是瑞士德语与标准德语的平行语料库,包含88,977对翻译样本,源自Alemannic Wikipedia上的10,776篇文章,并经过筛选仅保留瑞士阿勒曼尼语内容。数据集的德语部分(de_text)由DeepSeek v3.2模型机器翻译生成,因此不应用于机器翻译系统的基准测试,但适合作为训练数据。每条记录包含四个字段:source(文章标题)、gsw_text(人类撰写的瑞士德语段落)、de_text(机器翻译的标准德语)、dialect(作者自报的方言,若未声明则为null,覆盖率为19.2%)。方言标签来自维基百科模板,作者自愿添加,未声明不代表非瑞士德语。数据集可用于机器翻译和文本分类等任务,遵循CC BY-SA 4.0许可证。

This dataset is a parallel corpus of Swiss German and Standard German, containing 88,977 translation pairs sourced from 10,776 articles on Alemannic Wikipedia, filtered to retain only Swiss Alemannic content. The German part (de_text) was machine-translated by the DeepSeek v3.2 model, so it should not be used for benchmarking machine translation systems but is suitable as training data. Each record includes four fields: source (article title), gsw_text (human-written Swiss German paragraphs), de_text (machine-translated Standard German), and dialect (author-reported dialect, null if not declared, coverage 19.2%). Dialect tags come from Wikipedia templates, voluntarily added by authors; absence does not imply non-Swiss German. The dataset can be used for tasks such as machine translation and text classification, and is licensed under CC BY-SA 4.0.

创建时间:
2026-08-31
原始信息汇总

数据集概述

Swiss German Wikipedia Parallel Corpus (real gsw, synthetic de) 是一个瑞士德语(gsw)与标准德语(de)的平行语料数据集,包含 88,977 对翻译样本,来源于 10,776 篇 Alemannic 维基百科文章,并经过过滤仅保留瑞士阿勒曼尼方言内容。

核心信息

项目 详情
语言对 gsw-CH(瑞士德语)↔ deu-Latn(标准德语)
数据规模 10K < n < 100K
许可证 CC BY-SA 4.0(继承自维基百科)
类别 翻译、文本分类
创建者 机器生成(德语侧),人工撰写(瑞士德语侧)+ 众包标注(方言标签)
数据格式 Parquet(默认配置)

数据构成

主要字段

列名 描述
source 文章在 als.wikipedia.org 上的标题
gsw_text 人工撰写的瑞士德语段落
de_text 由 DeepSeek v3.2 机器翻译的标准德语
dialect 作者自我报告的方言(19.2% 覆盖率),未标明则为 null

方言标签说明

  • 方言标签来自维基百科的 {{Dialekt}} 模板,由作者自愿添加。
  • null 仅表示作者未声明方言,不意味着 该行不属于瑞士德语。

瑞士德语文本的分类方法

  1. 作者声明标签:移除明确声明为阿尔萨斯语、施瓦本语、福拉尔贝格语等非瑞士方言的文章(共 7,352 篇文章携带方言标签)。
  2. 分类器过滤:基于 3,315 篇已标记文章训练 fastText 字符 n-gram 模型,逐篇文章分类并传播至其所有行。

使用限制与注意事项

  • de_text 为机器翻译生成,不应作为机器翻译系统评测的参考译文,仅适合作为训练数据。
  • 方言标签为未经审计的自我报告,可能存在误差。

许可证与出处

  • 采用 CC BY-SA 4.0 许可证,衍生作品必须保持相同许可证。
  • 源文本版权归 Alemannic 维基百科贡献者所有,需通过 source 列进行逐行署名,署名链接格式为:https://als.wikipedia.org/wiki/{source}(示例链接为 https://als.wikipedia.org/wiki/某文章标题)。
  • 德语翻译由 DeepSeek v3.2(MIT 许可证)生成,不附加额外使用限制。
搜集汇总
数据集介绍
swiss-german-wiki-pairs 数据集图片
构建方式
此数据集源于阿尔曼尼语维基百科,经过精细的方言筛选流程,剔除非瑞士阿勒曼尼语变体,如阿尔萨斯语、施瓦本语等,最终汇集了来自10,776篇文章的88,977对瑞士德语与标准德语平行句对。构建过程首先依赖作者在文章页面上以模板形式自我声明的方言标签,共计7,352篇;对于未声明的其余文章,则训练了一个基于字符n-gram的fastText分类器,按文章粒度进行预测并将结果传播至所有相关句对。瑞士德语文本为人工撰写的维基百科原文,标准德语则通过DeepSeek v3.2模型机器翻译生成,确保了数据规模的可扩展性。每个样本还附带了可能缺失的方言自我报告信息,丰富了下游语言研究的维度。该数据集遵循CC BY-SA 4.0许可,源于维基百科的开放共享精神,并明确要求衍生作品须保持相同许可协议。
使用方法
数据集设计旨在支撑低资源方言的语言处理研究,典型应用涵盖瑞士德语到标准德语的机器翻译模型训练与跨方言文本生成任务。使用时应将gsw_text作为源语言输入,de_text作为目标语言输出,但需警惕de_text的机器翻译性质,不宜将其作为基准测试的参考译文。研究者可灵活利用dialect列,依据自我报告的分方言划分构造个性化实验,探索方言变体间的语言差异;而null值的存在则允许忽略该标注以扩展训练规模。在数据预处理中,建议依据行级source字段对维基百科文章进行去重或按文章划分数据,以避免相关性泄漏,保证评估的稳健性。由于数据源遵循CC BY-SA 4.0,任何派生数据集或模型输出若直接重发布,均须以相同许可条款共享,同时合规署原始文章链接。该语料亦可进一步扩展为多任务学习,结合文本分类任务训练方言辨识模型。
背景与挑战
背景概述
该数据集由Ahmet Solak于2026年创建,旨在缓解瑞士德语(gsw)这一低资源语言在自然语言处理领域的数据匮乏问题。瑞士德语作为阿勒曼尼语的分支,在维基百科等平台上虽有内容,但缺乏标准德语的高质量平行语料,制约了机器翻译等任务的发展。研究者从阿勒曼尼语维基百科中筛选出瑞士阿勒曼尼语文章,利用DeepSeek v3.2模型将人类撰写的瑞士德语文本翻译为标准德语,构建了包含88,977个平行句对的语料库。该数据集填补了瑞士德语与标准德语平行语料的空白,为低资源方言的机器翻译、跨方言自然语言处理研究提供了宝贵资源,对推动方言技术发展具有重要意义。
当前挑战
数据集面临多重挑战。领域层面,瑞士德语缺乏统一书写标准,存在大量方言变体,且与标准德语差异显著,使得机器翻译需应对形态、句法及词汇的系统性差异。此外,低资源环境导致可用的训练数据有限,模型泛化能力受限。构建过程中,首要挑战是数据清洗与方言识别。维基百科上的阿勒曼尼语文本包含非瑞士方言(如阿尔萨斯语、施瓦本语)以及作者自报的方言标签,需要借助fastText分类器进行筛选,但未标注方言的文本(占比19.2%的null值)增加了不确定性。其次,德语侧文本由机器生成,尽管DeepSeek v3.2模型性能优异,但机器翻译可能引入不自然表达或错误,因此数据集中明确禁止将de_text用作基准参考,以免误导评测。数据集的构建需在数据规模与质量控制间寻求平衡,以维持其可信度与可用性。
常用场景
经典使用场景
在低资源语言处理领域,瑞士德语作为阿勒曼尼方言的重要分支,长期面临平行语料匮乏的困境。该数据集从阿勒曼尼语维基百科中精心筛选出瑞士德语文本,并借助大语言模型生成对应的标准德语译文,构建了包含近九万对句子的双语平行语料。其经典使用场景聚焦于方言到标准语的机器翻译模型训练,尤其适用于序列到序列的神经翻译架构,支持从零开始训练以及预训练语言模型的微调范式。研究者可借助该语料探索方言形态句法特征与标准语之间的系统性对应关系,亦可将其作为跨方言迁移学习的基准资源,推动方言自然语言处理技术的边界拓展。
解决学术问题
该数据集直面低资源方言机器翻译中数据稀缺的核心学术瓶颈,通过融合众包维基百科内容与合成翻译策略,为瑞士德语这一缺乏大规模人工标注资源的语言变体提供了可复用的数据基础。它解决了方言识别与语料过滤的方法论难题,利用作者自报方言标签与字符级分类器的双重策略,有效剔除非瑞士阿勒曼尼方言的干扰,保障了语料纯度。这一设计为方言语料构建提供了可借鉴的范式,促进了低资源场景下翻译模型鲁棒性、方言多样性保持以及数据增强技术的研究,对计算语言学中方言学与机器翻译的交叉领域具有重要推动作用。
实际应用
在实际应用维度,该数据集可直接服务于瑞士地区多语言信息服务系统的构建,推动标准德语与瑞士德语之间的自动翻译工具落地,助力地方政务、旅游导览及文化遗产数字化等场景中的语言无障碍沟通。依托其瑞士德语文本语料,还可训练方言文本分类与方言识别模型,用于社交媒体内容分析及区域语言资源普查。合成的标准德语译文虽不适宜作为评测参考,但作为训练数据能有效扩充翻译引擎的领域覆盖度,支撑方言区用户与标准语使用者之间的实时交流工具开发,为语言技术服务提供商及区域性AI应用赋予更低资源消耗的定制化能力。
数据集最近研究
最新研究方向
该数据集面向低资源语言机器翻译与方言文本处理的前沿探索,聚焦于瑞士德语(gsw)与标准德语(de)之间的跨方言翻译建模。其构建策略以人工撰写的维基百科语料为源,辅以DeepSeek v3.2生成的合成目标文本,规避了低资源场景下平行语料匮乏的瓶颈,为方言到标准语的映射提供了大规模训练资源。研究关注点涵盖方言分类、多方言过滤及自我报告方言标签的噪声处理,推动了多语言模型对德语的方言鲁棒性优化。此外,该语料对阿尔卑斯区域语言多样性保护及数字人文研究具有潜在价值,为跨方言知识迁移与低资源机器翻译的基准评测开辟了新颖路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

