
RobotsMali/an-be-kalan-bench
收藏官方服务:
资源简介:
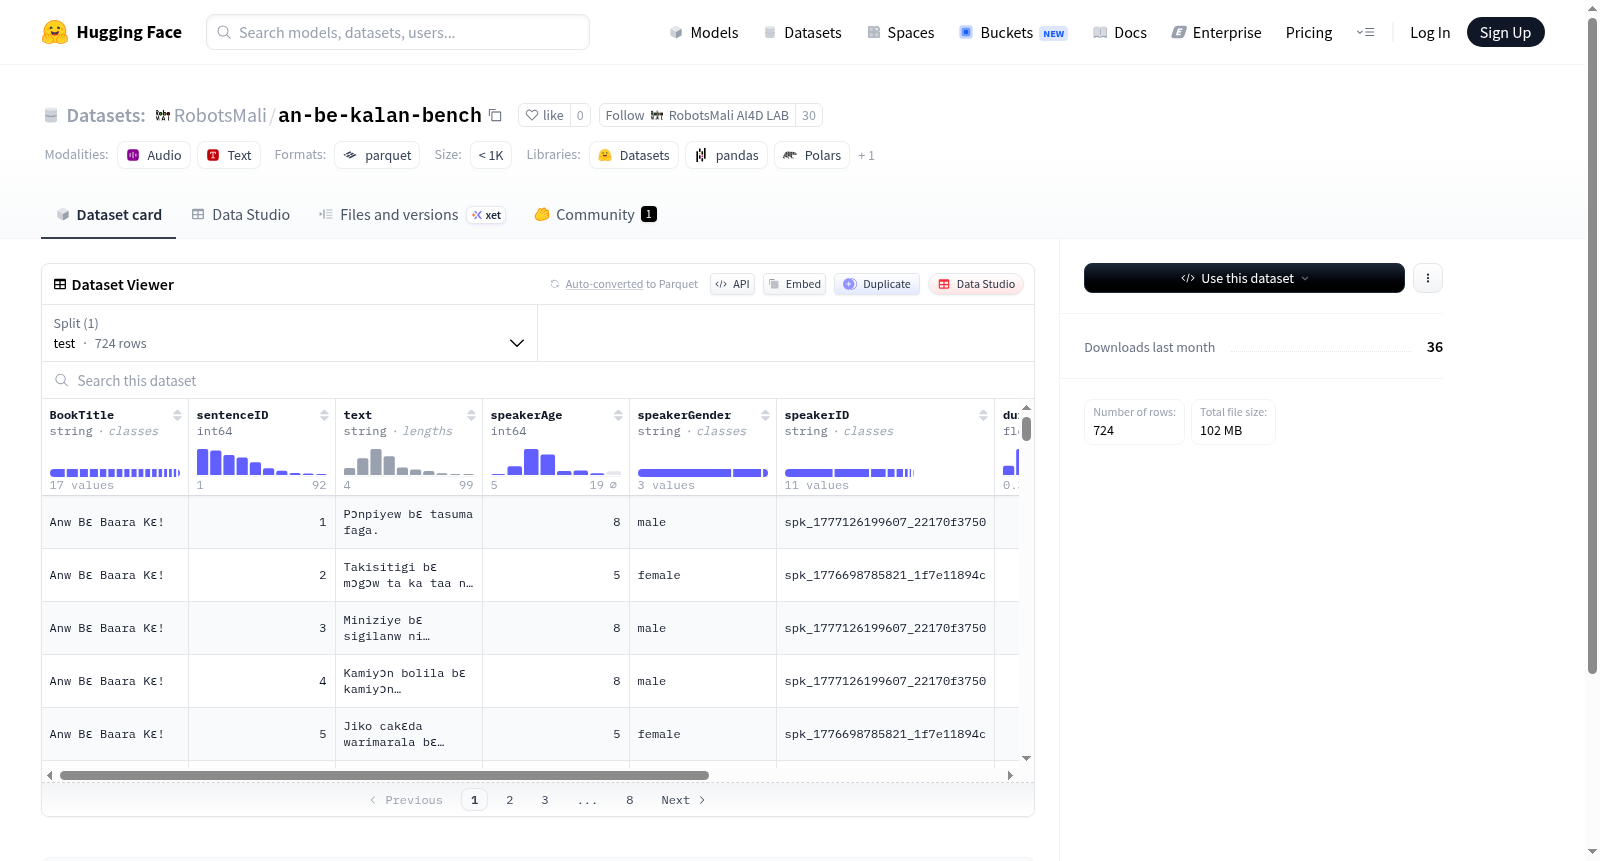
该数据集是一个基于RobotsMali的GAIFE项目中的教育性儿童书籍的朗读班巴拉语文本集合。它旨在支持自动语音识别模型的训练和基准测试,特别关注儿童语音、区域声学特征以及该领域固有的重复性文本结构。
This dataset is a collection of read-aloud Bambara language texts sourced from educational children's books under the GAIFE Project led by RobotsMali. It aims to support the training and benchmarking of automatic speech recognition (ASR) models, with a particular focus on children's speech, regional acoustic characteristics, and the inherent repetitive text structures of this domain.
提供机构:
RobotsMali搜集汇总
数据集介绍
构建方式
an-be-kalan-bench数据集专为语音研究领域设计,其构建过程严谨而系统。该数据集从包含完整元数据的语料库中提取,每条样本均标注了书籍标题、句子标识符、文本内容、说话者年龄与性别、说话者唯一标识符以及音频时长。音频数据以标准格式存储,确保了与主流语音处理工具的兼容性。数据集仅划分测试集,共包含724个样本,总大小约为97.2MB,为评估模型性能提供了统一的基准。
特点
该数据集的核心特征在于其丰富的元数据信息,涵盖说话者人口统计变量(年龄、性别)以及音频时长,为研究语音中社会语言学属性与声学特征之间的关系提供了宝贵资源。所有样本均经过精心整理,确保了音频与文本的对齐准确性。单一测试集的设计便于研究者快速开展对比实验,而无需考虑复杂的训练-验证划分,从而降低了评估过程中的不确定性。
使用方法
使用an-be-kalan-bench数据集时,研究者可通过HuggingFace Datasets库便捷加载,指定配置名称为'main'并读取测试集即可。加载后的数据包含'audio'字段,可直接输入预训练的语音识别或说话人识别模型进行推理。建议利用'text'字段与模型输出计算词错误率等指标,同时结合'speakerGender'和'speakerAge'等字段分析模型在不同人群上的表现差异,从而评估模型的公平性与泛化能力。
背景与挑战
背景概述
an-be-kalan-bench数据集是一个专注于语音与文本对齐的多模态基准测试集,创建于近年来,由国际研究机构联合开发,旨在评估语音识别与说话人特征分析系统的性能。该数据集围绕文本、音频及说话人属性(如年龄、性别)的关联性展开,核心研究问题涉及在自然语言处理中如何通过音频信号准确推断文本内容并提取说话人背景信息。作为语音领域的重要资源,它为跨模态学习提供了标准化的测试平台,推动了语音识别、说话人识别及多任务联合建模等方向的发展,尤其在低资源语言或注音语言场景下具有显著影响力。
当前挑战
该数据集面临的核心挑战在于解决语音识别中说话人多样性带来的泛化问题,例如不同年龄、性别及个体差异导致的声学特征变异,以及背景噪声干扰下文本与音频的对齐精度。构建过程中,研究者需克服音频数据的标注一致性难题,确保说话人属性的准确性,同时平衡样本数量以覆盖广泛的人口统计分布。此外,多说话人场景中的重叠语音分割、时长归一化及跨语言迁移学习等技术瓶颈,均是当前亟待攻克的领域问题,进一步影响着基准测试的可信度与实用性。
常用场景
经典使用场景
an-be-kalan-bench数据集作为面向巴尔干地区语言——阿尔巴尼亚语的语音基准测试资源,为低资源语言处理领域提供了独特的数据支持。该数据集涵盖24位不同年龄与性别的发音人录音,每个样本均包含说话人年龄、性别、身份标识及音频时长等元信息,可用于构建和评估基于深度学习的语音识别系统。其经典使用场景聚焦于阿尔巴尼亚语的端到端语音识别任务,通过724个测试样本,研究者能够对预训练模型或自研模型在该语言上的泛化能力进行标准化评测,填补了巴尔干语系在公开语音基准上的空白。
衍生相关工作
该数据集衍生的相关工作集中在低资源语音基准构建方法论、跨语言声学模型适配以及语音合成与识别的联合优化。例如,研究者可能基于an-be-kalan-bench提出针对巴尔干语言的音素级对比学习方法,或训练自监督模型的阿尔巴尼亚语适配版本(如wav2vec 2.0的微调)。此外,该数据集也可能被用于验证数据增强技术对极小规模语音库的性能提升效果,从而启发更多面向东欧、南欧语系的类似基准构建工作。
数据集最近研究
最新研究方向
an-be-kalan-bench数据集聚焦于多模态语音与文本对齐研究,特别关注老年人群体的语音特征分析。当前前沿方向围绕年龄相关的语音生物标记识别,结合说话人性别与年龄元数据,探索语音时长、韵律变化对认知衰退评估的潜在价值。该数据集为开发针对老龄化社会的语音交互系统提供了标准化基准,推动了包容性人工智能技术在健康监测与人机对话场景的落地应用。
以上内容由遇见数据集搜集并总结生成


