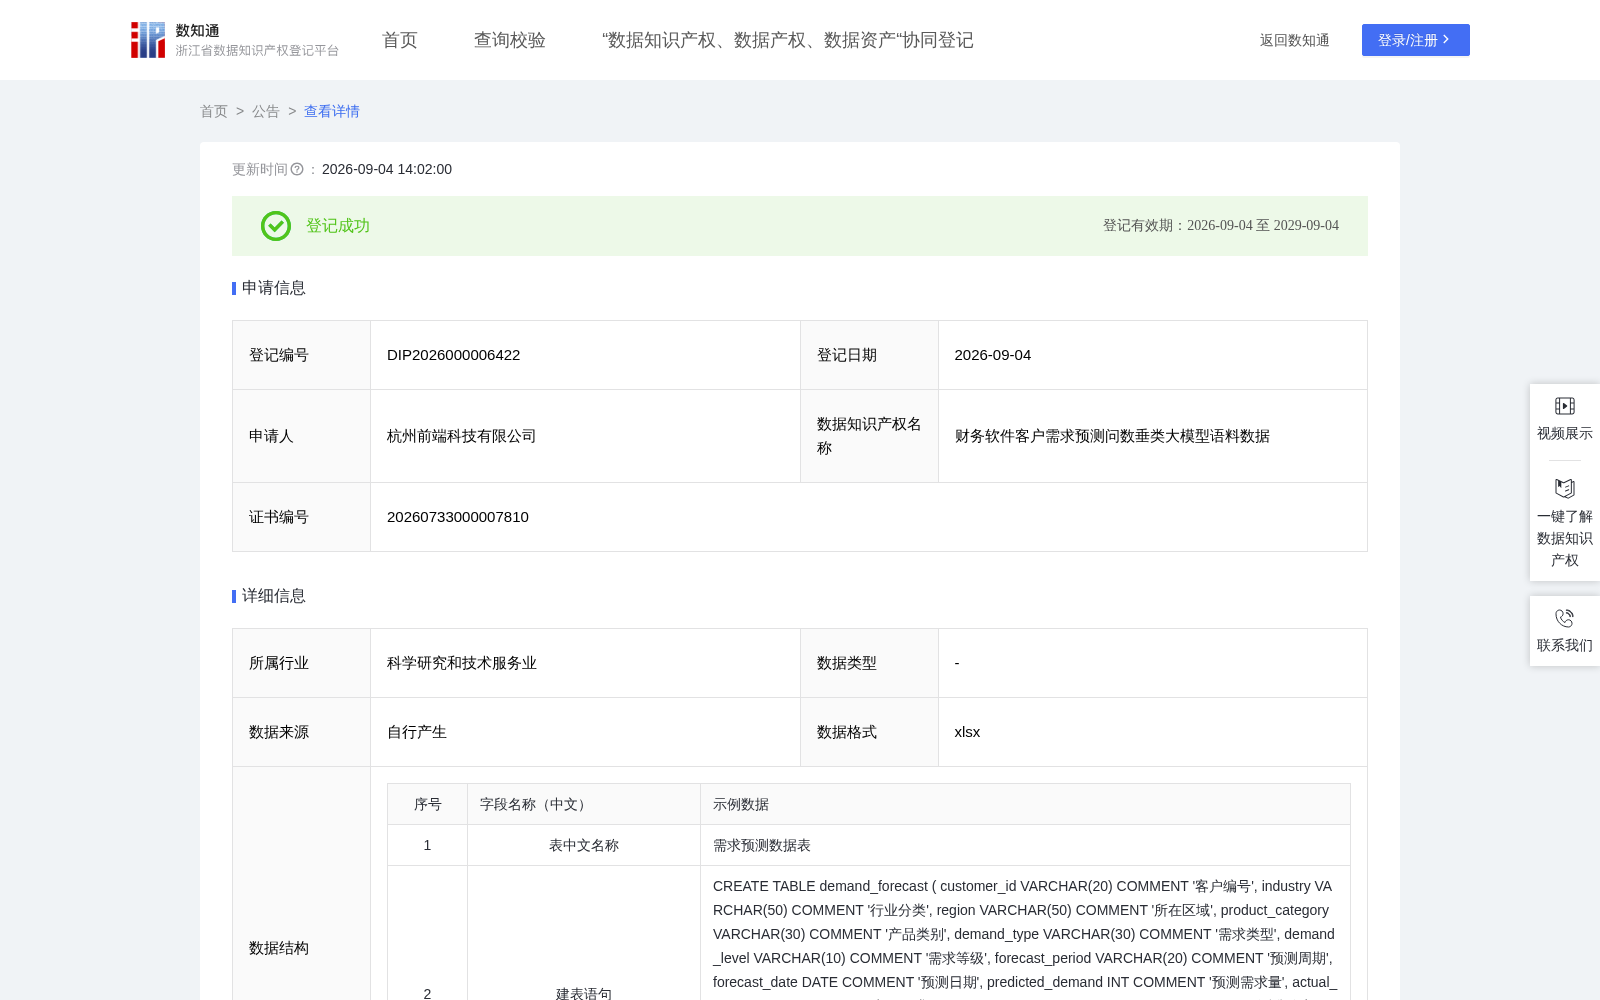
财务软件客户需求预测问数垂类大模型语料数据
收藏资源简介:
本数据来源于公司代理的财务软件在销售过程中的客户需求对接数据,涵盖客户行业分类、所在区域、产品类别、需求类型、需求等级、预测周期、预测日期、预测需求量、实际需求量、预测准确率、需求趋势、季节性指数、市场潜力评分、竞品数量、采购概率、预算范围、客户等级等18个维度结构化数据,经清洗标准化、去标识化处理后构建问数语料库。在加工层面,将自然语言问题与标准SQL查询语句配对,覆盖需求统计、准确率分析、趋势评估、偏差分析、潜力预测等10类查询场景,形成"问题→SQL→结果"三元组语料。当前财务软件代理行业面临需求预测准确率难以保障、预测偏差归因缺乏数据支撑、季节性需求波动难以量化、市场潜力评估依赖人工经验等痛点。同时,该语料集经过标准化标注处理,可为财务软件代理领域BERT-DF客户需求预测语义解析模型提供结构化训练样本,推动行业从"经验判断需求"向"数据驱动预测"演进。1.数据清洗与标准化: 采集财务软件代理业务客户需求预测数据,原始数据涵盖客户编号、行业分类、所在区域、产品类别、需求类型、需求等级、预测周期、预测日期、预测需求量、实际需求量、预测准确率、需求趋势、季节性指数、市场潜力评分、竞品数量、采购概率、预算范围、客户等级共18个字段;按"客户编号+预测周期"去重;通过逻辑校验删除矛盾数据(如预测准确率超100%、实际需求量为0却有偏差);对客户编号哈希脱敏确保不可逆。 2.问题分类与结构化: 围绕客户未来需求的测算与评估,将自然语言问题划分为需求统计、准确率分析、趋势评估、偏差分析、潜力预测等10大查询类型;每类对应标准SQL模板,覆盖COUNT、AVG、SUM、GROUP BY、WHERE多条件、日期区间、比率计算等SQL语法要素,确保问题到SQL映射的确定性。 3.核心算法建模: 本语料面向财务软件代理客户需求预测问数场景,可支撑构建BERT-DF(Demand Forecast)垂类语义解析模型进行问数问答加工;该模型以BERT-base为基座,经Token化与位置编码后输入Transformer编码器,通过Schema Linking机制将产品类别、需求等级等字段与问题实体对齐,解析生成SQL语句,实现"问题→SQL→结果"映射,为领域适配提供训练与评测样本。 4.语料库持续扩充: 依据客户需求预测数据持续积累,通过人工标注补充自然语言问题及其对应标准SQL,形成稳定的"问题→SQL→结果"三元组语料;对同一查询意图生成多种自然语言表达变体,提升覆盖度与泛化性;语料随预测数据更新定期增量扩充,保持时效性与完整性。 5.语料独立性说明: 本语料以客户未来需求预测为主体,核心在"预测需求量与实际需求量"的对照评估,反映模型对"预测-实际"关系的校验能力,与客户价值、续费等以历史经营成果为主的既成记录语料,在数据取向、时间语义、查询对象上存在本质差异。若合并训练,既有记录与前瞻预测混合,会削弱模型对预测偏差与周期对齐的理解,降低各主题SQL生成准确性;分开训练可让模型专注预测评估语义,强化对准确率与偏差率的建模能力,提升解析精度,且各语料可独立扩充、独立评测,避免关联更新牵动全量重训,降低维护成本,符合垂类模型按业务主题分域训练的工程实践。